只靠语言和 token,AI 永远跨不过物理世界这道门槛!
AI 行业的主叙事,曾被 Scaling Law 垄断:更大的模型、更多的 token,更强的文本推理,仿佛只要把语言模型继续堆大,通用人工智能就会自动到来。
但这条路线撞上了天花板:预训练的边际收益肉眼可见地递减;模型一旦部署到真实世界,漏洞百出。
2026 年,“世界模型”接棒 Scaling Law,成了牌桌上最拥挤的筹码。然而,这个词本身,同时被四条技术路线认领,而它们对“理解世界”这件事,几乎各说各话。
第一条赌涌现:Sora、Genie 这类视频生成路线相信,只要下一帧逼得够真,物理规律就会自己从像素里长出来。第二条赌几何:李飞飞联合创立的 World Labs,从底层表征就锁死三维一致性,直接生成可自由探索的虚拟世界。第三条赌仿真:英伟达 Cosmos、Omniverse,把显式物理引擎当作机器人的练兵场。
第四条路最孤峭,也最反常识:2018 年图灵奖得主、深度学习三位“教父”之一 Yann LeCun,押注 JEPA(联合嵌入预测架构),它不生成未来,只在抽象表征的空间里预测未来。
四条路的根本分歧,本质上在于一个问题:机器要“懂”物理世界,究竟该去复刻它,还是去推理它?
前三条都在不同程度上试图让机器“看见并重建”世界;JEPA 却选择另一条路——编码器先丢掉那些根本不可预测的细节,只保留可预测、可规划的结构,然后在抽象表征空间里预测未来。
在 LeCun 眼里,连“预测像素”这件事本身都是伪命题:你把摄像头对准房间一角开始录像,下一帧会拍到什么,取决于镜头外有没有人走进来、光线会不会变化。而这些信息,在“当前帧”里根本不存在。
在 ECCV 2026 Keynote 演讲《World Models: Enabling the next AI revolution》中,LeCun 给出的,是一个比“Scaling Law 还能撑多久”更根本的判断:只靠语言和 token 训练,AI 到不了人类水平智能,也跨不过物理世界这道门槛。
在 LeCun 看来,如果我们要通往真正的通用人工智能(AGI),就必须打破对“生成式”的崇拜。
真正的下一章,是让 AI 系统从视频、传感器与交互中,学习并构建世界模型;再用 JEPA 去理解世界,去预测行动后果,去规划出实现目标的动作序列。
在Keynote的最后,LeCun给出了三个与众不同、甚至堪称“暴论”的建议:
1.别再死磕生成式模型了。
2.别再去研究 LLM 了。
3.转向联合嵌入,转向抽象表征,转向世界模型。
可以说,这次演讲,本质上是对“智能是什么、AI 该往哪走”的一次路线重估。
而台下的听众,比谁都更该听懂这句话。作为计算机视觉的研究者,他们最清楚:真实世界远比语言更脏、更连续、更高维。LeCun 要讲的,正是如何让 AI 真正“看懂”并“应对”它。
以下是 Yann LeCun 在 ECCV 2026 大会发表的 Keynote 演讲,AI 科技评论基于原英文演讲内容进行了不改变原意的编辑。
我们离 AGI ,还差得远
感谢大家的到来。确实如主持人所说,我是一位天文摄影爱好者,一有时间就会拍摄星空,我的演讲封面就是我的 51 和 42号作品。但我今天不是来讲天文的,我是来聊世界模型的。
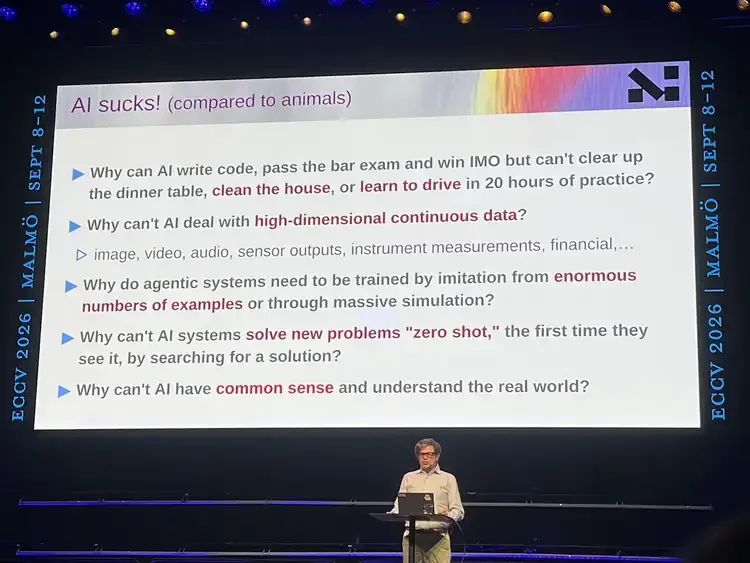
我想开门见山地说一句:我们远没有走到 AI 的终点,甚至远没有走到计算机视觉的终点——否则你们也不会坐在这里。我们远远没有搞定 AI。
如果你去听硅谷里最乐观、也最悲观的那批人的说法,好像“我们已经实现 AGI 了”,但不管他们嘴里的 AGI 到底是什么,我今天的演讲,就是要告诉你们:并非如此。一句话总结我的态度:当下的人工智能,还差得远(AI sucks)。
当我们把 AI 系统的能力、尤其是它的学习效率,跟动物和人类的学习能力放在一起比,差距大到根本不在一个量级。
AI 确实能写代码、做数学、通过律师考试、赢得数学奥林匹克。但一个能在家里干活的通用机器人样板,到底长什么样?一辆真正的 L5 级全自动驾驶汽车,又在哪里?
在理解物理世界这件事上,AI 系统比起生物界,仍然落后得不是一星半点。这一点不用我多解释,你们都是计算机视觉的研究者,最清楚真实世界有多“脏”,它比语言要混乱得多。
这就引出一连串尖锐的问题:为什么今天人们口中的“AI”,也就是那些大语言模型聊天机器人,处理不了图像、视频、传感器读数这类高维、连续、充满噪声的数据?为什么今天一谈到“智能体系统”,训练它们的唯一办法还是靠海量数据做模仿学习?
然而,这种训练方法需要的数据量惊人,而且只对能收集得到数据的那个特定任务有效。对比而言,动物和人类学习新任务,根本不需要那么多数据:我们面对全新情况时,可以零样本(0-shot)、动用脑子去“吃透”这个问题,而不必事先受训、专门练习怎么解决它。
这种能力从何而来?也许来自我们常说的常识。
AI 系统确实有一种非常基础的常识,但和我们在人类乃至普通动物身上看到的那种常识,完全不是一回事。
一只普通的家猫,能做出出乎意料的动作。比如借着墙和家具的反弹力,跳到很高的柜子顶上,非常聪明。我们现在能造出拥有这种身体能力的机器人,却没法让它们“聪明”到足以自主完成这些事。一个十岁的孩子,即便第一次被人要求收拾餐桌、用洗碗机,几乎不用怎么学就能无师自通。可我们至今还造不出这样的 AI。
再举一个更硬核的例子:一个 17 岁的少年,大概用 20 个小时的实际练习就能学会开车,并且在练习时基本不会撞车;而我们手里其实有来自行车记录仪、各类传感器的数十亿小时数据,以及人类专家司机对应的操作指令。我们想用模仿学习和端到端方法,让 AI 学会自己开车。
结果呢?我们至今造不出 L5 水平的自动驾驶汽车。那些接近 L4 水平的车,靠的并不是海量数据的模仿学习,而是内置了大量工程化设计,比如显式建好的世界模型。当然也有人在推端到端学习,比如 Wayve 那几家公司,但我们还没到那一步。
这就让我们一再撞上一个悖论——莫拉维克悖论(Moravec's Paradox,1988),说的是:计算机能算复杂的积分、找路径、下棋,可连动物都能做的简单事,它却搞不定。这逼着我们去追问:智能到底是什么?
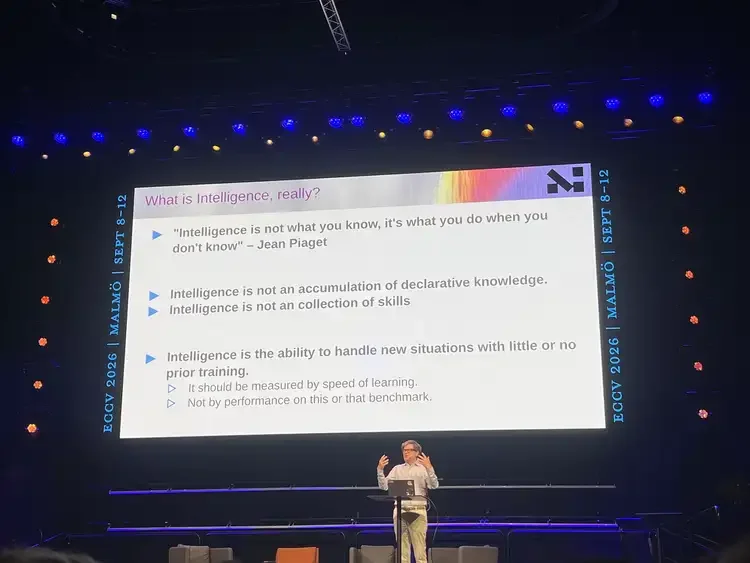
我很喜欢一句常被安在约翰·凯奇名下的话——其实不是他本人说的,而是他的追随者把他的思想浓缩成的一句话:“智能不是你知道什么,而是当你遇到一个没见过的新处境时,你做了什么。”
换句话说,就是:面对一个任务,你用头脑把它解决了,这才是智能。如果你是预先训练好才完成它的,那你只是在套用配方,那不是智能,只是陈述性知识和技能的堆积。
今天社区里、乃至整个社会,常把“陈述性知识和单项技能的堆积”误当成智能。真正的智能,是面对新问题时发明新技能、解决新问题的能力——这既定义了人类行为,也定义了非人类动物的行为。
所以,衡量智能应该看两件事:第一,学一个新任务有多快。需要试多少次才能成功,甚至可能一次都不用试,直接就会,这就是零样本学习;第二,能快速学会的任务范围有多广。
人类的特征,正是适应力极强、学得快,能迅速应对新处境。
智能的本质:人类自身都不“通用”,
AI 也不该追求“通用”
那么人类和动物到底是怎么学的?学习的基础是什么?发展心理学家曾把婴儿的发育过程整理成图表,标出他们在出生后第几个月,开始掌握关于物理世界的基本概念。语言能力和社会交往能力,也有类似的发育时间表。
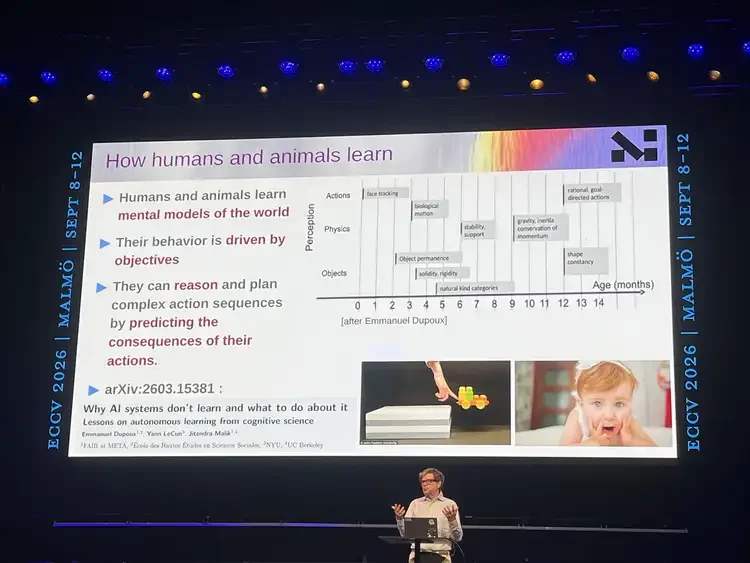
比如面孔追踪,几乎从零个月就开始了——婴儿会被运动和面孔吸引,几分钟内就能识别脸;又比如他们学会区分“有生命”和“无生命”物体,发生在头三到四个月;意识到客体恒存(东西被挡住也依然存在),也发生在早期几个月。随后,他们会开始拥有“稳定性”、“支撑”等概念。
但“每个不受支撑的物体都会下落”这种重力概念,则要花更长的时间(大约九个月),他们才能理解;而惯性,也就是我们说的直觉物理,他们需要学得更久。
这些是怎么学会的?很大一部分靠观察。有些研究运动控制的心理学家坚称,婴儿无时无刻不在“互动”。但话说回来,三个月大之前的婴儿几乎没法影响世界:他们只会比划,很难抓东西。那么,前面三个月里发生的,到底是什么类型的学习?
我和社区里一位同行合写过一篇论文,核心论点是:世界是混乱的,所以,如果“智能”指的是快速学会新任务的能力,那么“通用智能”这个概念根本不成立。
我们人类,自身都没有办法做到“通用”。
人类智能极度专门化——在所有可被数学枚举的问题里,人类能解的只是极小一部分;就说日常的视觉任务,在所有可能的视觉任务中,人类也只能做极小的一部分。
而且,我们每个人的技能组合都不同,这意味着我们在各自领域都是“专才”。就算从人类内部来看,我们也不是通用的。我能学着吹萨克斯、弹电钢琴,但无法成为 McCoy Tyner 那样的爵士钢琴大师。
每个人都能学一些东西,但没人能样样精通。
所以我们必须接受:AI 的本质不是什么都懂,而是能快速学习、快速适应新任务。
当然,我是做机器学习的,这么说可能显得有点“职业病”,但事实就是如此。
对应的问题便是:AI 靠什么原理学习,又需要什么数据?这话对你们来说其实不新鲜——你们都是做计算机视觉的,本来就明白:
光靠文本训练,不管模型在数学和编程上考多高的分,都不可能达到人类水平智能。
我把这笔账算得更具体一点。
先看大语言模型的预训练数据。一个典型的大语言模型,如果把互联网上所有公开文本都拿来训练,大约是 20 万亿个词,换算成 token 大约是 30 万亿个。每个 token 大约占两到三个字节,乘下来,总量大约是 10¹⁴ 字节。这个数字是什么概念?如果让一个人把这些文本全部读完,大约要花 40 万年。
再看一个人类小孩。我们的视网膜分辨率很高,大约有六千万到一亿个感光细胞,但信号在传给大脑之前会被压缩:每只眼睛大约通过 100 万根视神经纤维输出,两只眼睛加起来约 200 万根。每根纤维大约每秒传输 1 字节。一个四岁孩子,在生命头四年里累计清醒的时间大约是 6 万小时。把这两个数乘起来:200 万根纤维 × 每秒 1 字节 × 6 万小时,得到的信息量大约也是 10¹⁴ 字节。
也就是说,一个四岁孩子通过视觉和触觉,所接收到的数据量,已经和互联网上所有公开文本的总量相当。
所以,AI 只靠文本训练,信息量远远不够,更别说达到人类水平智能。“我们需要视觉”这件事,对你们、对我,都是好消息。
从 token 预测到世界模型:
System 2 缺位与十年布道
接着来看第二个问题:智能系统里应该发生什么样的“推断”?我们能不能造一个系统,让输入数据向前穿过一堆神经网络层,最后只输出一个 token(比如一个离散的词),就当作完成了推断呢?
神经网络正是这么做的:给它喂一段文本,它让文本向前穿过巨大的神经网络,然后输出下一个 token。但这不是智能行为,它本质上只是被动反应;
在生成一个 token 的那一瞬间,网络内部没有任何推理或思考。
大语言模型做了两件事来弥补这一点。
第一,它生成比必要多得多的 token,这叫思维链(Chain of Thought)。通过产生大量 token,它增加了得出答案时的计算量。但如果你只让它回答“是”或“否”,它内部根本没有可以展开的思考机制。
第二,它生成很多不同的 token 序列,再用某种方式挑出其中最好的。只要生成的输出能被验证对错,这招就极其高效。所以它适用于代码和数学:你生成一个证明,可以逐步验证;生成一个程序,可以跑起来看结果。
于是系统能评估自己的输出,再迭代改进自己——这正是大语言模型在数学上那么强的原因。
但只要一碰到真实世界,验证就变得极慢,几乎不可压缩。
机器人领域里,可以用模拟器应用某些情况,比如让机器人走路、跑步,这些简单动作还行得通,但操纵物体就不行了。
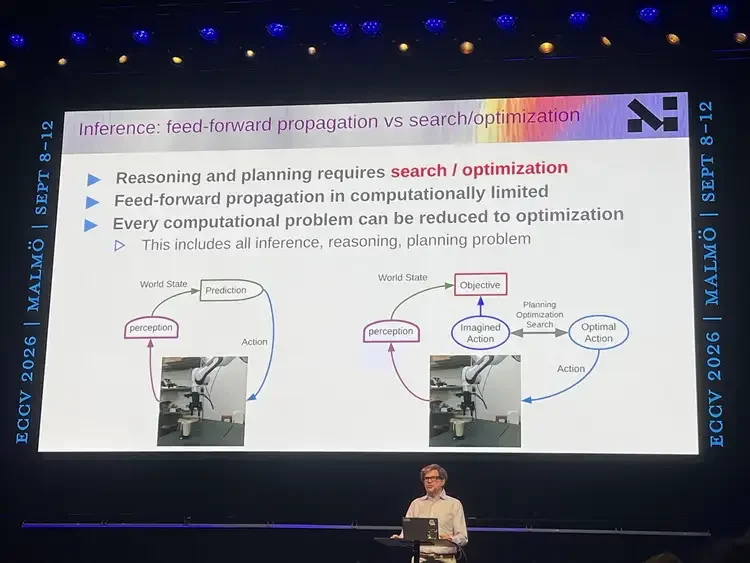
那怎么优化?我的解法是:
更强大的推断模式。
不应该只是让网络前馈计算、直接吐出答案,而应该是:答案不再由网络直接生成,而是被当作输入送进网络,让网络给它打分。
具体说:网络会算出一个标量,衡量“当前这个候选答案,对观察到的输入来说有多好”。这个分数叫能量(Energy)。这个能量函数的输出越小,说明答案越好。然后,系统在外部通过搜索和优化,不断尝试不同的候选答案,让网络给它们打分,最后找出能量最低的那个——也就是最好的答案。
这在概率推断里是经典套路。传统的推断从来都包含某种搜索与优化:不是一步给出答案,而是反复提出候选、评估、再改进。
它天生就比“贪婪地吐一串离散 token”更强大。
而这,就引出了“世界模型”这个概念。
因为,如果系统要搜索出一个对应输入的“好输出”,而这个输出是一个动作,比如机器人的一个动作,或者一串动作序列,那么它就必须能够预测自己动作的后果。这就是世界模型。
世界模型,简单而言就是一个训练好的系统:给定 t 时刻的世界状态,再给定一个你想象中智能体要采取的动作,它就能预测采取这个动作后世界会变成什么样。
接着,你把预测结果喂给一个目标函数,也就是代价函数。它输出一个标量,衡量任务完成得怎么样:任务完成了就是 0,越没完成数值越大。
系统要做的,就是通过优化,搜索出一串能最小化这个代价的动作。
这比大语言模型那种贪心地逐个生成 token 的方式,要强大得多。
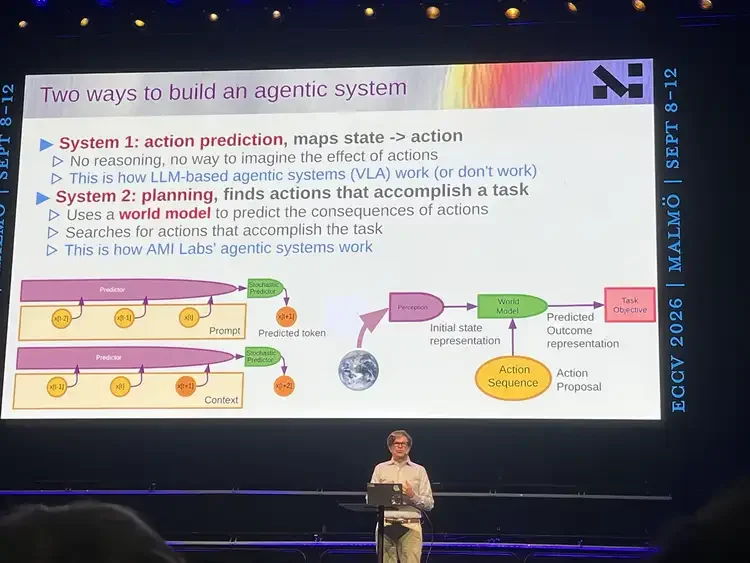
从心理学的角度看,这种“用你心里的世界模型去想象动作的后果,从而规划出达成目标的动作序列”的过程,
正是人类所说的 System 2,也就是你面对新处境、需要动用全部脑力时的决策与行动方式。
相比之下,System 1 是更被动的反应式行动:你清楚该做什么,不需要想。今天的机器人大多属于 System 1;只有那些带运动规划、能预测后果的机器人,才更接近 System 2。
这套思路,我已经倡导了大约十年。2016 年,我在 NIPS(后来更名为 NeurIPS)做主旨演讲时就说过:AI 的未来是世界模型,那才是我们该攻克的下一个前沿。后来我又花了几年,才把这些想法整理成一篇完整的论文,题为《A Path Towards Autonomous Machine Intelligence》(通往自主机器智能之路)。那篇论文是四年前发布的,感兴趣可以去读。我在 YouTube 上也做过几次演讲。
此后,我们朝这个方向,又走了很远的一段路。大约一个月前,我创立了一家公司,名叫Advanced Machine Intelligence(AMI Labs),就是为了真正加速这个方向的进展。
世界模型的建构:
安全护栏与层级化规划
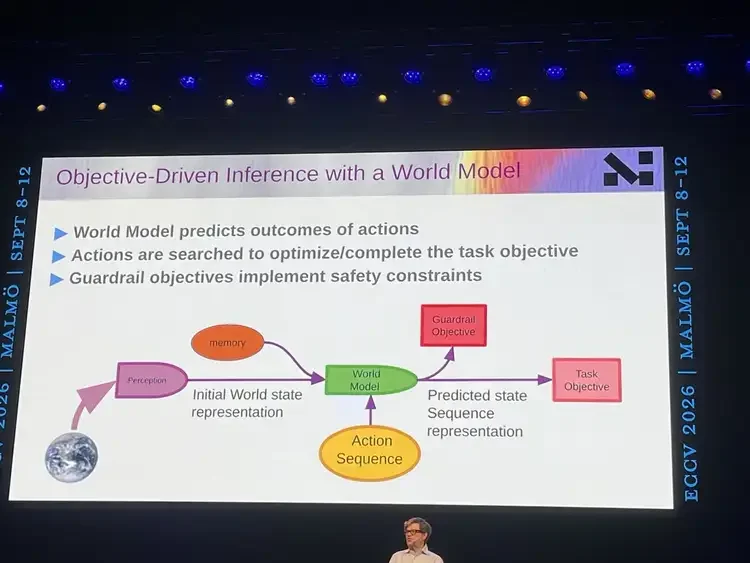
世界模型会预测动作的后果,并搜索能优化目标的动作。这里除了主要目标,通常还需要设置其他目标函数,这些设置可以视作“护栏”(Guardrails)。
这正是所有关注 AI 安全的人会感到欣慰的地方:你可以通过施加这些护栏,把安全硬编码(Hardwire)直接写进系统。
为什么?因为这个架构从设计上,让模型只能完成你给定的任务,而且必须在优化过程中满足“护栏”目标,让它根本没有“越狱”的入口。它不像大模型那样从根本上不可控,只能靠各种“花招”勉强保证安全。那些大模型既不怎么聪明,也没多危险,但它们确实不可控。
而我们这个架构,只要你能把世界模型设计得大致正确,把“护栏”目标设计得能保障安全,它在构造上就是安全的。
当然,它也有难以满足的前提条件,但它是一个可以靠工程努力逐步解决的难题。
有了世界模型,你当然可以拿它做回归式预测:给定(可能很短的)动作或动作序列,它预测未来;你反复这么做,让系统向前预测多步,再做优化、找到好计划、执行第一步、然后重新规划。这叫模型预测控制(Model Predictive Control),在最优控制里是上世纪五六十年代就有的老工具,一点都不新。新的地方只在于:我们这次是拿世界模型来跑它。
但我们最终想创建的(现在还做不到,属于未来工作),是层级化规划(Hierarchical Planning)。
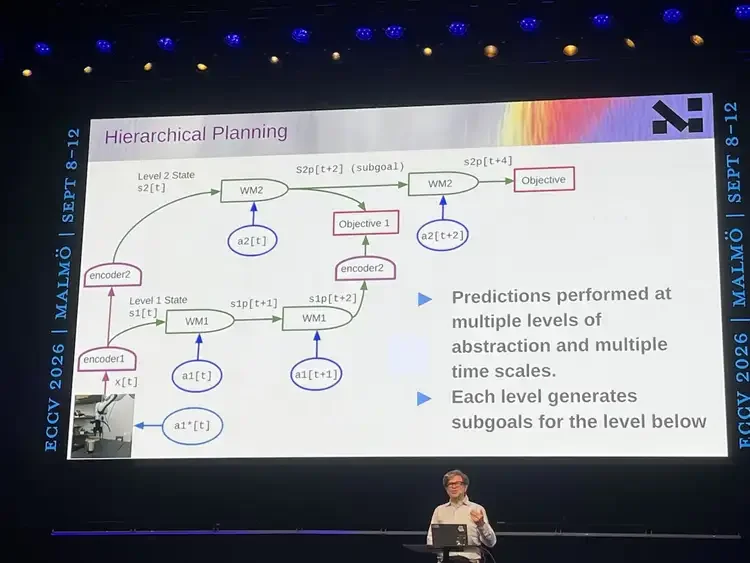
人和动物在规划复杂动作序列时,并不是在“基本动作”层面规划的。对人类来说,基本动作是每 10 到 20 毫秒一次的肌肉控制。
我们是在高得多的抽象层级上规划,再一层层往下细化成低级动作。
举个例子:我现在在纽约的办公室,明天想去巴黎。我不可能用“毫秒对毫秒的肌肉控制”来规划整段旅程。一来太长了,二来我根本没有足够信息做这种规划——我不知道街上会是什么样,也不知道要不要等出租车。
所以我做的是高层计划:去机场,赶飞机。这个计划很抽象,它给我的子目标是“我到机场了吗”,于是代价函数就变成“我离机场还有多远”。下了楼、上了街、打到车之后,怎么开出这条街?那是更下层的子问题。在办公室里,我得去电梯、按按钮、走出大楼,那怎么从椅子上站起来、走到电梯?每一层都需要某种规划。但到了最底层,你掌握了一切所需信息,反而不用再规划了:从椅子上站起来这种事,你做过太多次,想都不用想。
所以,接下来几年 AI 的关键挑战,尤其是在理解和控制真实世界方面,在于层级化规划。而这,需要层级化的世界模型。
JEPA:不预测像素,
在表征空间预测世界
那怎么建世界模型?考虑到生成式 AI 现在这么火,最本能的思路就是采用生成式架构。
举个例子:我有一段视频,把后半段遮住,只把前半段输入系统,训练一个大网络去预测视频后面会发生什么。这跟训练语言模型预测“下一个词”是同一个道理。
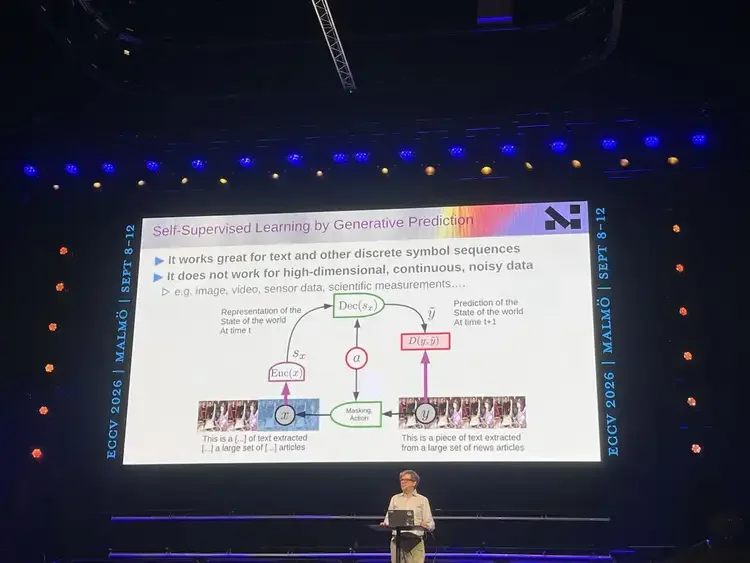
可这个思路我试了快二十年,前十五年基本都在失败,因为我一直执着于用生成式模型、在像素层面做预测。很多人确实在做像素级的视频预测,用来做视频生成。这很酷,也挺好。但如果你想理解世界的底层本质,我认为这个方法很糟糕:模型根本就不该去预测像素。
更让我感觉不舒服的是,现在有人直接把“视频生成模型”叫做“世界模型”,我完全不认同。
为什么不预测像素?因为“预测像素”这个任务根本不可能——不是难,是不可能。
举个例子:我把摄像头对准房间一角开始录像,然后让系统预测接下来视频里会发生什么。可摄像头会一直转,你根本无从预测下一帧长什么样,因为要预测下一帧,所需的信息根本不在当前输入里。
你可能会说:那预测下一个词不也不可能吗?在文本里,我们可以表示“所有可能 token 上的概率分布”,token 数量虽大,却是有限的。
可图像呢?我们不知道如何有效地表示“所有可能图像上的概率分布”。如果你硬要做点预测,系统只会给出所有未来平均值的模糊结果,这就是为什么很多视频预测论文里,预测出来的画面总是糊的、模糊的。加 VAE、隐变量,确实能缓解这个问题,但也只是用来帮助视频生成得更好,模型依旧不理解世界的底层本质,因为它凭空“想象”出一个不存在的未来,预测几乎必然是错的。
我提出的解法,就叫做 JEPA(Joint Embedding Predictive Architecture,联合嵌入预测架构)。
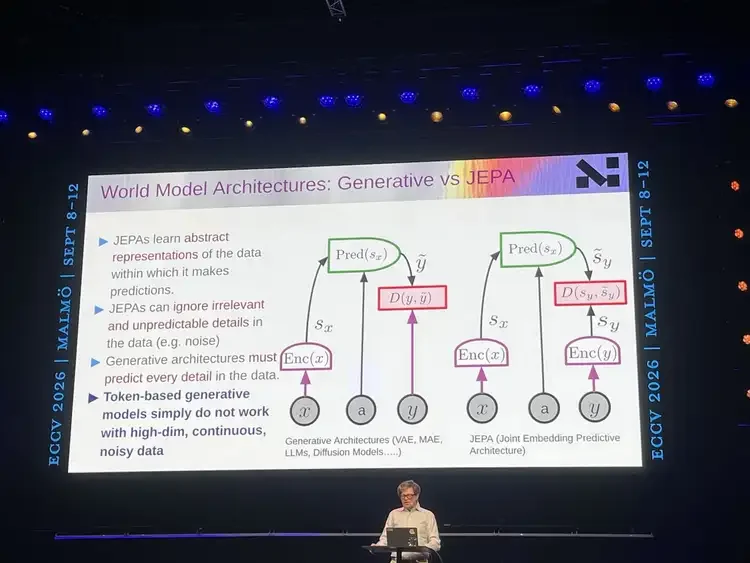
架构如右边所示:它和生成式架构很像。你观察到 X,可能还有动作,要去预测 Y,比如视频后半段。但在 JEPA 里,你把 X 和 Y 都送进编码器,于是预测发生在编码器输出的表征空间里,而不是在像素空间里。
编码器的作用,就是丢掉输入中那些根本不可预测的信息。
举例来说:一辆车在街上开。如果你用像素级预测去训练自动驾驶系统,它就得精确预测树上叶子被风吹动的轨迹、树后水塘的涟漪、以及刚从车后冒出来的行人衣服的褶皱——这太荒唐了。
现实是:模型不仅不需要,也不想去预测这些东西;并且,如果硬要系统去解这种本质上无解的问题,反而会损害它。因此,应当放弃生成式建模,转而训练一个只在表征层面进行预测的系统。
在该表征空间中,不可预测的信息已基本被剔除。你可以把它想成噪声消除,想成一种对“你不在乎、也预测不了的细节”保持不变性(invariant)的表征。
这会让预测问题容易得多,不过,也带来了另一个问题:坍塌(collapse)。
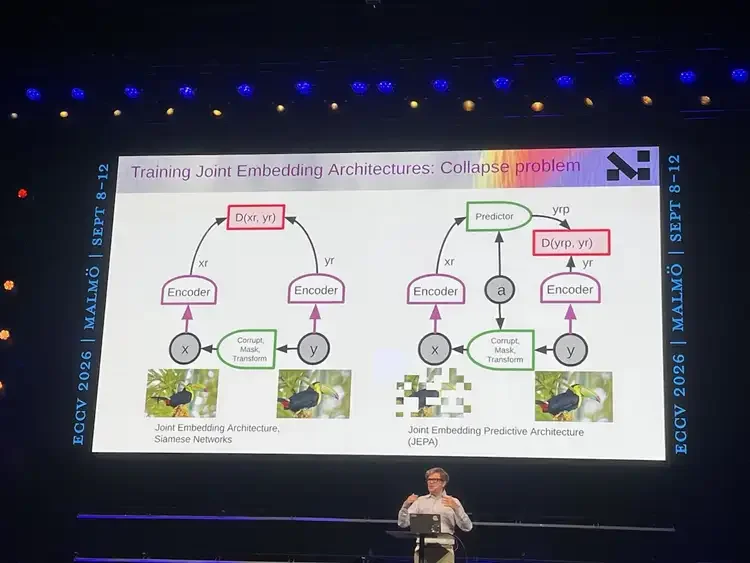
如果我只靠最小化预测误差去训练 JEPA,编码器大可以干脆忽略输入,输出一堆常量表征。
这样一来,预测任务立刻变得毫无难度,但也对我们毫无用处。这就是表征坍塌。生成式方法没有这个问题,因为它被强迫去重建像素,很多人因此偏爱生成式模型。
表征坍塌的解法:
从科学抽象到 SIGReg
不过,我们有防止坍塌的办法,而且思路很多样。关于如何用联合嵌入架构防止坍塌的问题,我 1993 年就有篇关于孪生网络(Siamese networks)的论文;而更早的联合嵌入类架构,Hinton 等人在 80 年代末、90 年代初也都提过。虽然那时的防坍塌方法不够完美,但这个思路本身早就有了,并不是新概念。
我想为 JEPA 辩护一句:模型学习抽象表征来做预测,不是凭空另起炉灶,而是沿用了科学一直在用的方法。
科学的核心就是先观察现象,找出其中真正相关的变量,然后建立一个能够预测我们所观察现象的模型。JEPA 只是把这种科学方法搬到了机器学习里。
原则上,我们当然可以用粒子物理或量子场论来预测这个房间里发生的一切。但那完全不实用:你得模拟房间里的每一个粒子,还得知道方圆几立方公里内的波函数。而且,模拟会瞬间因混沌而发散,根本不可行。
所以,如果我给你一箱空气,告诉你我要把它加热 10 开尔文,你靠理想气体定律(PV=NRT)就能知道压强会涨多少——你完全不需要知道每个分子的位置和速度。
因此,预测的关键,在于识别出相关变量,并忽略掉那些我们视为噪声或熵的东西。
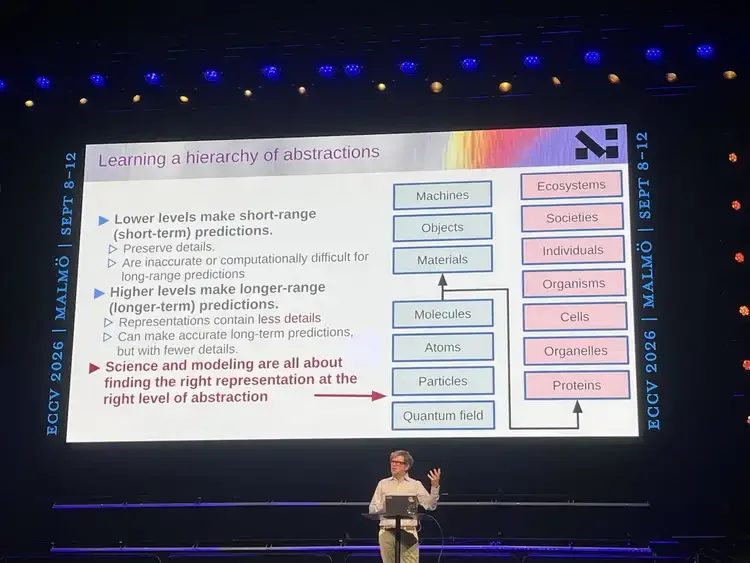
从场论到粒子、原子、分子,再到生物界的蛋白质、细胞、机体、个体、社会、生态系统——这个层级中的每一层,都忽略掉下一层的某些细节,却仍然能够对更大的系统做出更长期的预测。
所以,描述此刻这个房间最贴切的方式,应该是心理学和社会学,而不是神经科学、生物学或场论。你无法把生物学还原成化学,再把化学还原成物理——你可以这么做,但没有用。化学层面有很多概念,底层物理并没有捕捉到。每一层,其实都对应一门独立的科学;而一门科学,恰恰是由“你在观察系统状态时,究竟操控关于状态的哪部分信息”来定义的。
爱因斯坦有句话我很喜欢:“关于世界,最可理解的事情是:世界是可理解的。”
而这很可能正是因为,我们能够建立起那些层级化的表征。JEPA 就是要替我们做这件事。
它不是世界模拟器,不是数字孪生,不是生成模型,更不是视频生成。它只做一件事:
找到一个能够支撑预测的抽象表征。
只要能训练出这种东西,我们就能把它用在任何“现象很复杂、却很难用还原式动力学方程去建模”的场景,比如涡轮机,一个就有上千个传感器;比如化工厂、电厂、病人。
如果有个预测模型能告诉我:“给定病人现在的状态,以及一项治疗干预,t+1 时刻他会是什么状态”,那就太好了。这个想法,其实早在上世纪 50 年代的苏联、60 年代初的西方就有了。
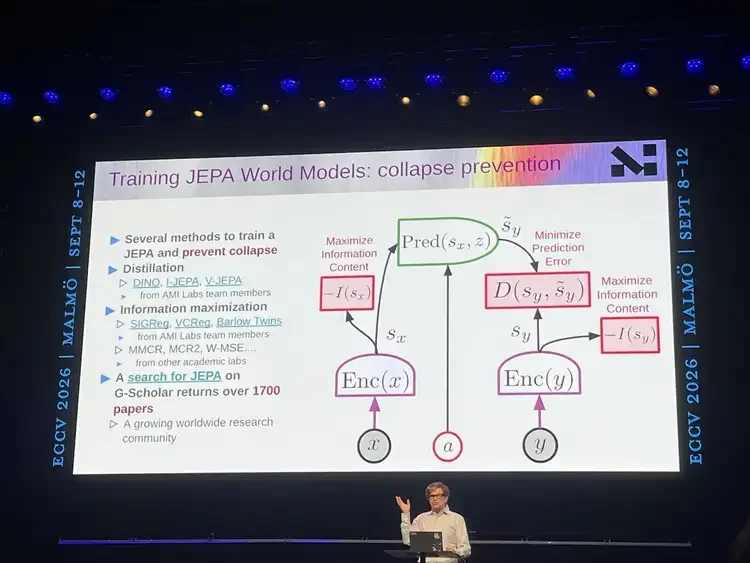
那具体怎么训练?前面说过,要防坍塌。
坍塌的根源,是编码器不从输入里提取相关信息,干脆忽略输入。
所以我们想要一个信息量的度量 I(s_x)。做机器学习要最小化代价,于是代价取 −I(s_x),也就是最大化编码器输出的信息量。同时,系统又要最小化预测误差。于是它必须在两者之间找权衡:尽可能多地从输入中提取信息,但只提取可预测的信息。一句话,这就是 JEPA。
麻烦在于:
怎么度量信息?
要最大化一个量,通常需要它的下界。但信息量的尴尬在于,我们只能近似估计它,而且目前只能得到上界。你可能会说,用互信息来解决。但要算互信息,你必须知道真实的数据分布 P,也就是数据在真实世界里到底是怎么产生的、每个可能取值出现的概率有多大。而这个 P 你根本不知道。你只能通过一堆样本去猜测它、近似它。在高维空间里,比如像素,甚至高维表征,你根本估不出 P(x),也就无法量出信息量。唯一能度量信息的办法,是对 P 做一些假设;而这些假设都会忽略变量之间的某些依赖,于是模型的估计永远是下偏的。我们只能接受这个现实。
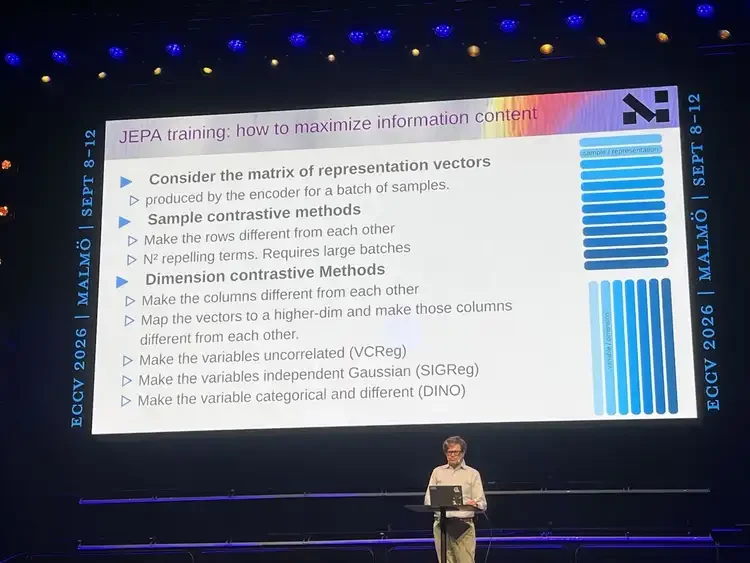
具体做法是:取一个 batch 过编码器,得到表征向量矩阵。每一行是一个样本,每一列是一个变量。
防止坍塌的方法大致分两类:
第一类是样本对比:把矩阵的每一行彼此推远、互相排斥,让矩阵变得“有信息”。但这种方法存在局限,它会产生 N² 个排斥项,因此需要非常大的 batch,而且学不出能填满高维空间的表征,问题不少。
第二类是维度对比:让矩阵的每一列互不相同,这同样能让矩阵有信息、避免坍塌。具体做法是,将向量映射到更高维的空间,再让这些列互不相同。根据约束方式的不同,又可以分为几类:
- 让变量不相关(VICReg),这个方法是我和 Adrien Bardes、Jean Ponce 在几年前发表的。
- 让变量呈独立高斯分布(SIGReg),这是 VICReg 的后续工作。
- 让变量分类且不同(DINO),很多人听过 DINOv2,你可以把它某种程度上看作维度对比或聚类式的方法,效果很好。
我偏好维度对比法,因为它更高效、更稳定,不需要超大 batch。接下来,我会重点讲一下 SIGReg 的做法。
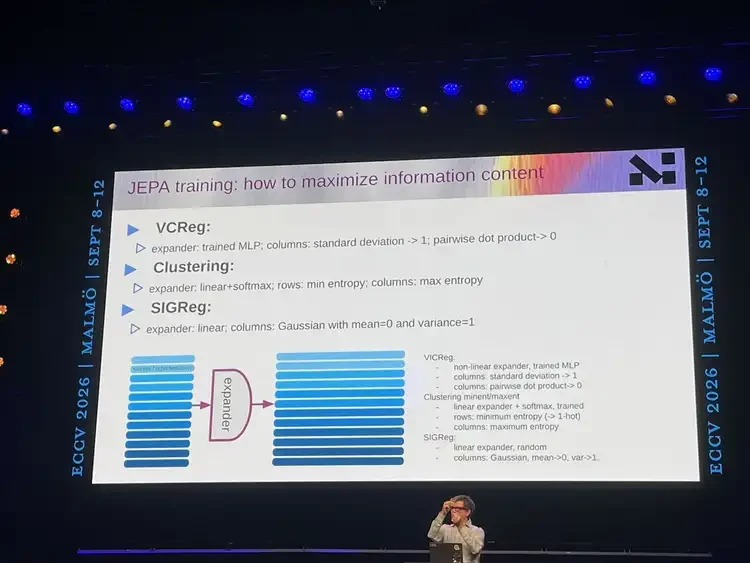
SIGReg 的做法可以分几步来理解。
首先,取编码器输出的表征矩阵:每一行是一个样本,每一列是一个变量。SIGReg 在这个矩阵的行方向做扩展——用简单的线性投影增加更多列,也就是把每个样本向量投影到一个更高维的空间。
然后,它提出一个要求:在这个高维空间里,沿着 batch 看,每一个投影变量(也就是新增加的每一列,它们都是原向量的线性投影)的分布,都应该是零均值、单位方差的高斯分布。
为什么要这样做?因为数据本来可能躺在一个高维流形上。编码器的任务,就是把这个流形“展开”,用有意义的表征来表示它。而 SIGReg 想做的,是用高斯分布去表示这个流形。
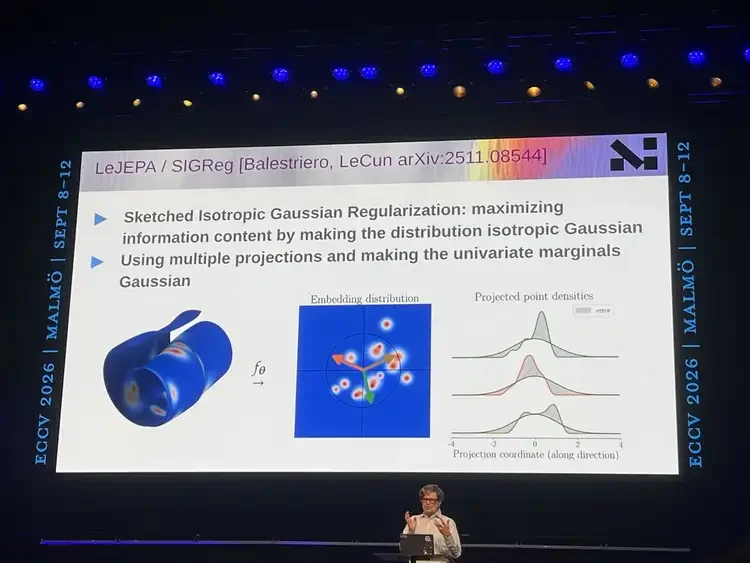
具体怎么实现?把样本沿着若干个方向投影,每个方向都会得到一个边际分布。
对每个方向,让这个边际分布尽量接近高斯。
这很好算:我们可以计算经验累积分布函数(CDF),再和理论高斯的 CDF 进行比较。比较之后,对每个样本,我们都能知道该往哪个方向移动,才能让经验 CDF 更像高斯 CDF。我们还有一些更花哨的做法,比如在四维空间里操作,但核心思想是一样的。
这里有一个理论保证:当所有这些边际分布都变成高斯时,原空间中的联合分布就会趋于独立高斯——而这正是我们想要的、信息量最大的状态。
所以这个思路巧妙的地方在于:从一个任意(可能很扭曲)的分布出发,套用这个准则、挪动点或改网络参数,就能逼近高斯分布。
JEPA 的实证与应用:
从 LeWorldModel 到 V-JEPA
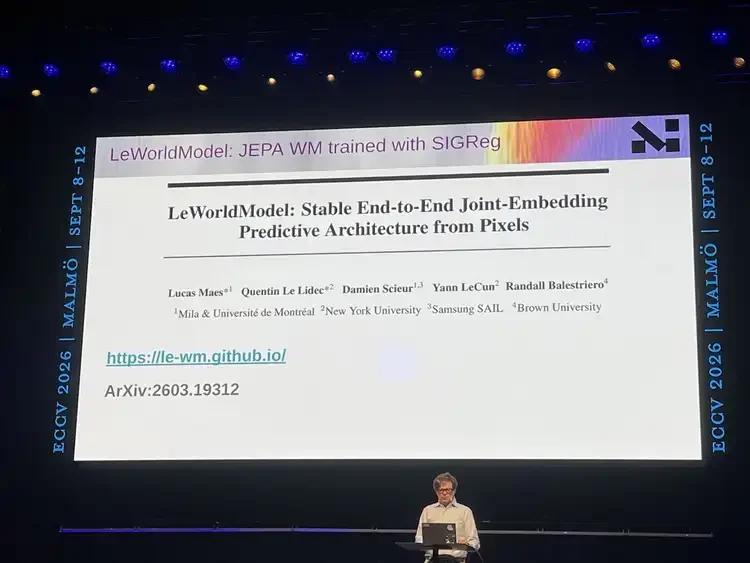
我们可以用这个思想来建世界模型。我们有一篇比较新的论文,叫LeWorldModel,就是沿着这个思路做的,可以用来解决简单的规划问题;我们还在试着把它 scale up。这个方法得到了一个结论是:如果底层真实数据是联合高斯的,而你的相机或传感器观测只是它的高度复杂变换,那么用 SIGReg 条件训练出的编码器,就能恢复出底层的那个高斯。当然,世界不是高斯,底层流形也不是,所以这不是完备解、不是万灵药,但效果已经相当不错。
除了 LeWorldModel,把 JEPA 思想用到各种问题上,如今也是论文井喷。你在 Google Scholar 搜“Joint Embedding Predictive Architecture”,这个词是我几年前起的,大概能搜到约 28 篇。其中很多用了我们预训练出的模型,比如 I-JEPA:它是一种很棒的学图像表征的方法,学视频表征甚至更好。
以色列一家研究所有一篇新论文(他们客气地把我列名,但我零贡献),就用 JEPA 预训练图像表征去做 DXA 图像(双能 X 线吸收法,一种特定类型的 X 光)表示,然后在上面接一个监督头,去预测一堆和密度无关的东西,效果出奇地好,这种做法很简答,但确实挺让人意外。
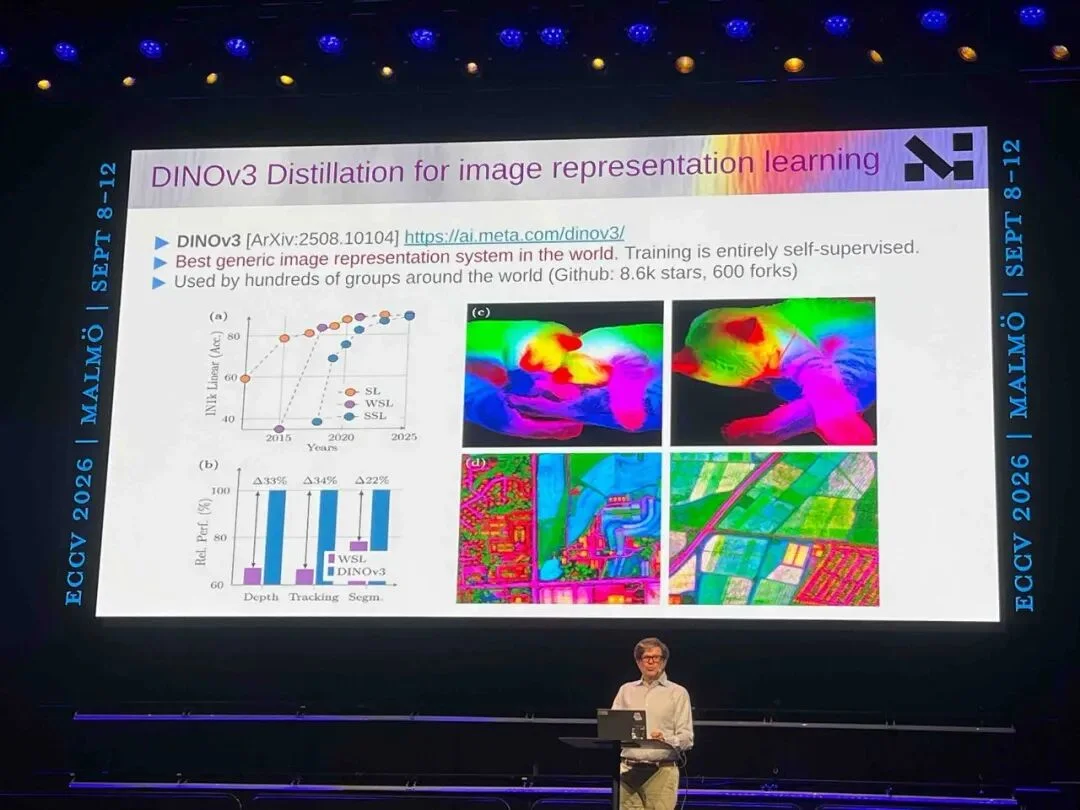
DINOv3 你们很多人听过,可以算 JEPA 的一种(当然里面加了不少让它跑得动的 trick)。而过去这一年半越来越清楚的是:自监督学习最终产出的图像表征,比监督学习、甚至比 CLIP 那种弱监督都更好。现在多数能理解图像的模型靠 CLIP 训练出好用的语义特征,但一旦到了深度估计、分割这类底层任务,自监督的效果,会更强。
我们在生物和医学(X 光等)上也有不少应用,并且也训练了更多模型(用这类分布方法,或信息最大化方法),确实有效。
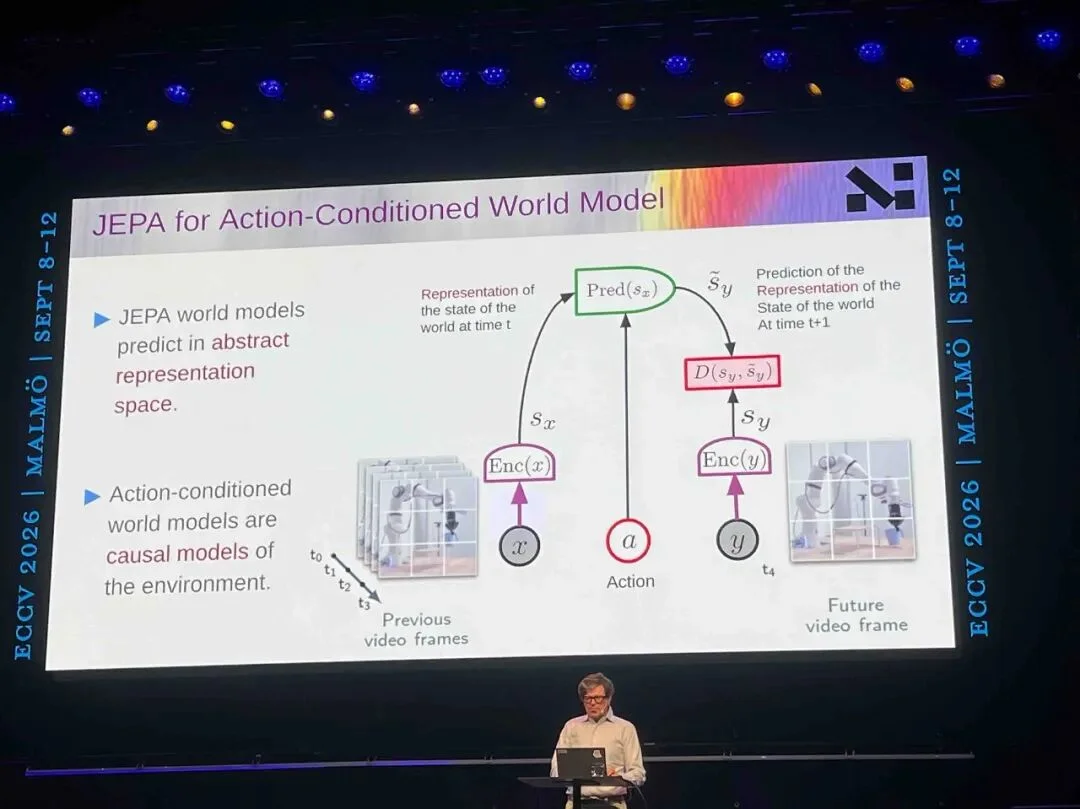
几年前,我联合指导的学生发表的一篇论文,用 JEPA 训练了一个预测器,从左边看到的配置出发,给它顶部的目标,规划出一串动作到达类似目标的状态。这种方法在简单模拟规划里相当好用。
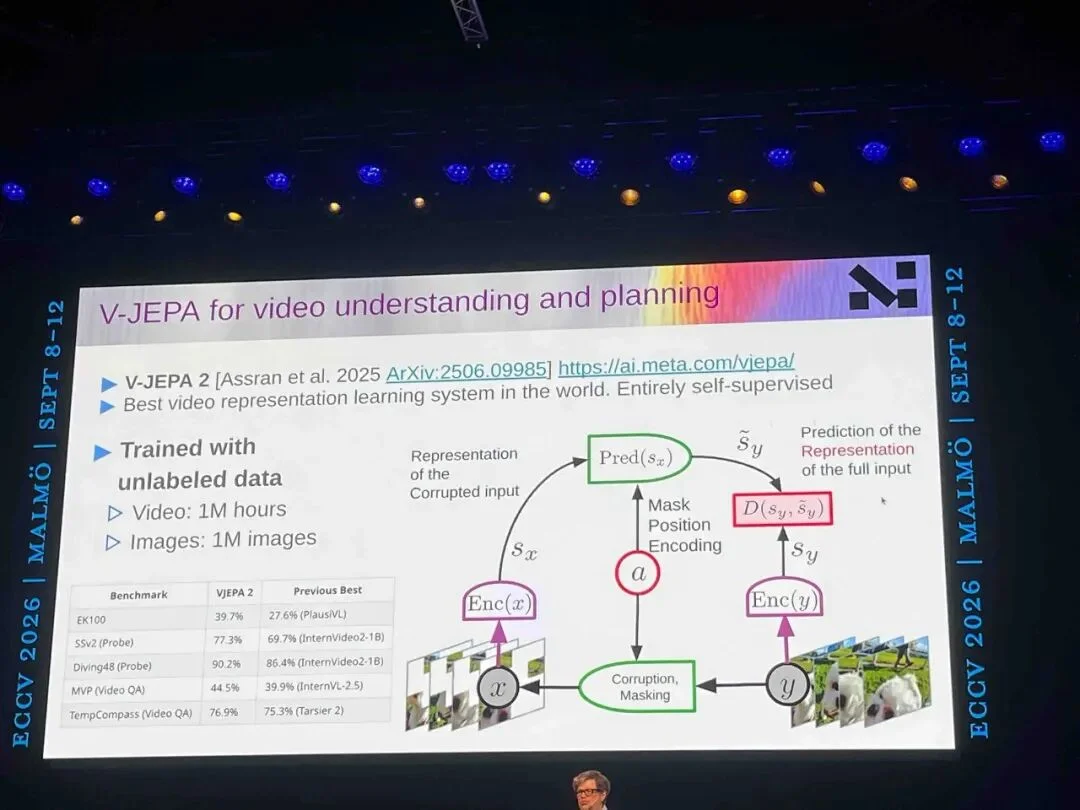
再说到视频 JEPA:V-JEPA 2,以及我们创立 AMI 之前刚刚发布的 V-JEPA 2.1(这项工作的整个团队基本都加入了 AMI)。它的训练方式靠“破坏”:取一段视频,遮住其中一大块连续的时空区域(即一个“时空管”),然后训练系统从部分被遮掩视频的表征,重建完整视频的表征。
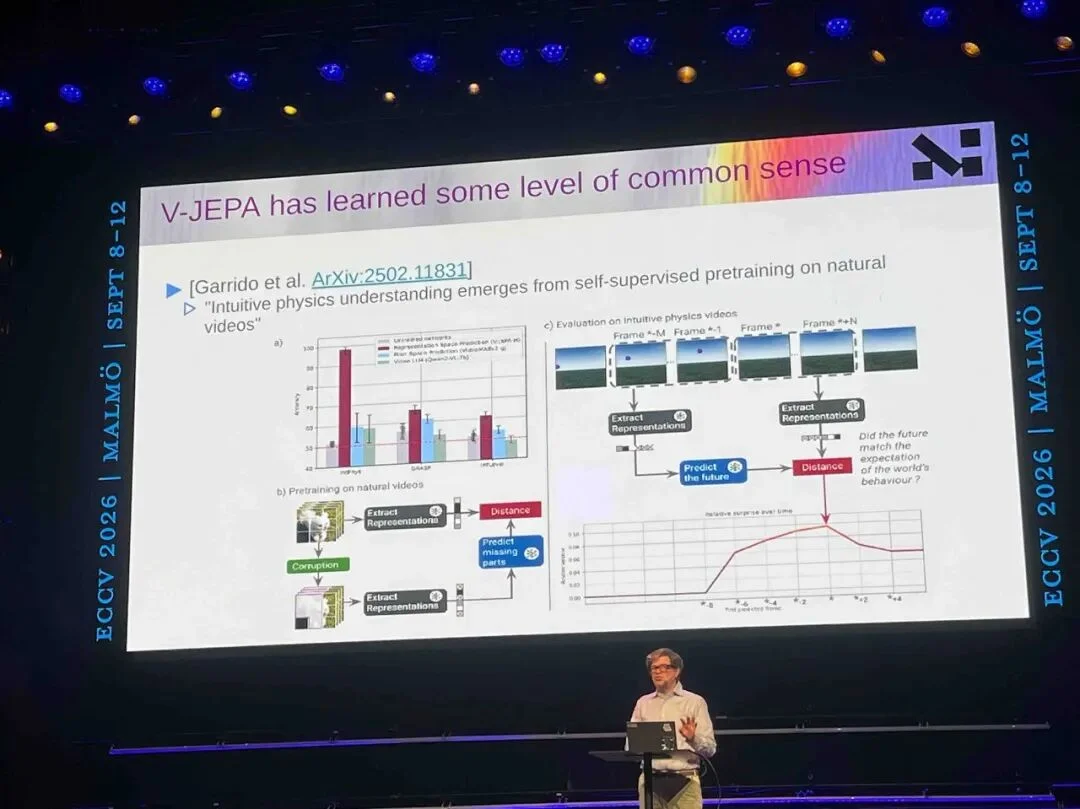
它的效果非常出色,而且还学到了一点常识:用训练好的系统预测未来帧时,如果输入一个“不可能”的事件,比如有人扔球,球却停住、消失或变成方块,时序预测误差会急剧上升,因为系统已经知道“这不可能发生”。
这是一种“意外度”(Surprise)的度量,与儿童心理学家用来判断婴儿是否建立某个概念的方法非常相似。我们正用它进行一些视频规划研究。
我还想分享一个我思考了十年的问题:这种系统能否自己学出“世界是三维的”?
答案是:能。人类显然具备这种能力。很多人认为人类对三维空间的感知是硬编码在基因里的,但我并不相信。理由很简单:你转头或移动时,视野会变化,近处的物体移动快,远处的物体移动慢。这种“视差”现象,最好的解释就是:世界中的每个点都有深度。
因此,一个系统只要学会预测视频里接下来会发生什么,它无需太多先验,就应该能推断出世界是三维的。
V-JEPA 2.1 正是如此。它是单目的,完全没有深度信息,只靠大量视频训练;然后,在它产出的表征上接一个监督探针来预测深度图,效果甚至优于使用深度信息的对照方法。
也就是说,没人专门教它“深度”是什么,它自己看视频就看懂了。谁挡住谁、怎么把物体分开,这些也都是在训练视频时自己学会的。
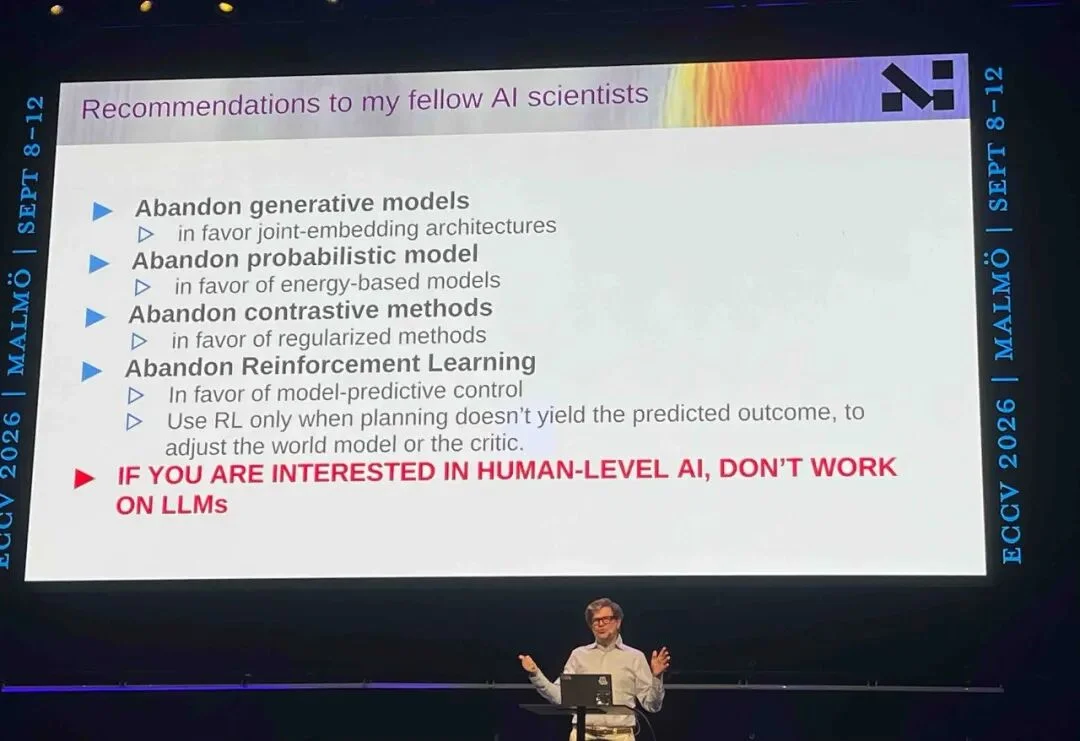
最后这张幻灯片,是我给同行 AI 科学家的几条建议——可想而知,这让我在硅谷极其“受欢迎”。
第一,别再追求更好的生成式模型了,去转向联合嵌入架构。这不光是在“怼”硅谷,也是“怼”全世界所有生成式模型相关的实验室。
第二,我始终为联合嵌入架构和抽象表征站台,为世界模型站台。
第三,我推崇有理论和实验依据的正则化方法,也更推崇维度对比,而不是简单的样本对比。
第四,我很久之前就提过,我们应该明智地使用强化学习这个方法,因为它在“试错次数”上极其高效。
最后我要强调:如果你真想推动 AI 走向人类水平,就别再去研究 LLM 了。当然,强化学习用起来也非常复杂。非常感谢。
Q&A
▎提问者:您说,如果对人类水平 AI 感兴趣,就不该再研究 LLM。那么,继续做 LLM 或基于文本的任务,还有意义吗?
Yann LeCun:
当然有。LLM 在它们擅长的领域非常出色:写代码、做数学、处理大量文本相关任务,都很有用,我们自己也会用。我不是说它们没用或不好,我的意思是:
如果你志在把 AI 推向人类水平,光靠 LLM 是到不了的。所以,你不该把精力全耗在它上面,而应该去补足那些缺失的部分。
▎提问者: 无论是 LLM 还是您提出的世界模型,显然都越来越强。但另一面是巨大的成本消耗:公司在规模扩张上竞赛,代价却由全社会承担,包括能源、水、硬件和算力。您认为,应该由谁来决定我们把智能扩展到什么程度?又该如何确保通用智能的收益,对更广泛的社会和环境而言是划算的?
Yann LeCun:
这是个重要问题,但它不是科学或技术问题,是政治问题。
人们叫我“AI 教父”,觉得我应该回答——我确实公开发表过政治观点,你们很多人可能见过。
但这类事不该由我,也不该由“我们”来决定,而应由全社会决定。如果你希望技术进步的收益被广泛共享,就应该选出那些有正确税收政策和社会政策的政客。欧洲通常如此,美国则不是;其他国家呢?
如果你真想搞清楚技术革命对劳动力市场的经济影响,就不该听 Geoffrey Hinton 这类 AI 研究者,而该听那些研究过技术革命如何影响就业的经济学家,其中有两位还是诺奖得主。他们才懂,我不懂,我听他们的。
▎提问者: JEPA 很关键的一点是,你需要有“目标状态”,才能以模型预测控制(MPC)的风格优化动作。从实用机器人角度看,比如我想清理厨房,该怎么获得这个“目标图像”?
Yann LeCun:
你不需要图像,你需要的是目标状态(Goal State)。这个状态可以用很多方式定义:你可以先把一张图送进编码器;也可以直接输入一段文本,把它编码进同一个空间——文本本身就能指定一个目标状态,甚至一整条轨迹。所以,我们现在图省事,是用目标图像来定义任务,但你想怎么指定任务都行。它本质上只是一个代价函数。
▎提问者: 在生物数据上,有这样一种说法:“你只能建模你能测量的东西,也只能测量你能建模的东西。”您怎么看用这类模型处理生物数据?
Yann LeCun:
这方面正有人在做。比如,有一些工作用 JEPA 在细胞层面建模生物现象;我以前在 Meta 巴黎的同事 Jean-Rémi King,他是一位神经科学家,也在用 JEPA 建模从 MEG、EEG 等设备得到的神经活动。这个方向完全可行,我也很好奇。
▎提问者: 有些关键动作是不可逆的,一旦出错,后果可能是灾难性的。您的世界模型,靠什么保证它懂得“何时不该行动”?
Yann LeCun:
首先,没有任何保证。保证只取决于你的世界模型是否正确,以及你的护栏目标是否恰当。
我前面说过,护栏目标的本意,是保证系统采取的任何动作,都不会把世界带进伤害他人的状态序列。但这当然取决于你把世界模型、把护栏训练得有多好。
具体的“蠢法”有三种:
第一种,世界模型本身是错的,它可能做出伤人的蠢事,比如,它错误预测了对某国加征 50% 关税的后果。
第二种,你给模型设计的护栏本身可能是错的。如果设定的护栏根本不包含“不要伤人、要最大化人的福祉”,比如你是个自私自利的人,那么哪怕预测对了,模型仍可能做出坏的决定。再比如,如果你给它设定的终极任务目标是错的,比如“我只想发财、不管别人”,那模型就会“作恶”。
第三种,模型的世界感知可能是错的,比如,模型以为“我的国家经济很棒”,然而现实情况并不是。
文章来自于微信公众号 “AI科技评论”,作者 “AI科技评论”
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI