成立才一个多月,估值就要冲到 500 亿美元。
根据 Business Insider 9 月 11 日报道,Jeff Dean 的新公司 Discovery Loop 正在寻求新一轮融资,这个数字几周前还是 100 亿美元,虽然还未最终落定,但目标估值已经翻了五倍。
按照 Discovery Loop 公司的规划,AI 将参与提出实验、执行实验和分析结果,而第一个被研究的对象,就是自家的技术体系。
资本押注的逻辑很清晰:如果 AI 能加速 AI 的研发,那被加速的就是一切。
2022 年底 ChatGPT 刚出现时,大家还在惊讶于 AI 能写文章、回答问题。如今,从 Chat 到 Code,AI 能够完成的任务越来越复杂。
过去几个月,这种 “推背感” 又强了一截。
5 月,OpenAI 公布了一份由模型给出的数学证明,推翻了数学家研究了近 80 年的埃尔德什单位距离猜想。几位外部数学家检查了证明,还专门写文章讨论它带来的新认识。
Anthropic 则把一个 AI 研究问题交给了一群 Agent,利用较弱模型的反馈训练更强的模型。在这个过程中,研究人员只设定问题和评价标准,AI 自己提出思路、运行实验、比较结果,再继续调整。在论文实验中,AI 找到的方法超过了人类研究者调优的基线。
Demis Hassabis 在今年 Google I/O 表示,如今是 “科学发现的新黄金时代”。Chat、Code 之后,全球最前沿的实验室都在不约而同地往一个方向走 ——Discovery,让 AI 参与科学发现,创造连人类也不知道的新的知识。
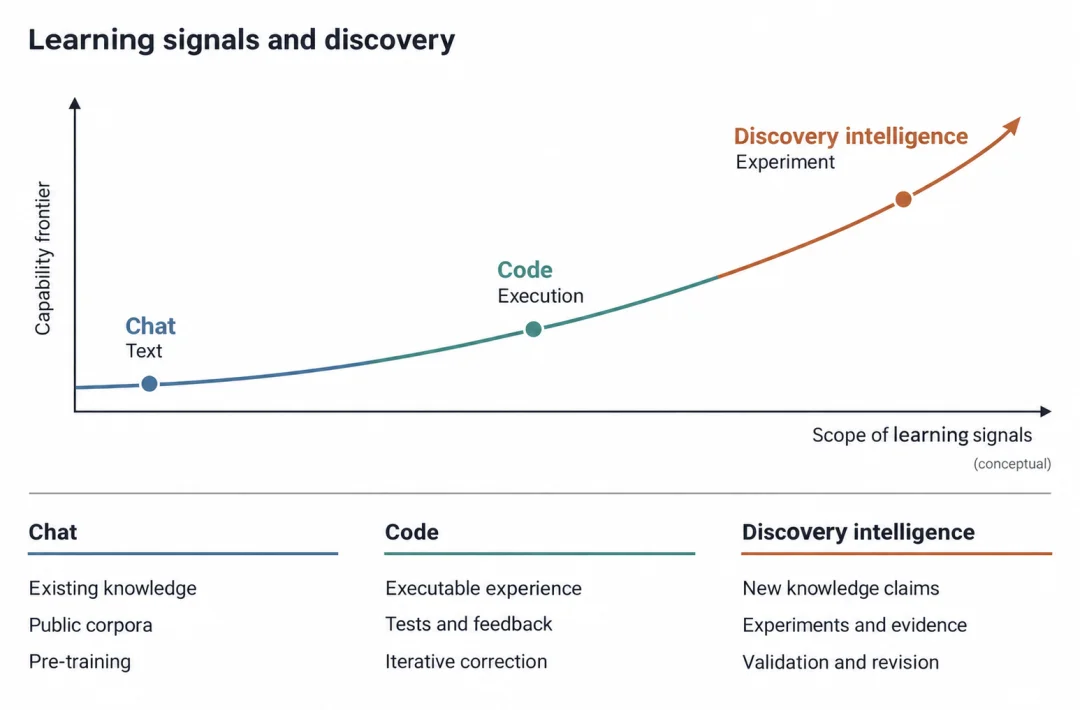
图 1:智能跃迁的三个阶段:从 Chat 到 Code 再到 Discovery Intelligence。
从 Chat 到 Code,变化的不只是模型能够完成的任务,也包括模型能够接触和学习的经验类型:从静态知识,扩展到带有行动、结果与反馈的交互式 experience。
但越往未知处走,AI 就越难依赖现成的任务说明。当人类也不知道答案时,AI 该如何选择下一步,又怎样把一次探索中获得的经验,用到下一次研究?
现在,这个领域迎来了一位值得关注的新玩家。
9 月 15 日,新型研究组织(Neo Lab)PhAI Labs 发布 Discovery Foundation Models(DFM)技术报告,提出一套面向开放式科学发现的通用模型系统。核心团队成员来自斯坦福、牛津、普林斯顿等高校及产业研究机构,研究方向涵盖基础模型、强化学习、智能体、科学智能与递归自我改进(RSI)。
这支团队兼具顶尖科研履历与模型研发经验。据介绍,核心成员在 Cell、Nature、Science 三大期刊均有第一作者论文,在 NeurIPS、ICML、ICLR、CVPR 等顶会上累计发表百篇论文,多项工作入选 Oral。除了学术成果,团队还拥有基础模型预训练、强化学习与具身智能系统研发的实战经验。更为难得的是,这一团队组合将科学问题定义、模型训练、具身执行与强化学习四层能力汇聚于一体,为连接科学问题、模型研发和实验反馈提供了科研与工程两方面的支撑。
他们的思路,是把科学发现从一条直线变成一个闭环:
让 AI 自己识别值得研究的未知问题,提出的假设也不停留在文本里,而是进入真实的工具、数据与实验环境,接受外部证据的检验,而每一次验证的结果,都成为下一次探索的起点,反过来更新 AI 对世界的理解,开启下一轮发现。
在这个过程中,人类科学家的判断与关键选择被完整记录下来,成为训练下一代模型的经验。
- 技术报告:Discovery Foundation Models: Toward Open-Ended Discovery Intelligence
- 报告链接:https://arxiv.org/abs/2609.15973
- DFM 科学家计划入口:https://phai-labs.com/collaborate/
- 官方网站:https://phai-labs.com/
模型已经很强,科研还卡在哪里?
让 AI 进入科学研究,困难首先在于:研究往往没有一套预先写好的任务说明。
Karpathy 今年 3 月开源的 autoresearch,AI 自主修改训练代码、运行实验,并根据指标保留还是撤回。autoresearch 可以在明确的训练环境里,用固定指标判断一次修改是否有效。
但在真实科研中,研究者可能连应该研究什么、应该测量哪些变量都需要反复斟酌。一次实验失败,有时意味着方法需要调整,有时则是问题本身就问错了,而区分这两种失败,恰恰是科研里最难、最有价值的判断。
这些判断很少完整地出现在论文里。人们通常能读到最终结论,却不容易看到一个假设为什么被放弃、一次实验为什么失败,以及哪条新证据改变了研究方向。而这些没被写下来的过程,正是 AI 学会做科研最需要的学习材料。
实际上,从产业分工看,两端的资源已经存在。一端是前沿 AI 实验室,提供通用模型、推理能力、算力和训练工具;另一端是科学家、研究机构和自动化实验平台,拥有真实问题、专业数据、实验条件和领域判断。
然而,两端之间,仍有巨大 Gap:
- 用通用大模型,经验留不下来。科学家会不断追问、修改或否定 AI 的建议。但这些反馈往往散落在聊天记录里。后续实验结果没有返回系统,AI 就无法知道自己的哪项建议有效、哪项判断被证伪。
- 用 AI Scientist,领域换不动。自动研究 Agent 能在计算环境里完成连续实验,但每换一个领域,工具、数据接口和验证流程都要重新配置;一旦涉及细胞培养、分子合成这类湿实验,还要解决仪器接入和真实反馈的问题。
- 用专用科学模型,预测接不上决策。AlphaFold 能预测蛋白质结构,分子生成模型能设计候选分子。但预测做得准确,不代表能自动回答后续问题:改变一个分子、加入一种物质或者调整实验条件,会带来什么影响?这些判断仍需要额外的模型、仿真或实验。
- 就算建起自动化平台,经验也复用不了。哪些方案可以先用计算方法筛选,哪些地方必须请科学家判断,哪些假设值得投入时间和资源做湿实验。这些选择如何配合,一次研究积累的经验怎样用于其他项目,还是需要有人来组织。
四个问题指向同一件事:AI 不缺工具,缺的是让判断、证据和经验持续积累的闭环。而这,正是 PhAI Labs 要解决的事。
构建承载科学研究经验的基础设施
PhAI Labs 的判断是,要让 AI 参与科学发现并且让这一过程规模化,缺的不只是更强的模型,还需要一套能够承载科学研究经验的基础设施。
模型会迭代,但研究过程中产生的判断、证据与反馈,需要一个地方沉淀下来。
这套 Science Infrastructure 需要组织科研数据与研究轨迹,提供可执行、可复用的科学环境,连接模型、工具、仿真、科学家和真实实验,并让一次研究中产生的经验能够进入下一轮训练与发现。
为此,PhAI Labs 提出了一个五层能力体系。
最底层是 Science Data,负责整理科研数据和研究过程。科学家的修改、工具的运行结果、真实实验的反馈,都需要保留来源和上下文,才能成为后续研究与模型训练可用的材料。
第二层是 ScienceIDE,把科学代码、工具、任务目标和验证标准组织成可执行、可验证和可复用的研究环境,让研究者在进入一个新任务时,不必每次从零搭建工具和流程。
第三层是 JEPA-Anything,探索如何预测科学系统在不同条件下的状态变化。例如,采取一种干预、改变某个实验条件之后,可能发生什么?这类预测可以帮助研究者快速筛选方案,再把更值得验证的假设交给耗时更长、成本更高的湿实验。
第四层是 DFM 核心推理系统,通过多模型协同组织研究过程。它结合了基座模型、当前研究状态、记忆和验证机制,决定下一步是修改假设、调用工具、进行预测,还是寻求专家判断与实验验证。
第五层是 ScienceBuddy,负责与科学家的实时交互。研究者的追问、修改、采纳和否定,都可以成为系统改进的依据,并进一步返回数据层。
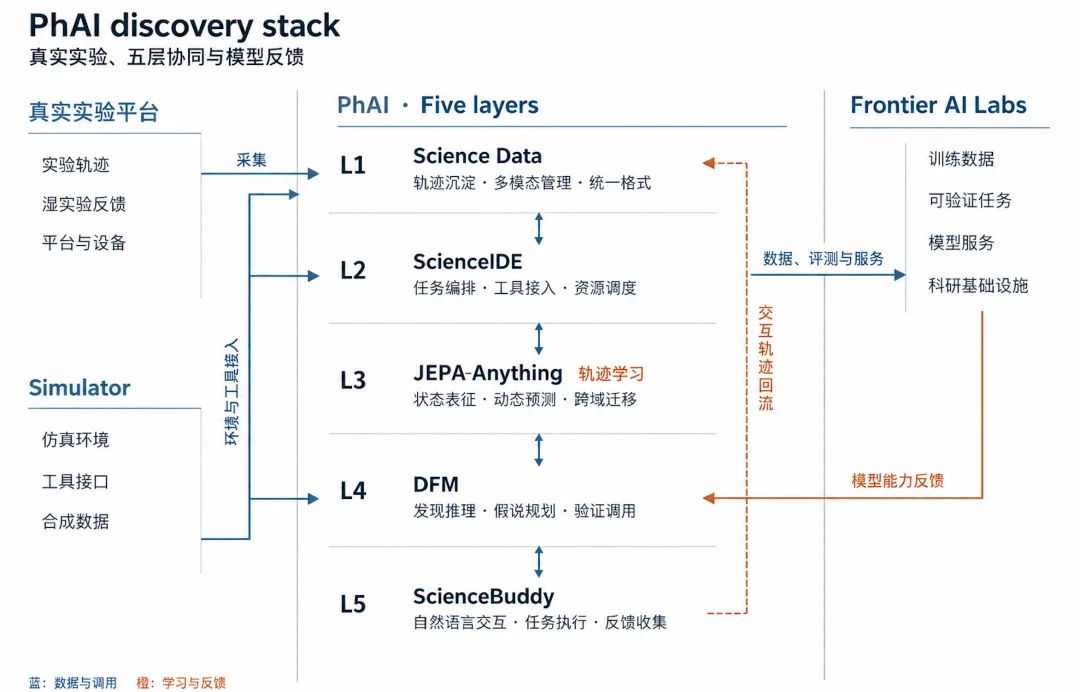
图 2:PhAI Labs 的五层能力体系,连接前沿模型、科研环境与真实实验反馈。
从数据、环境、预测、推理到交互,这五层让不同速度、不同成本、不同可靠性的反馈得以彼此结合,共同支持一项研究持续推进。
PhAI Labs 当前主要围绕已有基座模型的后训练和系统工程开展工作,长期目标则是形成面向科学发现的原生基础模型家族。
做完这次研究,下次能不能少走弯路?
如果说五层体系回答的是基础设施该如何组织,那么处于体系核心的 DFM,回答的就是一个更具体的问题:拿到新证据之后,研究该继续往前走,还是回头调整方向?
PhAI Labs 将 DFM 定义为一类面向科学发现的通用模型系统。与现有的 LLM 不同,DFM 要让 AI 逐步参与到三类工作中。
首先,AI 要能和科学家一起识别值得研究的未知,把一个尚未解释的现象,转化为可以着手研究的问题。
其次,是科学表征的构造与修订 —— 用哪些变量、哪些关系来描述研究对象,本身也需要随着研究调整。当现有分析框架遗漏了重要因素,系统就需要重新选择观察和描述问题的方式。
其三,提出假设之后,AI 还要调用仿真、仪器和实验来检验它,并根据得到的证据更新自己的判断。
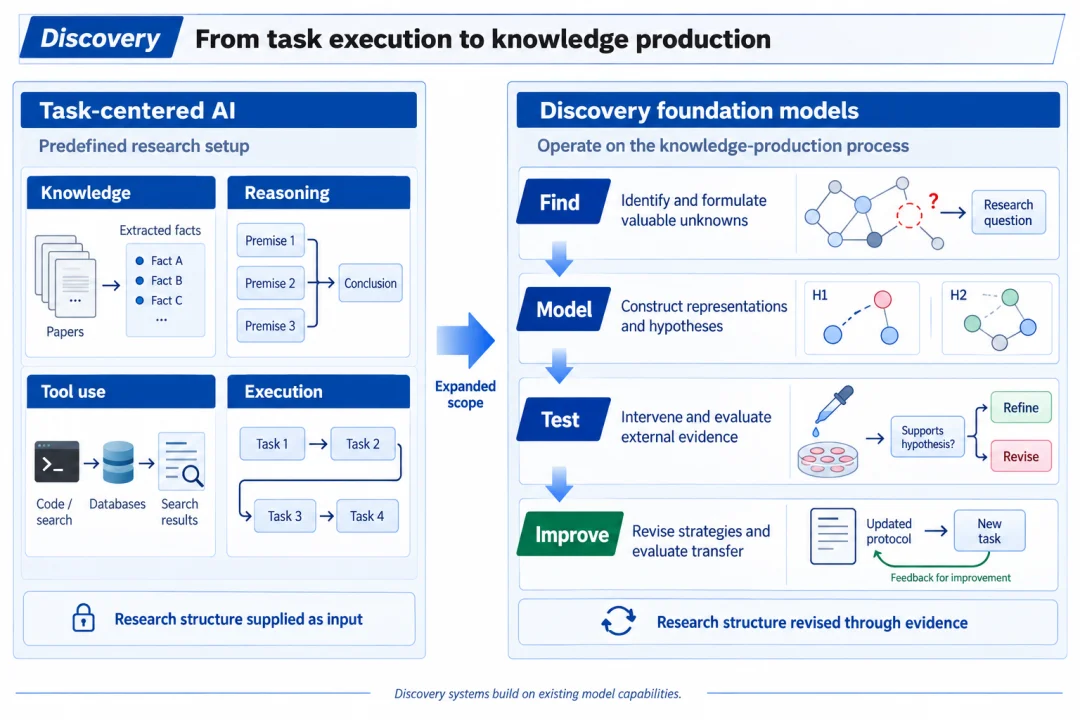
图 3:从预定义任务到知识生产过程,LLMs 与 Discovery Foundation Models(DFMs) 的能力边界对比。
为此,一个完整的 DFM,由基座模型、研究状态、记忆、科学工具、实验环境、验证机制和人类监督共同构成。模型负责推理,工具和实验帮助取得证据,研究记录则保留此前的判断及其依据。
DFM 希望系统不仅学习 “得出了什么结果”,也学习 “结果是如何被产生和验证的”。这些连续的研究过程可以被组织为 research trajectory,成为后续形成可复用发现技能的基础。
举个例子,当现有数据解释不了某个现象时,系统需要判断,是数据不够、假设不对,还是此前选择的观察方式遗漏了关键因素。补充数据、更换解释、加入新的观测变量,会把研究带向不同的下一步。DFM 希望 AI 能够参与这些选择,并用后续证据检验自己的判断。
要作出这样的判断,系统首先需要知道:研究现在进行到了哪一步,哪些判断已经有了证据支持,哪些还只是猜测,接下来又有哪些实验可做。
为此,PhAI Labs 提出了 Zetema 参考架构,将当前问题、描述问题的变量与关系、候选假设、已有证据、实验行动和可用资源,组织成一个可以持续更新的 “研究状态”。
Zetema 想让 AI 学会的,是根据证据改变研究方向。
在一次研究过程中,系统可以同时保留几种解释,比较各自的依据,再选择最有助于分辨这些解释的下一步实验。当结果与预期不符时,系统不仅要重新生成一个答案,还需要据此决定,是要继续收集证据,放弃某个假设,还是重新定义问题。研究方向和分析方法本身,都可以随着证据改变。
验证同样贯穿始终。关键行动还需要经过逻辑、证据来源核对,以及工具和仿真验证,系统也需要主动寻找可能推翻假设的证据,必要时交由人类审批。代码和仿真可以提供计算层面的结果,仪器与真实实验则带来物理世界的反馈。
新证据改变现有认识,新的认识又影响下一轮提问和实验。由此构成一个递归发现循环(Recursive Discovery Loop)。
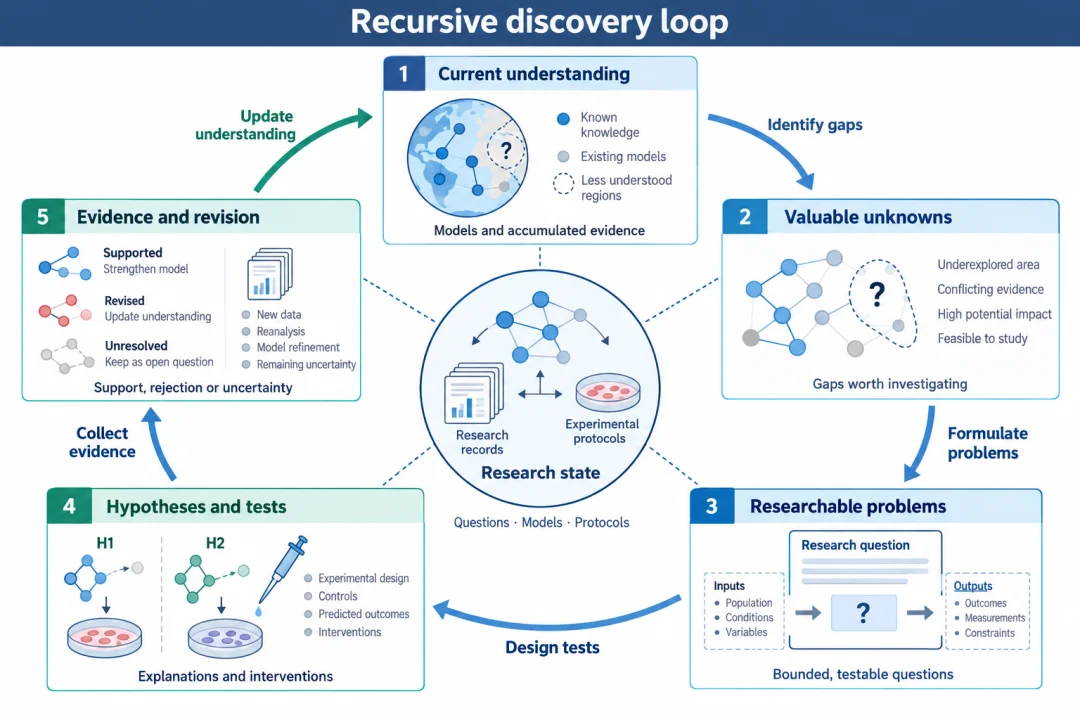
图4:Recursive Discovery Loop——从问题发现、假设形成到外部验证,再回到对世界理解的更新。
这里最值得期待的,是下一次研究能留下多少 “上一次的经验”。
哪些路已经试过,哪种工具适合处理这类问题,什么证据足以推翻一个假设 —— 如果这些都能积累下来,AI 再面对新问题时,就有机会少走一些弯路。
五轮实验里被重新打开的研究方向
前面所说的根据证据改变研究方向,并不是停留在架构图上的设想。在一个治疗肽设计中,PhAI Labs 的 GALILEO 系统就已经实际做出过这样的调整,把一个此前放弃的设计思路重新纳入下一轮研究。
肽可以简单理解为由氨基酸连接成的短链。选用哪些氨基酸、按什么顺序连接,会影响它的性质。研究者的任务,就是从大量可能的组合中,找到具有治疗潜力的候选分子。
GALILEO 系统先根据已有生物数据和研究知识选择方向,再检索、修改并设计候选肽。随后,机器人把这些候选分子实际合成出来,人类研究团队检查这些分子的质量,再通过成像等实验观察它们的作用。
实验结果返回系统后,下一轮设计也随之调整 —— 哪些设计值得继续,哪些应该放弃,对分子作用方式的解释是否成立,都要根据新证据重新判断。
在连续五轮设计与实验中,GALILEO 系统先逐步缩小探索范围,放弃了一批缺少证据支持的组合。但到了第四轮,随着对分子作用方式的假设发生变化,系统重新审视了那些早先被排除的设计思路,并把其中一部分又重新纳入考虑。换言之,它放弃的不是某条路本身,而只是当时证据下的结论,当证据更新,判断也随之更新。
研究团队还开展了类器官实验。类器官是用细胞在实验室里培养出的三维结构,能够模拟真实组织的部分特点,用来观察候选分子的作用。经过五轮湿实验反馈,系统总结出一组用于后续肽设计的经验,涉及分子中亲水和疏水部分如何搭配,以及怎样调整两者的平衡。这些经验不是某一次实验的结果,而是整个探索过程的产物。
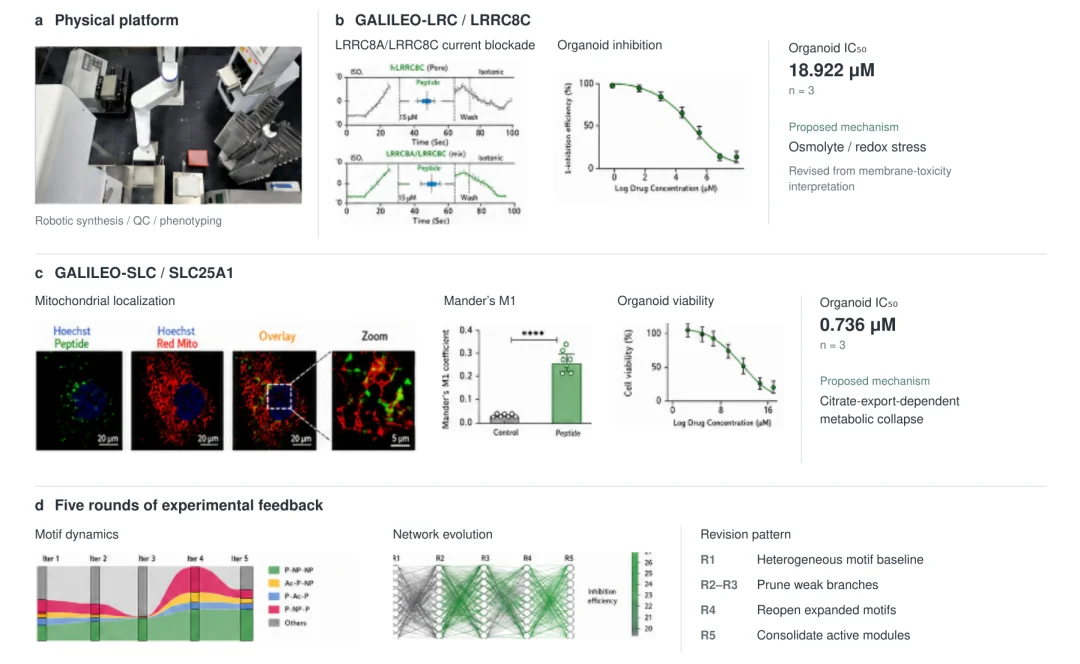
图 5:GALILEO 展示治疗肽发现中的设计、实验、反馈与修订闭环。
GALILEO 仍是一个特定领域的案例,但它给出了一个具体的起点:AI 提出方案,真实实验提供反馈,系统再从反馈中修改判断、积累经验。接下来要看的,是这种能力能否应用于更多科学问题。
PhAI Labs 也启动了 DFM 科学家合作计划,希望与科学家、实验室、科研团队和产业研发团队一起,从真实的研究问题出发,把各自领域中的研究积累与 AI 研究与工程能力结合,共同探索值得追问的问题,也在实际研究中完善这些工具与基础设施。
9 月 16 日至 18 日,PhAI Labs 还将依次发布 AI 科研搭档 ScienceBuddy、科学集成开发平台 ScienceIDE,以及跨领域统一科学世界模型 JEPA-Anything。
这些设想能走多远,团队计划通过开源研究、科学实验和外部合作,一步步验证。
结语
文章开头我们问过:当人类也不知道答案时,AI 该如何继续学习?
答案或许不是让 AI 给出更多答案,而是让它学会人类科学家最艰难的那项本领 —— 根据证据,改变方向,并且让每一次这样的改变都被记录下来,成为下一次研究的起点。
科学本身,就是人类面对未知时发明的学习方法。而它第一次,有了新的学习者。
文章来自于"机器之心",作者 "机器之心"。
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md