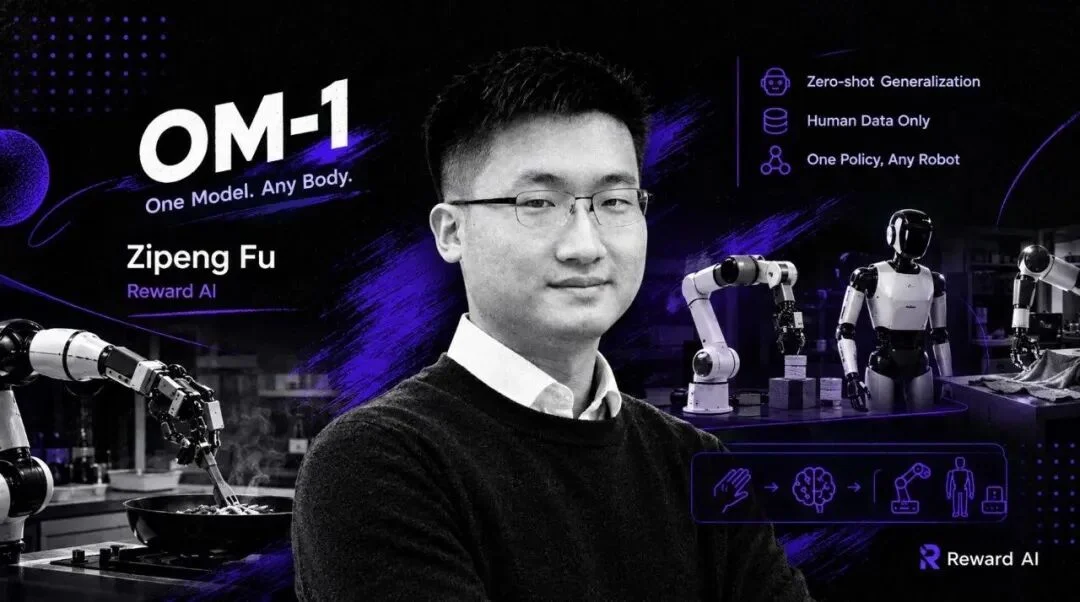
Reward AI创始人之一符梓鹏(Zipeng Fu)。图片经由AI生成
近期,由斯坦福大学计算机科学博士符梓鹏(Zipeng Fu)联合创立的新团队Reward AI,正式发布通用机器人策略OM-1(Omnibody Model 1),并公布了完整的Omnibody技术栈。
2024年,符梓鹏作为原作者之一参与打造的开源机器人系统Mobile ALOHA曾走红网络,让“具身智能”第一次大规模进入大众视野。如今,他和新团队再次把目光投向了机器人学习的核心难题:如果不再针对每一种机器人单独训练,一个模型能不能直接控制不同形态的机器人?
对于这个瓶颈,Reward AI给出的核心思路是:One Model, One Data Interface, Any Body(一个模型、一个数据接口、不同机器人本体)。
与传统路线相比,OM-1最值得关注的地方在于:它直接从人类自然操作数据中学习策略,训练全过程不使用遥操作(teleoperation)数据,也不依赖机器人本体经验(on-robot experience);同时,它实现了通用策略与硬件执行控制的分离,让同一套策略能够直接部署在工业机械臂、人形机器人等多种不同本体之上。
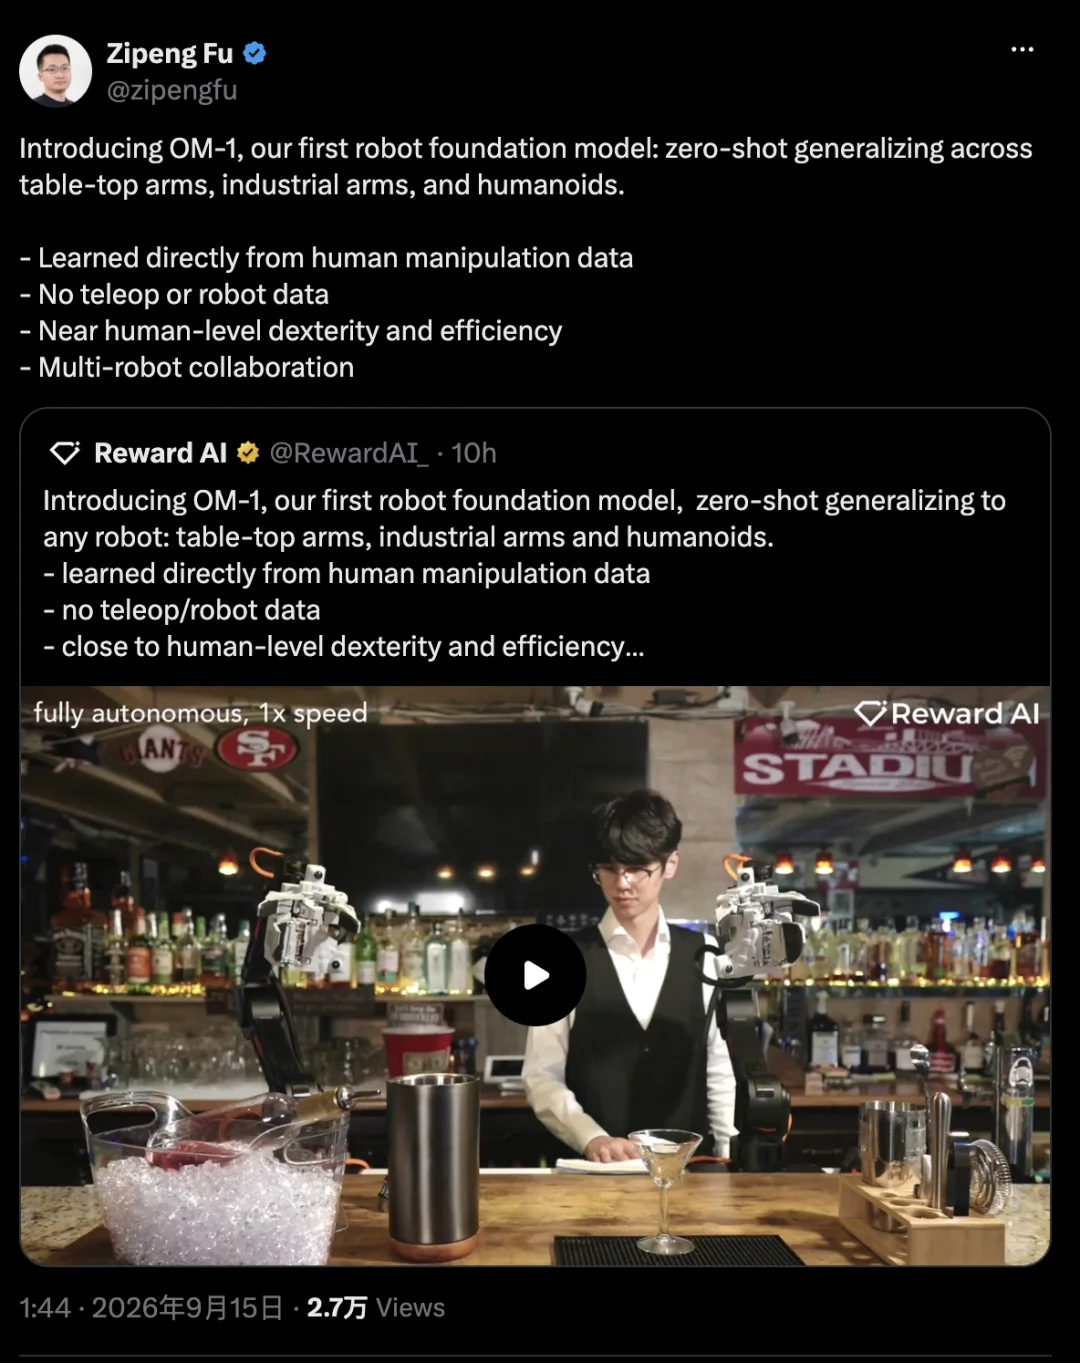
图注:Zipeng Fu发帖截图
01
OM-1到底能做什么:接近人类速度,跨机器人本体
判断一个机器人策略到底有什么价值,最直接的方法还是看它能做什么。在官方公布的演示中,OM-1展现了覆盖移动传送带分拣、连接器插拔、双臂协同装配、衣物折叠、动态抛掷以及高负载操作等多种复杂任务能力。这些任务的共同点在于,机器人面对的并不是完全静态预设的环境,而是在运动、接触和受力过程中不断产生动态变化的物理世界。
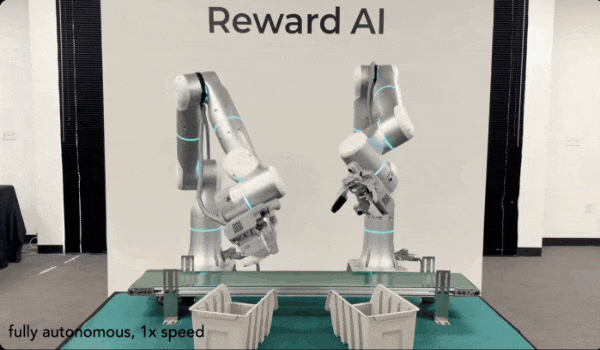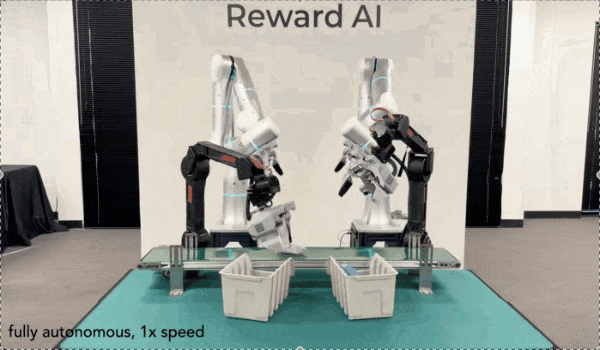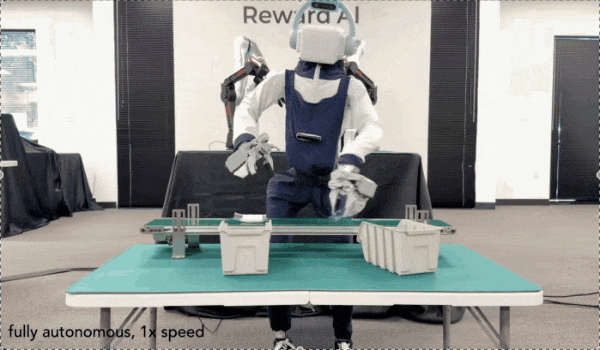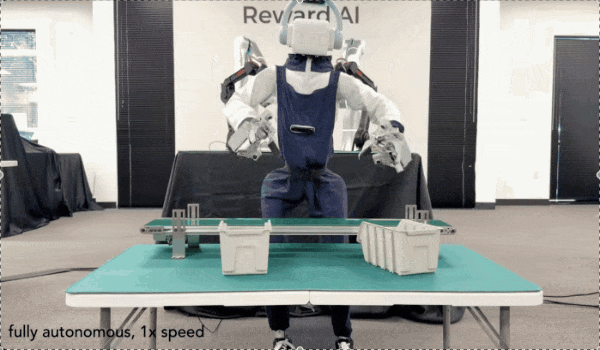
在移动传送带分拣场景中,两只机械臂需要在高速移动的传送带上精准抓取手机并放入包装盒。
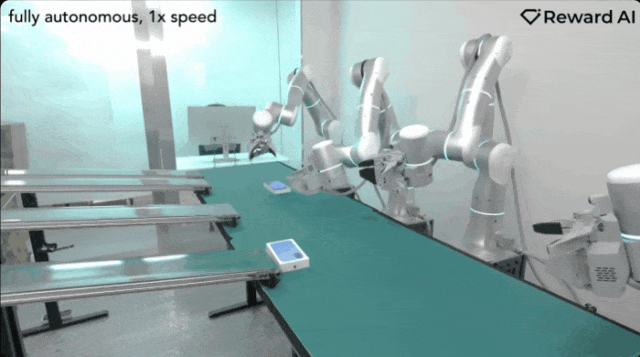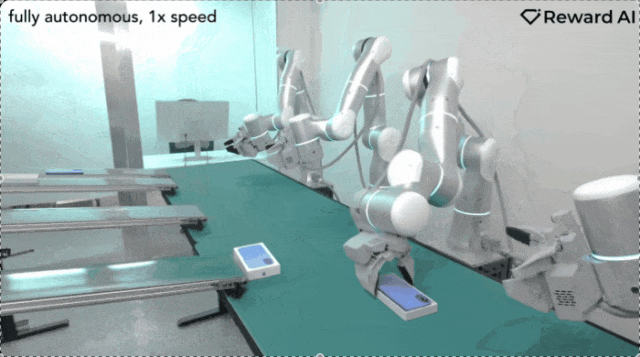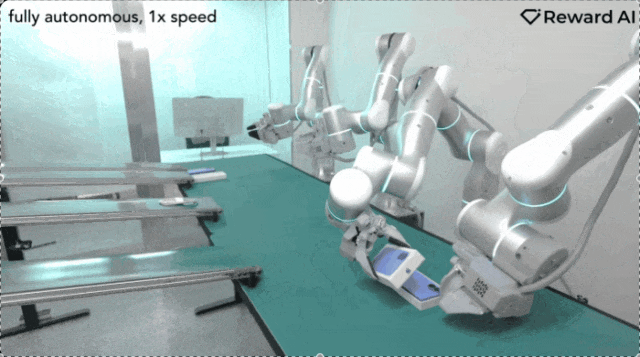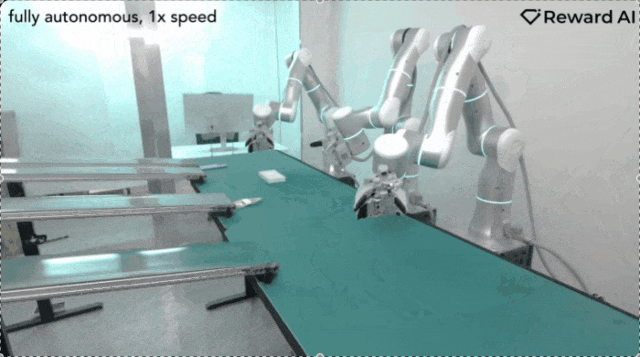
机器人需要在极短时间内连续完成目标识别、运动规划、接近、接触、抓取和放置。此时视觉负责提供整体场景的上下文信息,而指间近距信息和触觉信号则帮助系统判断物体的接近与接触瞬间,实现精准抓取。
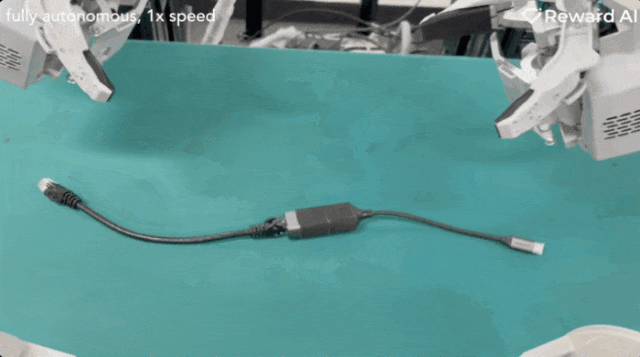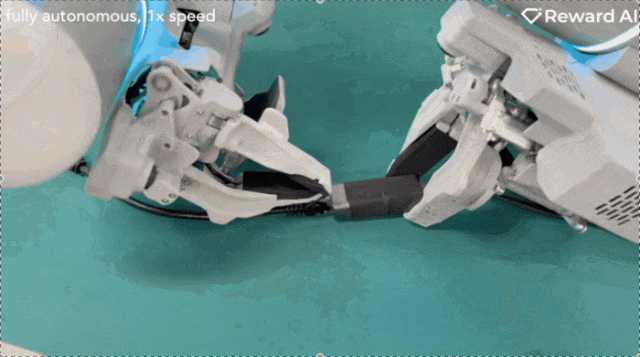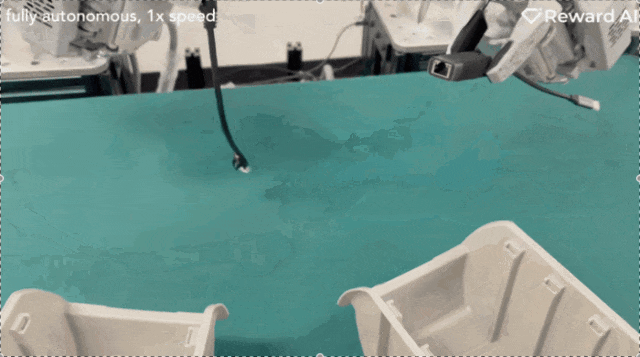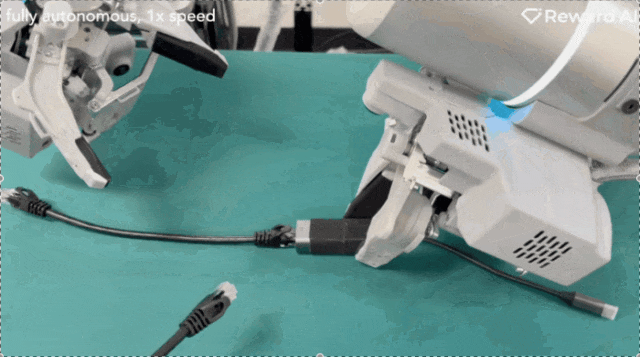
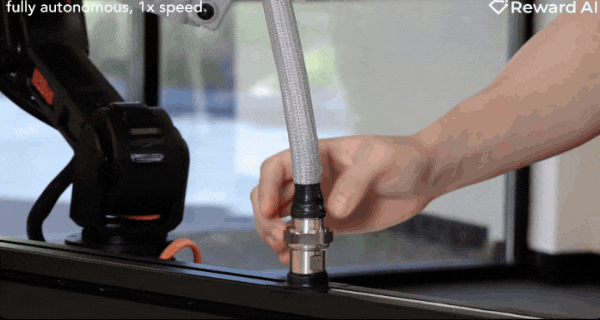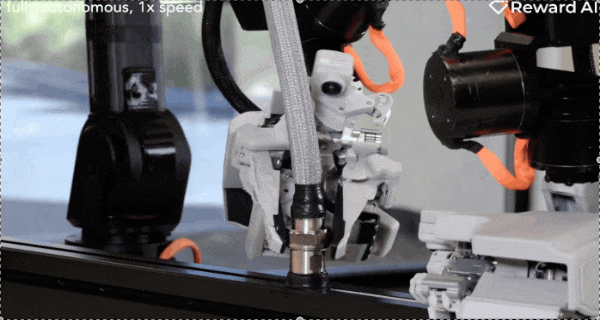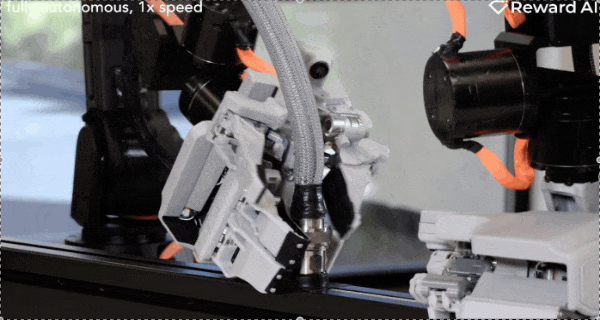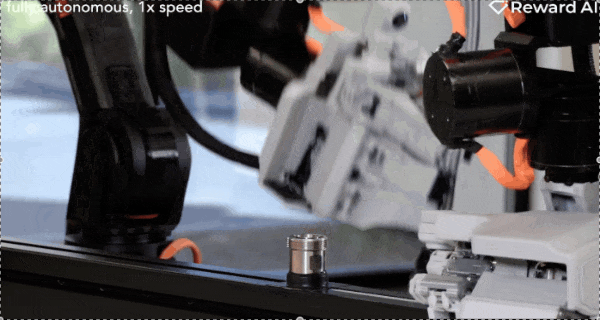
而在精细的连接器拔开任务中,两只机器人分别抓住连接器的两侧并将其用力拔开。
图注:Omnibody Hand灵巧抓取物品
这是一项典型的接触密集型操作,单纯依靠视觉只能确定连接器的大致空间位置,而触觉等高频信号则成为策略实时调整施加力度与完成解耦动作的关键输入。
在面对高阻力环境时,人形机器人展现出了直接拉开完全关闭的不锈钢冰箱门的能力。
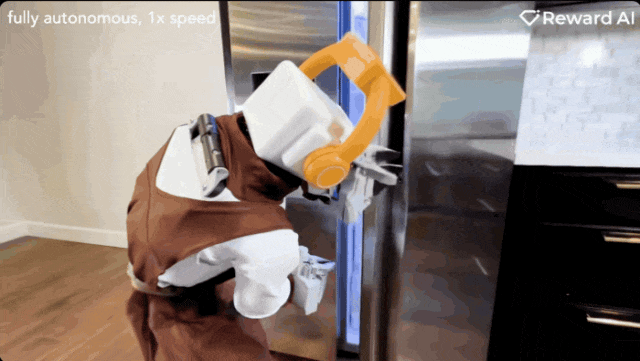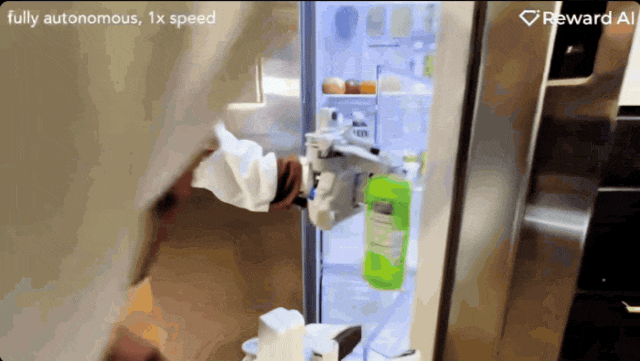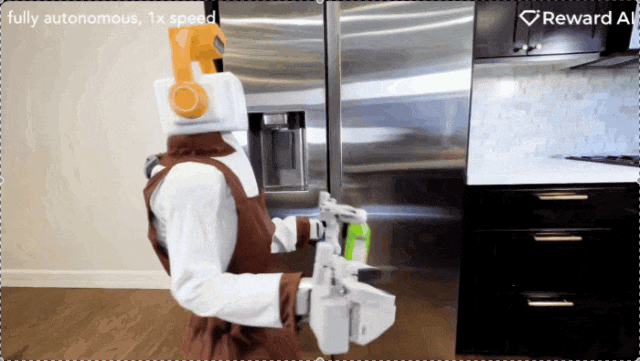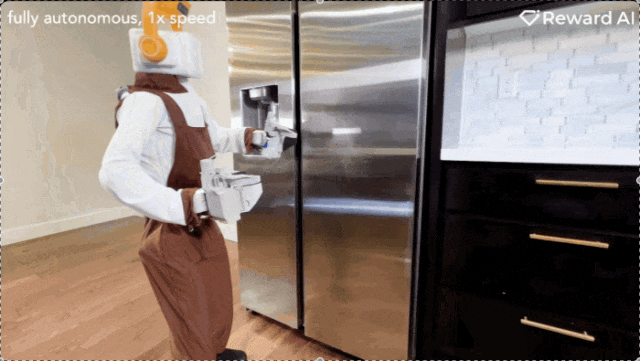
图注:双臂抓住连接器两侧并用力拔开
机器人抓住门把手并克服内部强大阻力拉开门体,展现了强悍的底层抗扰动控制能力。当真实环境中的阻力与预期产生偏差时,控制系统能够针对外部扰动与不确定动力学进行实时微调,确保机器人在受到意外阻力时依然保持既定轨迹并在扰动后迅速恢复稳定。
在追求极速的高动态操作中,机器人甚至能在移动传送带上高速抓取物体后,直接精准抛入指定的目标箱中。
图注:机器人拉开完全关闭的冰箱门。
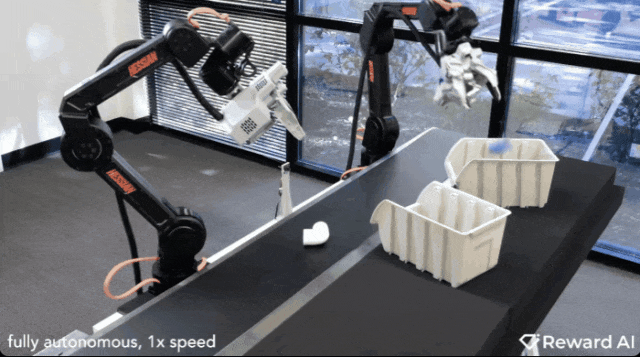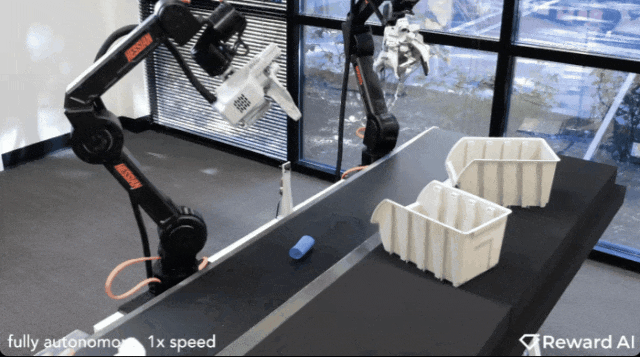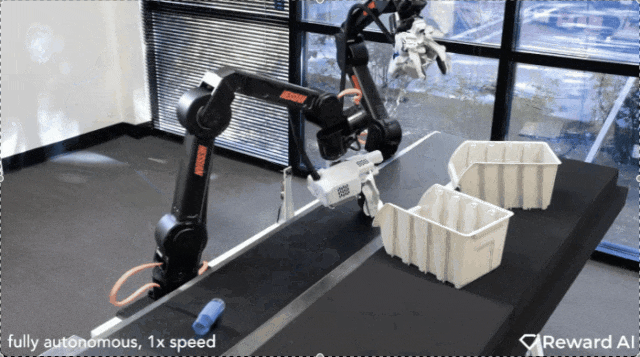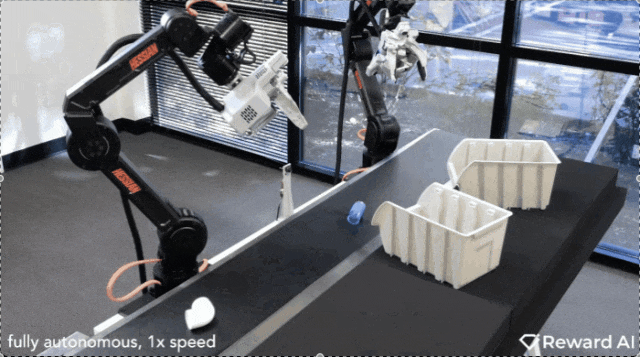
这类高动态动作要求机器人的行为不能止于“到达目标位置”,还必须持续保持运动速度、方向以及动作之间的连贯衔接,非常考验高频控制与策略推理之间的无缝配合。
此外,在双臂协同精细装配与衣物折叠等长时程任务中,机器人展现出了连续多步骤的逻辑操作能力。
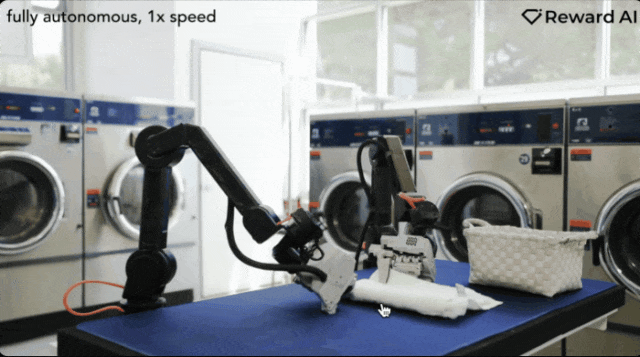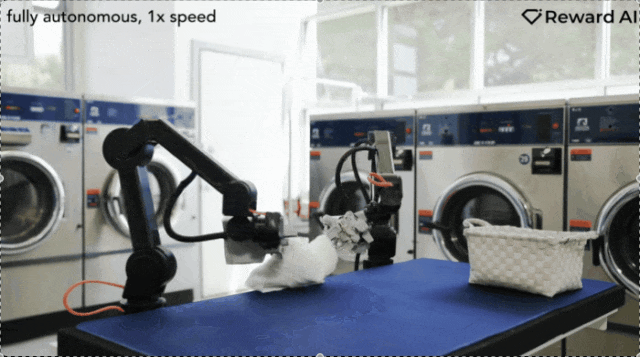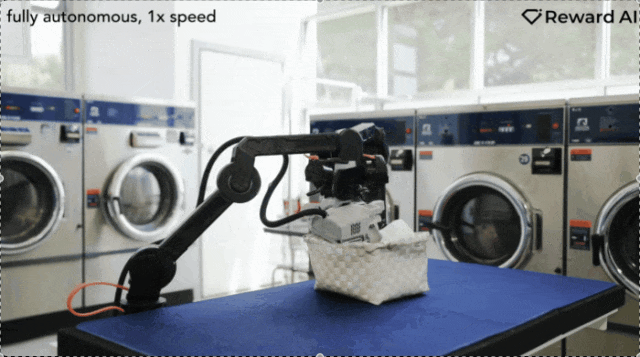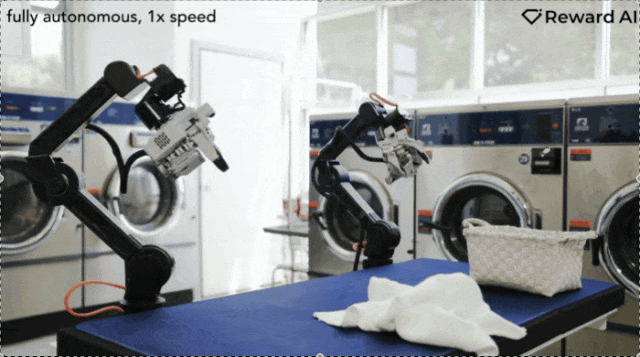
图注:接近人类速度的灵巧抓取与动态修正
图注:日常生活场景下的衣
官方表示,OM-1面对全新的任务时,只需要使用不到30分钟的人类演示数据量,就可以快速学会包括复杂动力学与长时程操作在内的新任务,大幅降低了机器人迈向新场景的数据成本。
02
背后的原理:一个模型,如何控制不同机器人本体
图注:全自主双臂协同精细装配
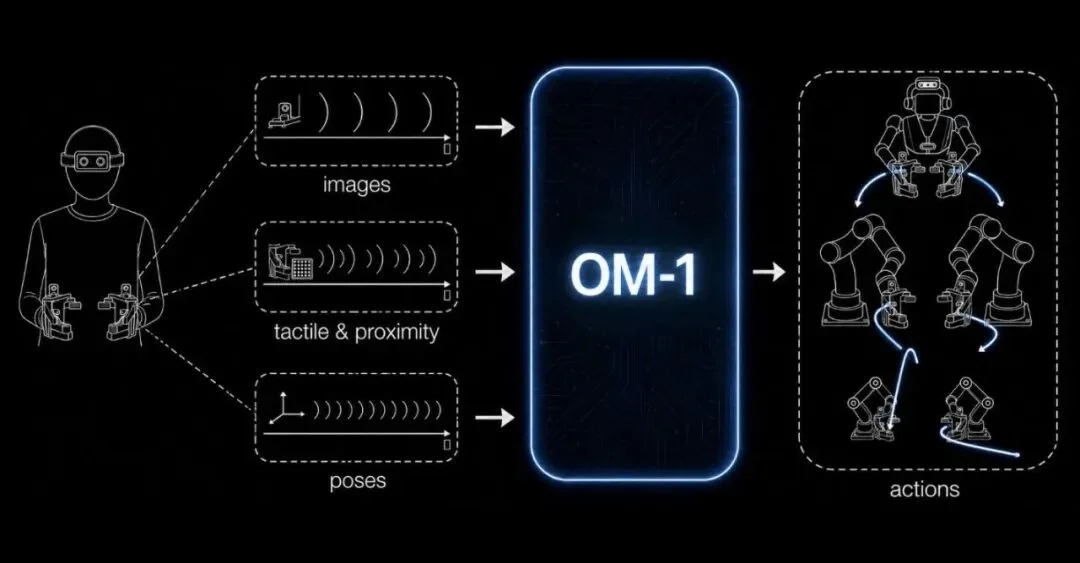
为了实现真正的“跨本体控制”,Reward AI将整个Omnibody技术栈拆解为四个层层递进的核心模块:从作为数据入口的Omnibody Hand采集人类自然动作,到One Data Interface将多模态高频信号统一封装,再由Omnibody Model 1学习纯粹的通用操作策略,接着通过Control Any Body利用仿真强化学习吸收硬件动力学差异,最终完成对“智能”与“身体”边界的重新划定。
·Omnibody Hand:人类自然操作的数据入口
整个系统的起点不是机器人,而是人手。
传统遥操作(teleoperation)的逻辑是“人控制机器人,机器人执行动作,再记录机器人数据”。Omnibody Hand 试图绕过这个中间环节,作为一种可穿戴设备,让穿戴者按照自己的习惯直接进行抓取、推拉与拿取,设备直接记录这些人类自然动作。
设备未盲目一比一复制人手的数十个关节,而是采用 7 自由度设计,重点保留捏取、协同与力量抓握联动,使用户能在精密捏取与力量抓握之间平滑切换。通过适应不同手型与减少滑动,防止佩戴者为了迁就设备结构而改变习惯动作,确保采集到的数据具备纯粹的人类自然操作特征。
·One Data Interface:多模态交互数据的统一接口
光有动作轨迹无法完整描述一次操作,系统必须知道“何时接触”以及“受力几何”。One Data Interface 将图像(场景上下文)、指间近距信息(接触前状态)、触觉信号(接触受力与滑动)与手部位姿轨迹(运动路径)这四类传感信息统一封装。
为了解决高速运动下的数据缺失与位姿漂移,One Data Interface 引入了高频触觉、全局快门手内相机,并在视觉惯性追踪之外加入了电磁传感(Electromagnetic sensing)。官方测试显示,在最高速度往返运动测试中,电磁追踪将平均过冲误差从视觉惯性方案的 24.9 毫米降低至 9.5 毫米,降幅达 60%。
·Omnibody Model 1:直接从人类数据学习的通用策略
在统一数据接口之上,OM-1 担当整个系统的决策“大脑”。
OM-1明确不使用遥操作数据,也不使用机器人本体经验(on-robot experience),完全从人类自然操作数据中学习生成策略。模型不把数据强行压缩至低频时间尺度,而是按照不同传感器的原生采样率处理多模态信息,并结合历史上下文进行推理。
OM-1输出的指令不仅是位置,还包含运动方向、速度、力度以及抓取/释放等事件的时间戳。此外,Pre-training 与 Post-training 保持相同的数据格式,使早期与最新的演示数据能够持续训练同一个策略。
·Control Any Body:吸收物理差异的底层控制层
解决不同机器人(工业臂、人形机器人等)在关节、执行器、质量分布与动力学上的巨大差异,靠的是OM-1下方的 Control Layer(控制层)。
OM-1负责输出通用操作意图,Control Layer则以更高的独立频率运行,将通用动作转换为特定机器人的电机控制指令。控制层通过仿真环境中的强化学习训练,专门处理速度/加速度动力学、外部扰动及系统延迟。(强化学习对应的是底层Control Layer,而非上层策略)。
Control Layer拥有独立的运行时钟,并包含针对连续两次策略预测过渡的在线优化算法,确保机器人在高速抛掷等动态任务中不会因为推理延迟而出现动作卡顿或突变。
03
重新划定“智能”与“身体”的边界
从Mobile ALOHA到OM-1,符梓鹏及其团队实际上完成了一次关于具身智能范式的升维思考:机器人学习到的,究竟应该是某一台机械臂的动作,还是可以跨越硬件差异的通用能力?
Omnibody 给出的答案,是建立一套极具工业美感的分工架构:由Omnibody Hand捕捉人手的自然灵巧,由One Data Interface抹平多模态数据的格式鸿沟,由OM-1学习纯粹的通用操作逻辑,最后由Control Layer在底层独自消化不同机器人的物理阻力与动力学差异。
这打破了以往“换一台机器人就要重写一套策略”的研发魔咒。尽管这一架构在复杂长时程任务中的泛化上限仍有待市场验证,但它清晰地指明了一个趋势:具身智能的“大脑”与“躯干”正在加速分立。
当通用策略可以像软件一样横向复用,硬件本体只需做好底层的物理响应时,具身智能的未来图景已然浮现:一套通用策略,加上不同的机器人身体。
文章来自于"腾讯科技",作者 "周小燕"。
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner