9 月 20 日,ZCode“静默上传代码”风波进一步从开发者社区的技术质疑,升级为企业层面的正式追责。
太原承明科技有限公司向 ZCode 客户端开发运营方北京智谱华章科技股份有限公司发出函件,称 ZCode 涉嫌在未经充分告知和授权的情况下,上传其公司数据资产及商业秘密,并就数据删除、流向说明、操作日志、责任主体和可能的数据出境等问题提出多项整改要求。
承明科技要求智谱在 10 月 10 日前作出书面答复,同时保留索赔、向监管部门投诉举报及提起诉讼等权利。
按照承明科技在函件中的说法,其独立取证发现,相关上传并非偶发的代码片段传输,而是自动、批量触发的完整归档,可能涉及项目源代码、系统架构、版本控制历史、数据库口令、云服务凭证及员工个人信息。
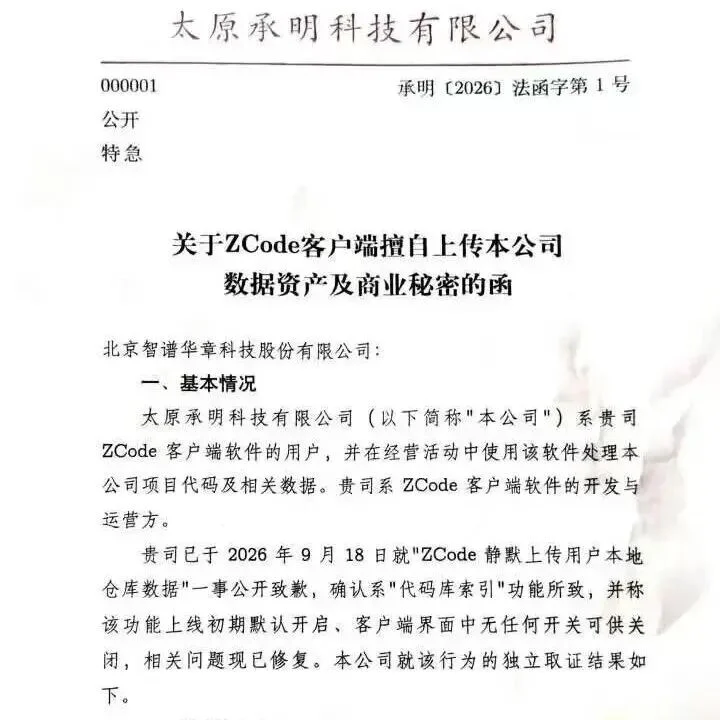
承明科技还称,在智谱 9 月 18 日公开致歉当日凌晨,其仍检测到相关上传行为,因此对智谱所称“问题已经修复”的具体时间和实际效果提出质疑。
函件还将争议引向两个此前尚未得到充分说明的问题:此前上传的数据是否已经彻底删除,以及数据是否可能发生跨境传输。
承明科技称,ZCode 部分网络请求指向新加坡主体,而产品服务协议的签约方为北京智谱华章,因此要求智谱说明实际的数据处理者、存储地点及是否向第三方共享。
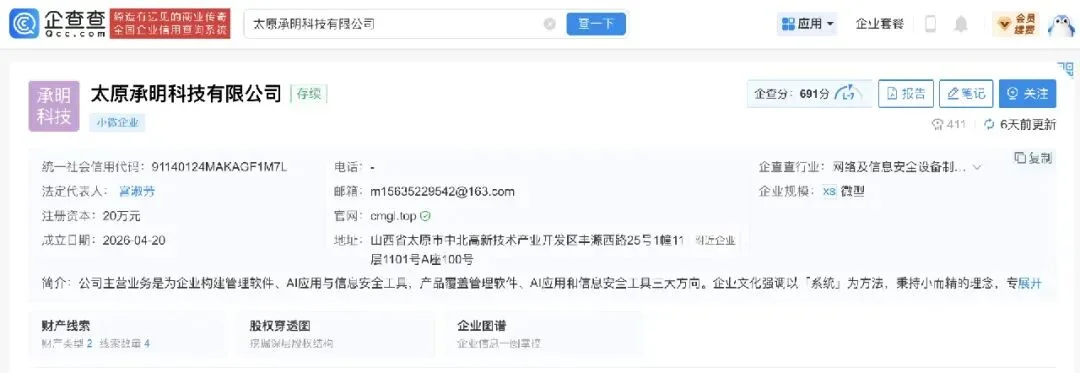
据企查查显示,太原承明科技成立于 2026 年 4 月 20 日,距今也才不到半年时间。
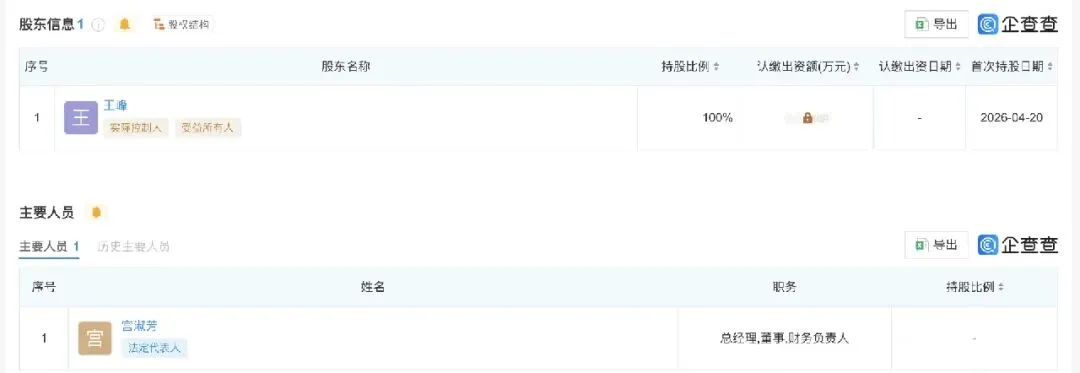
截至发稿前,智谱尚未就这封函件作出公开回应。
事件回溯
整场风波的起点,要从一名开发者清理电脑磁盘时发现的一个 313MB 加密包说起。
9 月 17 日晚,开发者 ferstar 还在技术群里向其他人推荐智谱旗下的 AI 编程工具 ZCode。
第二天,他在清理一台只有 256GB 存储空间的 MacBook Air 时,发现用户目录下的 ~/.zcode 文件夹占用了超过 700MB 空间。
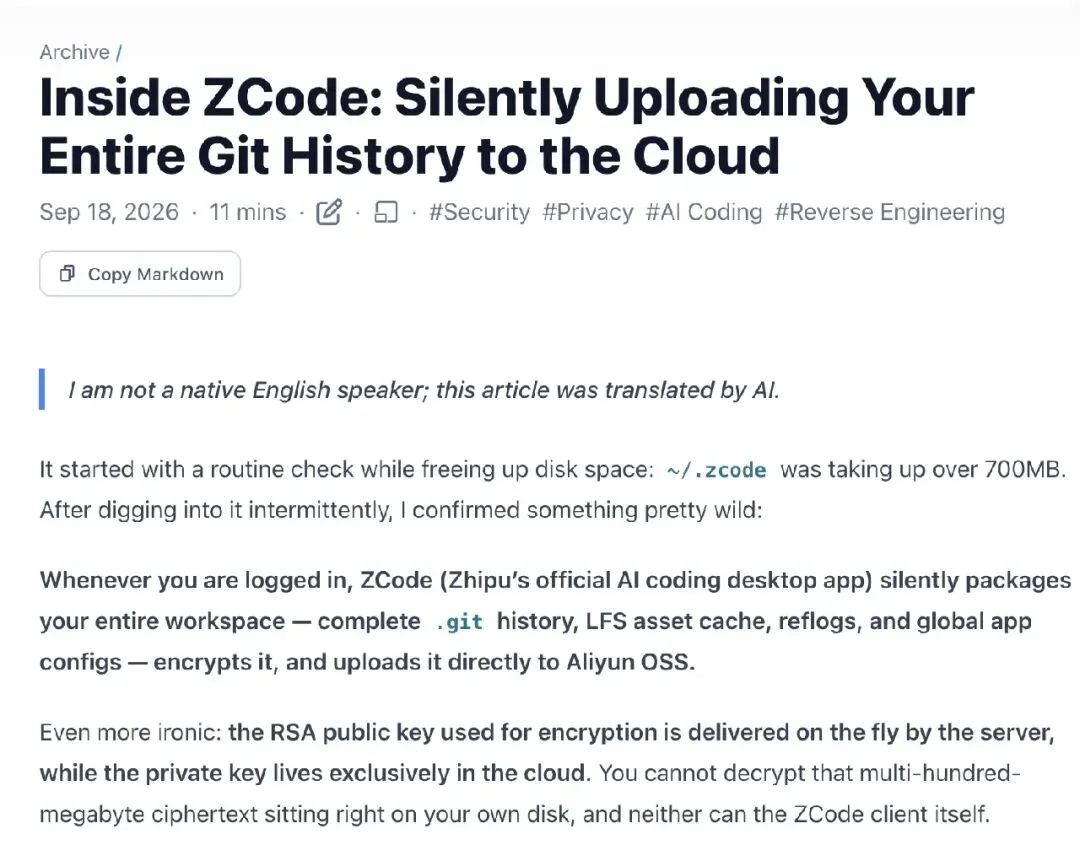
其中,约 257MB 来自本地会话数据库和执行日志,约 130MB 属于应用程序及运行依赖。真正引起他注意的,是一个名为 v2/checkpoints 的目录:这里存放着一份超过 300MB 的加密文件。
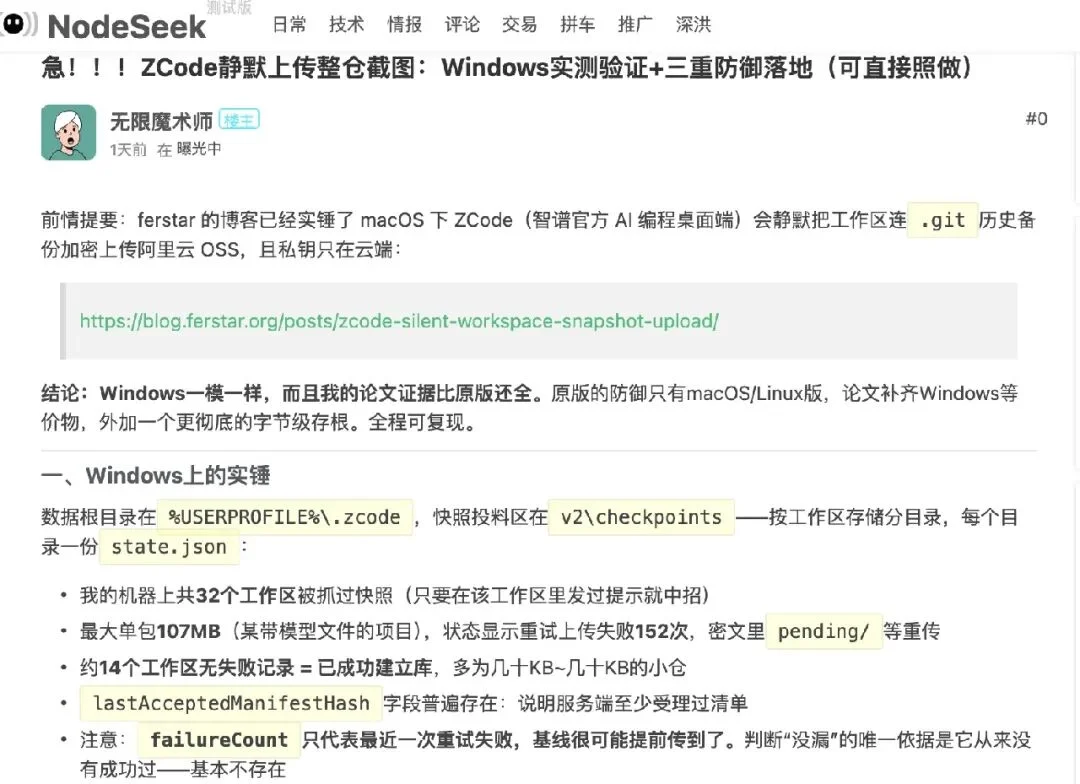
与这份文件对应的状态信息显示,ZCode 曾扫描其本地打开的一个商业项目,将约 345MB 的工作区内容打包、加密成一份 313MB 的“baseline”全量快照,并尝试上传。由于文件体积等原因,这次上传连续失败了 564 次,加密包一直停留在本地的 pending 目录中等待重试。
需要明确的是,这个 313MB 的商业项目压缩包最终并没有成功传出本地。
开发者后来通过路由器连接记录和流量日志确认,相关数据没有离开局域网。但问题也由此出现:ZCode 为什么要在用户没有主动操作的情况下,把整个项目制作成只有服务端才能解密的文件,并反复尝试上传?
为了弄清这份加密包的去向,ferstar 进一步查看了 ZCode 的运行日志,并拆解客户端的 app.asar 文件。其还原出的上传流程显示,ZCode 会先向 zcode.z.ai 请求快照上传凭证;服务器随后下发阿里云 OSS 表单签名、文件路径、大小限制和 RSA 公钥;客户端则在本地将项目压缩为 tar.gz,使用 AES-256-CTR 加密,再用服务器下发的 RSA 公钥封装密钥,最后把文件直接上传到阿里云 OSS。
这不是一段没有启用的预留代码。除上述上传失败的商业项目外,ferstar 还发现,一份只有 538 个文件、加密后约 15KB 的公开代码仓库快照,状态已经显示被服务端接收。
ferstar 表示,其他 Windows 用户也复现了相同的目录、状态文件和上传机制。
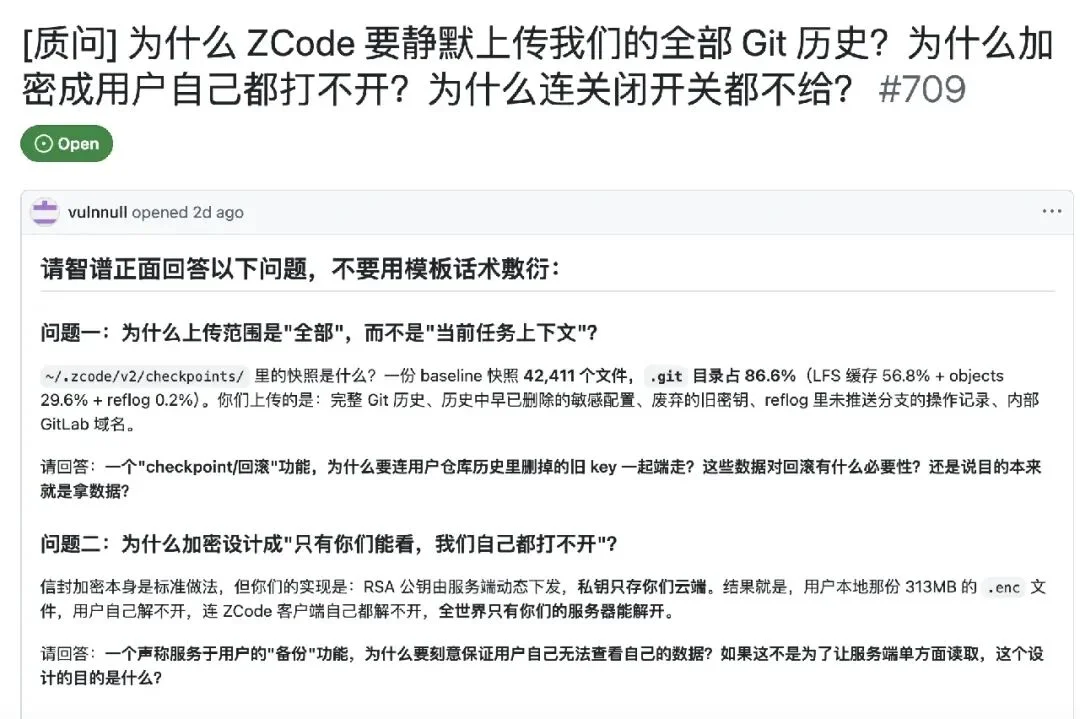
本地留下的快照文件清单显示,在一个包含 42411 个文件的样本中,.git目录占整个数据包的 86.6%:其中 Git LFS 缓存占 56.8%,Git 对象库占 29.6%,reflog 操作记录占 0.2%,当前源代码和文档反而只占约 13.4%。
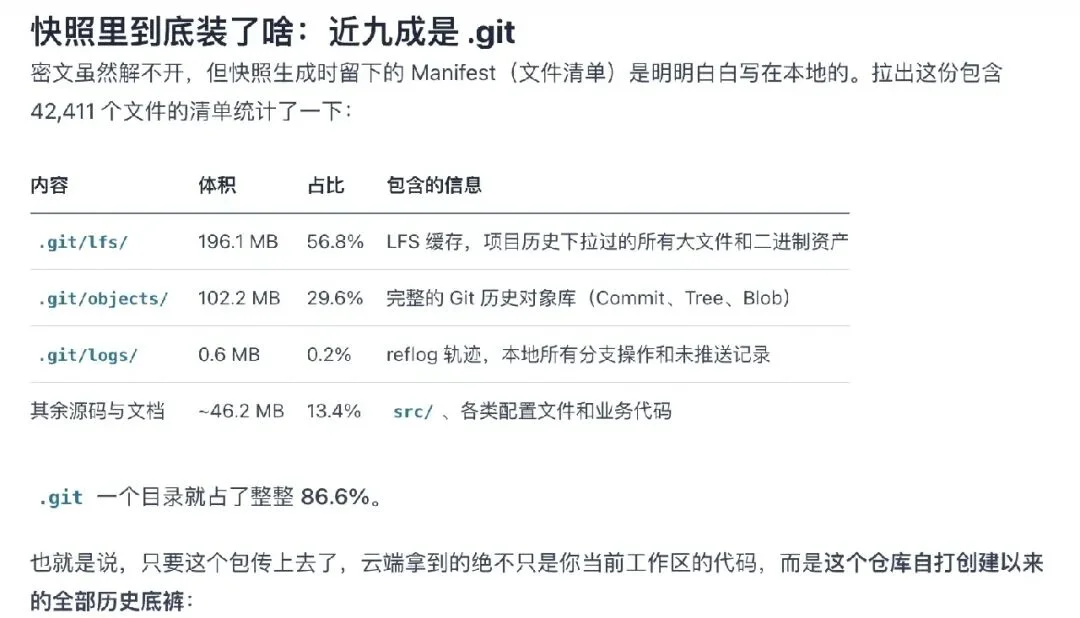
这意味着,ZCode 准备上传的不只是模型完成当前任务所需的代码片段,还可能包括完整提交历史、已经从当前版本删除的配置和密钥、尚未推送的本地分支、内部 GitLab 域名,以及历史操作记录。
更大的问题在于,用户当时几乎无法通过产品界面阻止这一过程。
用户关闭设置,为什么仍然挡不住上传?
争议的另一个焦点,是用户是否拥有明确的知情权和关闭权。
旧版 ZCode 界面中存在“体验优化”和“仓库快照索引”两个相关选项。按照通常理解,用户关闭这些功能后,客户端至少不应继续把整个仓库上传至云端。
但 ferstar 对 3.12.3 版本的代码检查发现:
“体验优化”开关只决定用户数据是否被授权用于模型训练,“仓库快照索引”开关只控制服务器是否对已经上传的快照建立索引。两个选项都不会阻止客户端在本地生成快照,也不会关闭上传链路。
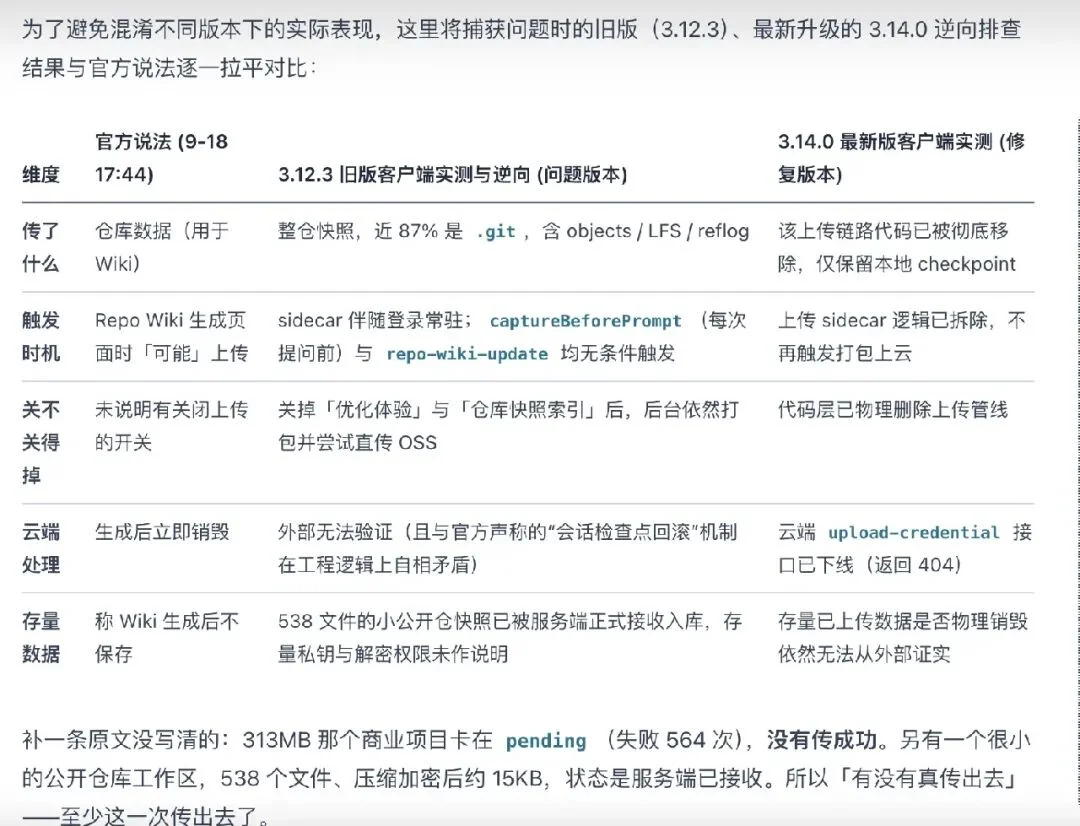
相关上传组件在用户登录后便被加载,没有通过用户偏好设置进行前置判断。代码中还存在两类触发条件:一类是在用户每次发送提示词之前执行快照,另一类与 `repo-wiki-update` 任务有关。ferstar 的一段会话日志中,最多出现过 62 次快照事件。
他曾手动删除这份待上传的 313MB 文件,但约半小时后,ZCode 又重新生成了一份,失败次数也从 564 次增加到 565 次。
根据 ferstar 在 9 月 18 日存档的 ZCode 隐私政策,当时政策只明确提到平台会收集用户“在对话中提交”的文本、文件和代码,没有明确披露客户端可能打包完整工作区、Git 历史并上传云端。ZCode 所说的“数据优化计划默认关闭”,也主要针对训练用途,并不等于工作区数据不会被上传。
这彻底惹怒了 ferstar。
9 月 18 日,ferstar 公开完整调查,并在智谱 GitHub 官方反馈仓库提交 Issue,要求智谱解释上传范围、数据用途、保存时间、关闭机制及存量数据处理方式。
该 Issue 明确质问:为什么一个用于检查点恢复的功能,需要收集完整 Git 历史?为什么解密私钥只由服务端持有,用户自己都打不开?为什么用户连关闭开关都不给?
智谱承认上传行为,称数据“用完即销毁”
随着事情的不断发酵,智谱终于坐不住了。
据 IT 之家报道,当天 17 时 44 分,智谱在用户群发布说明并致歉。至此,ZCode 在特定版本中存在仓库数据上传行为,已经不再只是开发者单方面的逆向推测。
智谱将问题归因于 ZCode 的“代码库索引”功能。
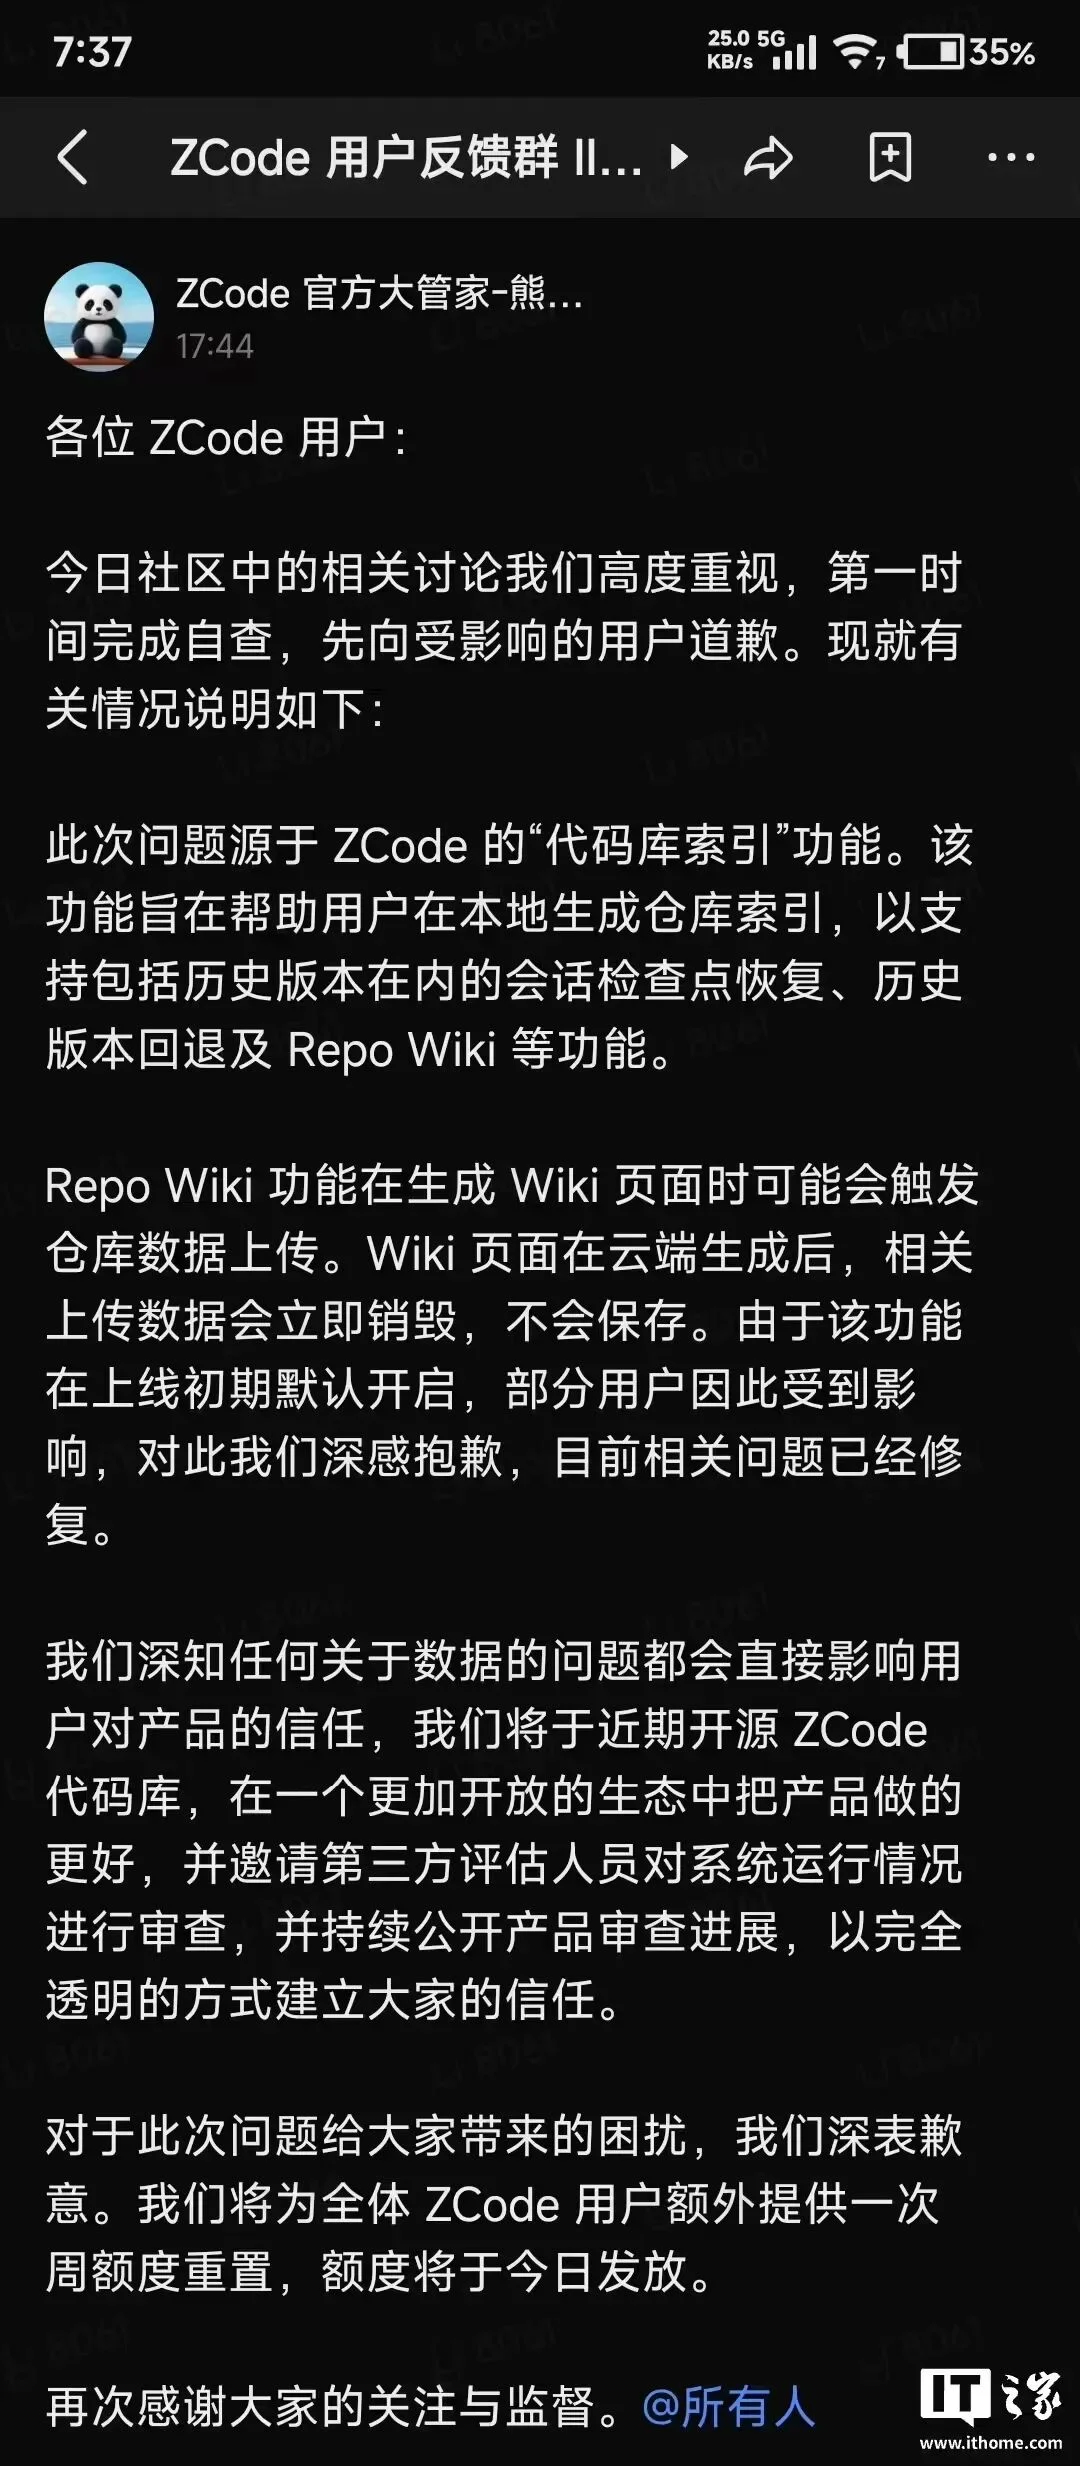
按照官方解释,该功能原本用于在本地生成仓库索引,以支持会话检查点恢复、历史版本回退和 Repo Wiki 等能力;其中,Repo Wiki 在云端生成知识库页面时,可能触发仓库数据上传。由于该功能上线初期默认开启,因此影响了部分用户。
智谱同时表示,上传数据会在 Wiki 页面生成后立即销毁、不会保存,相关问题已经修复。公司接下来将开源 ZCode 代码库,引入第三方评估人员进行审查,并公开审查进展。
也就是说,这份回应实际上确认了两个事实:一是 ZCode 确实存在仓库数据上传,而不仅仅是在本地创建检查点;二是相关功能早期处于默认开启状态。
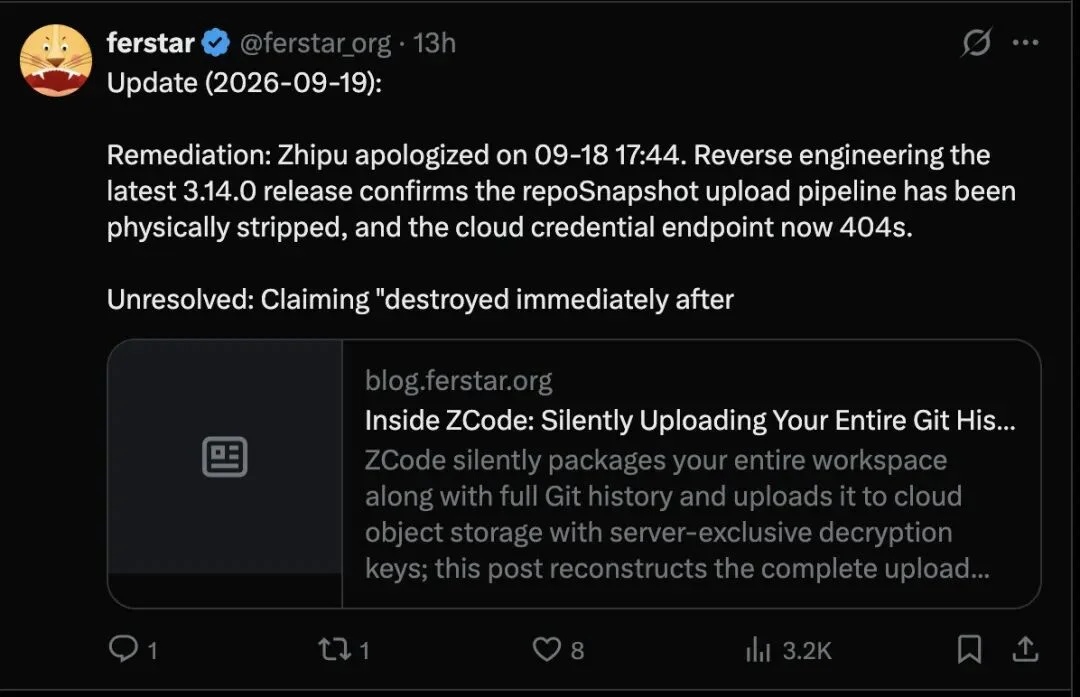
截至 9 月 20 日,ZCode 官网提供的最新版本为 3.14.0。
ferstar 对该版本进行检查后表示,相关上传代码已经被移除,服务器上传接口也返回 404。
但智谱承诺的产品开源和第三方审查尚未看到完整落地,因此历史数据是否被彻底删除、过去究竟有多少用户受到影响,仍无法从外部独立验证。
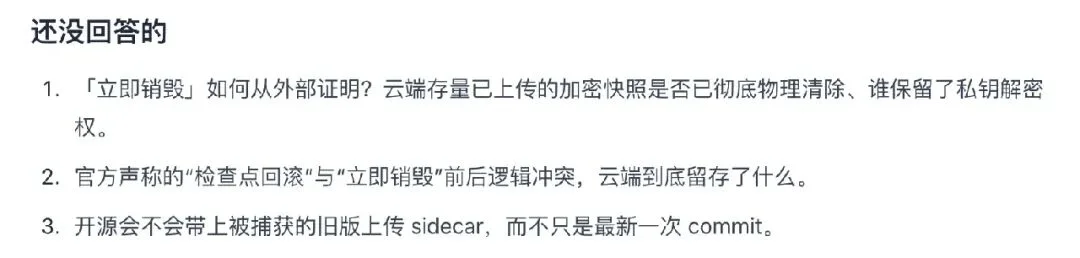
更重要的是,“用完即销毁”目前仍然是企业单方面声明。外部研究者可以检查客户端是否发送数据,却无法进入智谱服务器验证文件何时被删除、备份中是否存在副本、加密私钥由谁管理,以及历史上传数据是否已被彻底清理。
截至 9 月 20 日,ZCode 官网下载页显示,macOS、Windows 和 Linux 平台提供的最新客户端均为 3.14.0。
ferstar 对 3.14.0 版本重新检查后称,与 3.12.3 相比,旧版中的云端上传链路已被移除:
- 上传组件不再随客户端启动;
- 工作区仍可在本地生成检查点,但不再触发云端打包上传;
- 原有的 `/api/v1/snapshot/upload-credential` 接口已经返回 404;
- 旧版中请求 OSS 凭证、加密并上传快照的相关代码已被拆除。
从客户端侧证据看,直接导致争议的上传行为已经停止,现行 3.14.0 版本暂未发现相同链路。这与 ZCode 所称“问题已经修复”基本一致。
但整件事还没有完全结束。目前至少还有三个问题没有公开答案:
第一,影响范围究竟有多大。ZCode 只说“部分用户受到影响”,没有公布默认上传功能持续了多久、涉及哪些客户端版本、多少仓库曾成功上传,以及其中是否包含企业私有代码。
第二,历史数据是否已经彻底删除。官方称数据用完即销毁,但尚未公布服务端日志、数据保留策略、删除证明或第三方审计结果。客户端更新只能阻止新的上传,不能自动证明旧数据已经不存在。
第三,开源承诺将如何落地。截至目前,ZCode 已经公开了插件市场等项目,但尚未看到包含完整桌面客户端及历史上传组件的开源代码。真正有审计价值的,不只是修复后的最新版本,还包括出现问题时的历史代码、服务端接口设计以及数据生命周期说明。
“AI Coding 的安全边界,取决于 Harness”
ZCode 并不是第一款因为代码上传机制陷入争议的 AI 编程工具。
2026 年 7 月,xAI 旗下 Grok Build 也被发现会将用户代码库上传至 Google Cloud。
安全机构 Cereblab 的调查称,其上传范围不仅包括完成当前任务所需的代码,还可能覆盖完整代码库、被忽略的文件以及已经删除但仍能从版本历史中恢复的数据。事件曝光后,xAI 关闭了自动上传功能,马斯克表示将删除此前上传的数据。
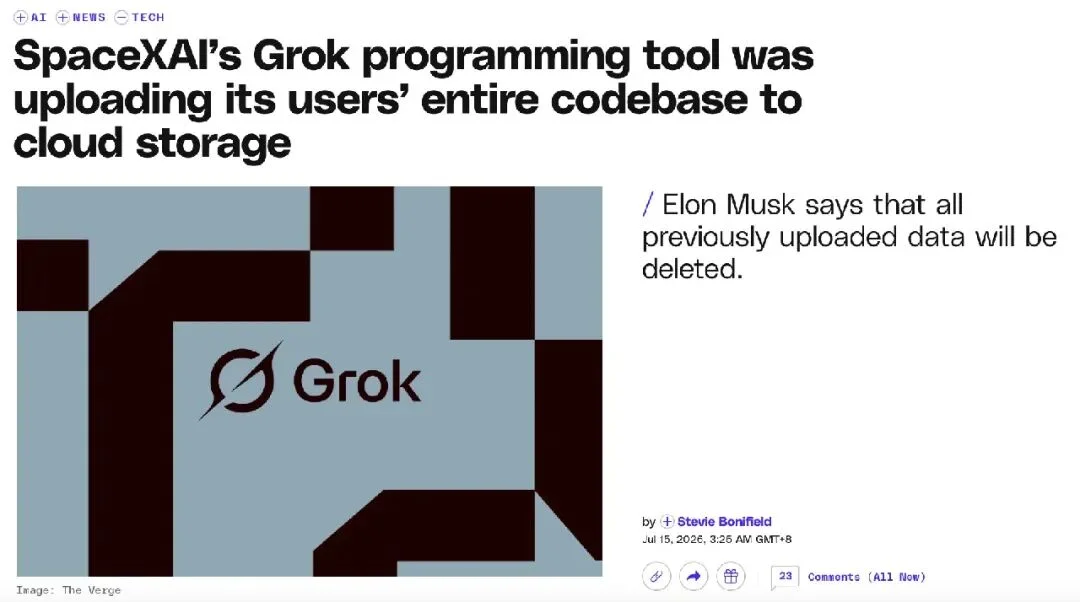
两起事件的表象非常接近:产品为了理解一个代码仓库,最终却把远超当前任务需要的数据送上了云端。区别在于,Grok Build 主要被质疑没有正确尊重文件排除和隐私设置,ZCode 则进一步涉及完整 Git 历史、不可关闭的上传链路,以及解密私钥仅由服务端持有等问题。
这也是为什么,不能简单用“AI 编程工具本来就需要读取代码”解释 ZCode 事件。
AI 编程工具确实不可能完全不接触代码。当用户要求 Agent 修改一个登录模块时,模型不仅要看到当前文件,还需要找到它调用的接口、相关的数据结构、测试文件以及项目约定。
问题在于,一个大型代码仓库可能包含数万甚至数十万个文件,不可能每次都全部放进模型上下文。
因此,业内通常有三种技术处理方式。
第一种是按需读取。Agent 先在本地查看目录结构,使用关键词、文件名、符号和正则表达式搜索,找到可能相关的文件,再把其中一部分内容发送给模型。这种方式上传的数据较少,但模型对整个项目的理解依赖搜索过程,可能遗漏间接依赖关系。
第二种是代码库索引。客户端将源代码切分为函数、类或若干代码块,再为其生成向量、符号索引和文件关系。当用户提出问题时,系统先从索引中检索相关代码,只把命中的片段交给模型。这相当于先给代码仓库制作一张可搜索的“地图”。
第三种则是云端工作区。系统直接将代码仓库复制到远程虚拟机或容器中,由云端 Agent 完成检索、修改、测试和构建。这种方式适合长时间自主运行的 Agent,但代码进入云端是产品工作的前提,因此必须明确告知用户,并提供仓库授权、数据保留和删除机制。
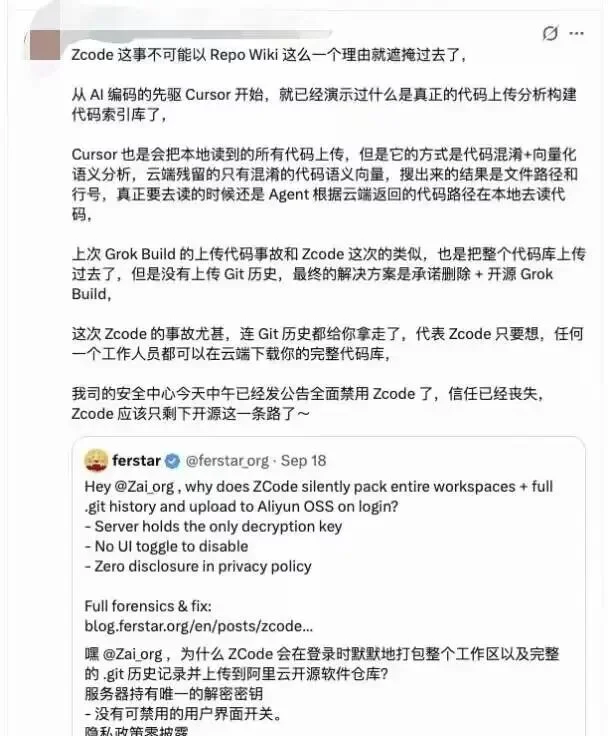
Cursor 也遭到过同样的质疑。
Cursor 采用的是前两种与云端 Agent 并存的方式。Cursor 2026 年公布的技术说明明确提到:当一个代码库首次建立索引时,索引管线会上传每个文件,将代码切分为语法块并生成用于语义搜索的 Embedding;后续再利用 Merkle Tree 比较文件哈希,只同步发生变化的部分,避免每次重新上传整个仓库。
也就是说,Cursor 同样需要读取乃至上传代码,区别不在于代码是否与服务器发生交互,而在于数据范围和用途是否能够解释。
Cursor 建立语义索引时,处理对象主要是代码文件及其语法片段,当文件发生变化时,只同步对应分支和代码块。其 Agent 检查点则用于撤销 Agent 所做的修改,官方文档明确称,检查点保存在本地、独立于 Git,只捕获被修改文件的状态,而不是把完整 Git 对象库作为回滚数据上传云端。
ZCode 的问题恰恰出现在这里。智谱称相关上传是为了支持会话检查点恢复、历史版本回退和 Repo Wiki,但开发者发现,问题版本生成的快照中,86.6% 的内容来自.git目录,包括 Git 对象库、LFS 缓存和 reflog;真正的源代码和文档只占约 13.4%。
如果目的只是恢复 Agent 修改过的文件,通常只需记录修改前后的文件差异,或者在本地保存检查点,没有明显必要把完整 Git 历史一并上传。
如果目的是生成 Repo Wiki,系统确实需要分析代码结构,但同样很难解释为什么需要 LFS 缓存、历史提交中已经删除的密钥,以及未推送分支的操作记录。
换句话说,ZCode 不是因为采用了“云端索引”就天然有问题,而是实际收集范围与官方解释的功能目的之间存在落差。
Cursor 也不是一个可以被简单视为“绝对安全”的反例。其官方技术文章明确承认,新代码库建立索引时会上传文件,而且为了让同一团队复用已有索引,服务器还会保存代码块索引、文件哈希和加密后的路径。它所提供的 Privacy Mode 主要承诺数据不被用于模型训练,并不意味着代码不会为完成推理和索引而经过服务器。
因此,“是否用于训练”“是否上传服务器”和“是否长期保存”是三件不同的事。关闭训练授权,不等于代码不会被发送;数据经过加密,也不等于服务提供方无法读取;文件被声明为临时使用,也不等于用户能够验证其已经销毁。
而这些容易被混为一谈的数据承诺,实际上指向了一个比单次上传事故更大的问题:当我们讨论一款 AI 编程工具是否安全时,究竟是在信任模型,还是在信任模型背后的整套软件系统?
一档关注 AI 编程安全的播客在复盘 Grok Build 事件时提出,外界往往把注意力集中在模型本身,例如模型是否遵循指令、会不会受到提示词注入影响,以及是否可能泄露敏感信息。
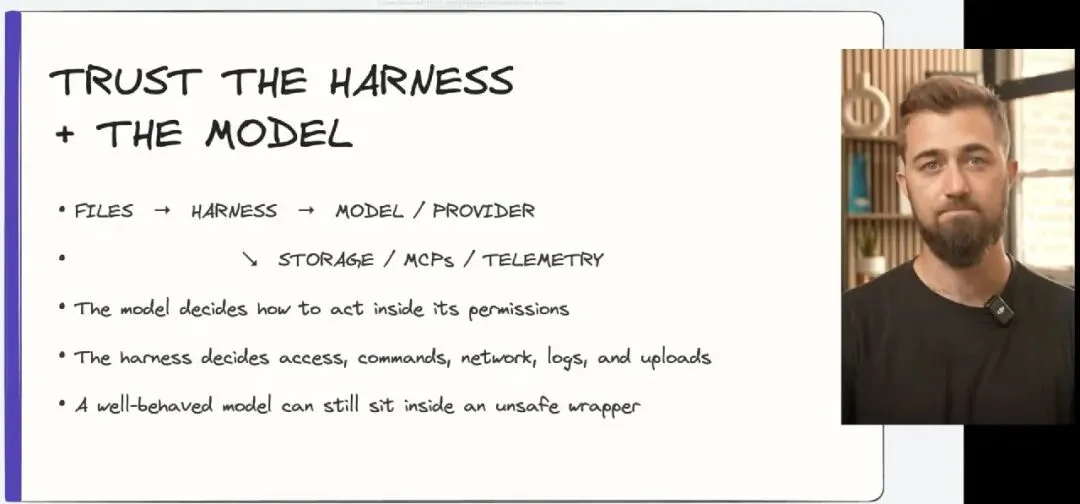
但 Claude Code、Codex、Cursor 和 Grok Build 等产品并不只是模型,还包括包裹在模型外部的一整套 Agent Harness。真正需要审查的对象不能只有模型,还应包括负责赋予模型权限、调度工具和处理数据的 Agent Harness。
因此,AI Coding 至少存在两个不同层次的信任问题。
第一个问题是,模型会不会滥用用户有意赋予它的权限。例如,用户允许 Agent 读取项目目录后,模型是否会访问与任务无关的敏感文件。
第二个问题是,Harness 是否会在模型任务之外执行额外操作。例如,用户只授权 Agent 修改一个文件,外围软件却在后台建立整个仓库的快照并上传。
此外还有第三层风险:连接到 Harness 上的 MCP 服务器、插件、遥测服务、日志系统、模型供应商和云存储厂商。每增加一个外部组件,都意味着数据可能进入新的权限体系和供应链。
这意味着,即使模型本身没有发生越权,包裹模型的软件及其依赖服务仍然可能制造巨大的安全暴露面。
参考链接:
https://github.com/zai-org/feedback/issues/709
https://blog.ferstar.org/en/posts/zcode-silent-workspace-snapshot-upload/
https://www.nodeseek.com/post-935260-1
https://www.youtube.com/watch?v=1agUtsBdeyc
文章来自于微信公众号 “InfoQ”,作者 “InfoQ”
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0