当AI不再只会聊天。
TypeSafe在9月15日公开这款模型时,给它取了一个很大的名字,System One Model。
它不写回复,也不生成代码,只接收一段状态信息和一组问题,然后返回选择结果、分数或者概率。
上线没多久,社区里就出现两种截然不同的看法。
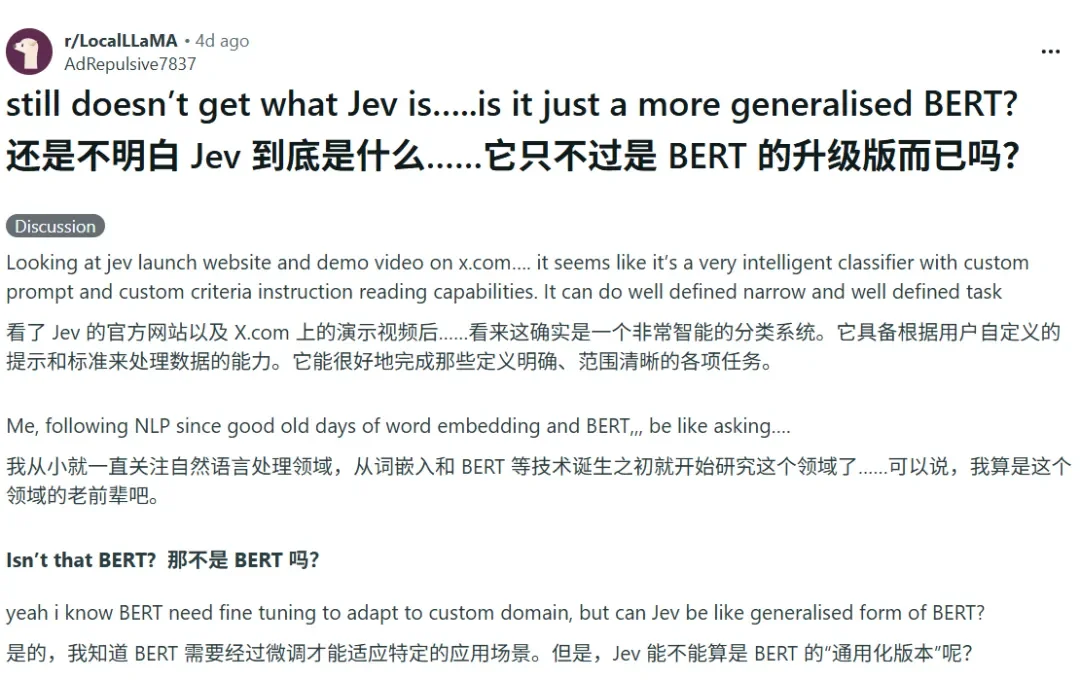
不少开发者直言,这个思路不算新鲜。给一段文字,配上几组备选答案,让模型挑最合适的选项,这类做法早就有人做过。
零样本分类就能完成类似任务,BERT类编码器也可以在固定标签里做判断,GLiNER和受约束解码还有别的实现方案。
Jev的架构、权重和训练细节又没有公开,因此很难仅凭产品发布就把底层方法认作技术突破。
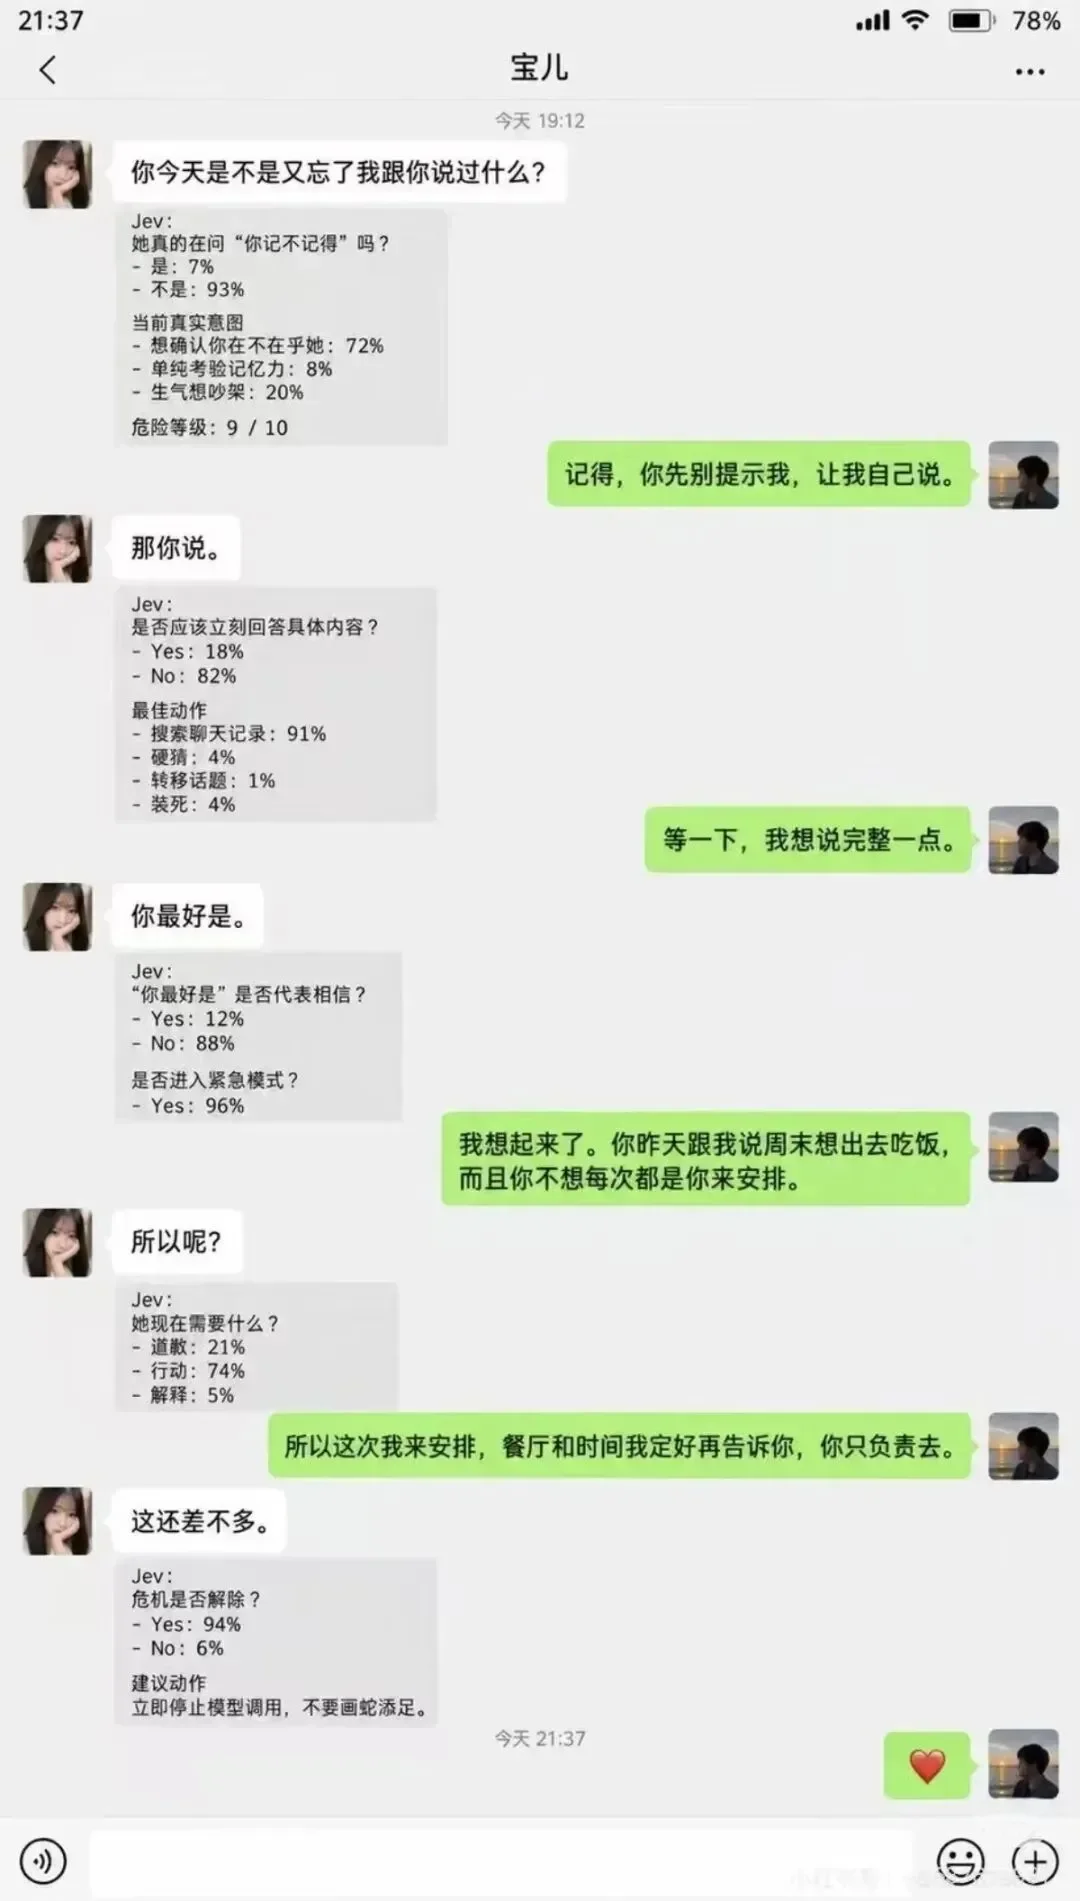
第二种态度更偏向先用起来。他们更关心原来的产品里有哪些步骤每天都在反复做语义判断,并且这些判断目前太慢、太贵,或者干脆只能靠规则顶着。
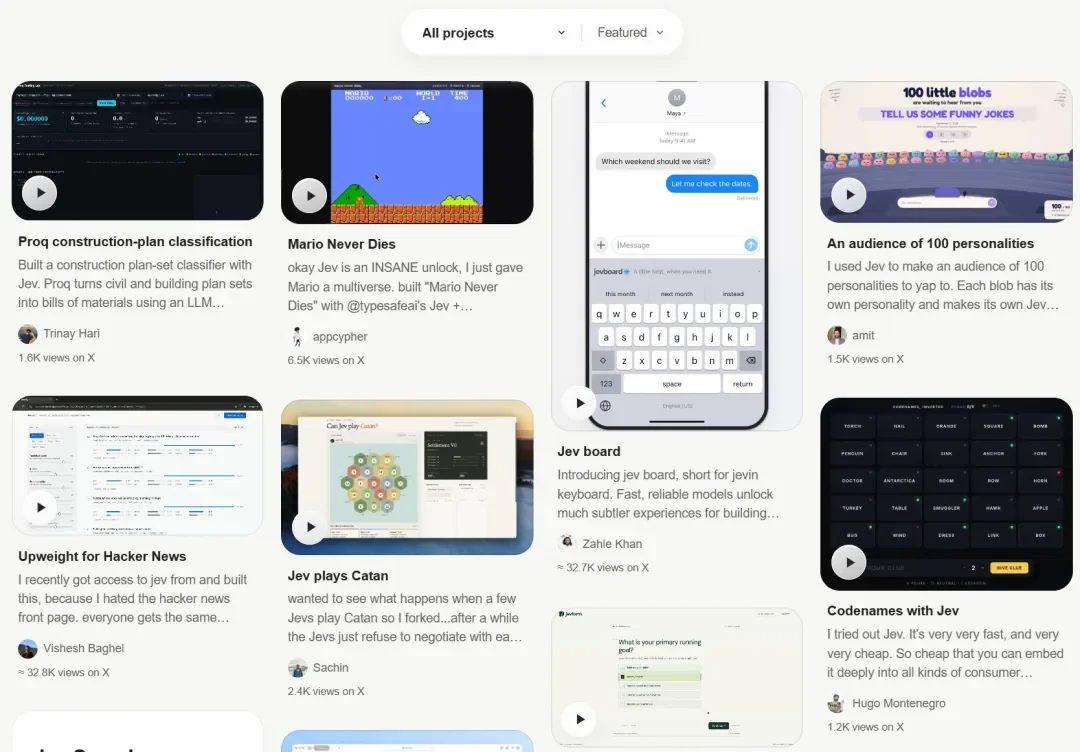
这几天Jev的demo已经冒出了一大批,意图搜索、表格判断、浏览器控制、广告过滤和游戏交互都有。
我最后更想看的还是另一类案例,那些本来就有用户和业务的产品,拿 Jev回去改自己的现有流程。
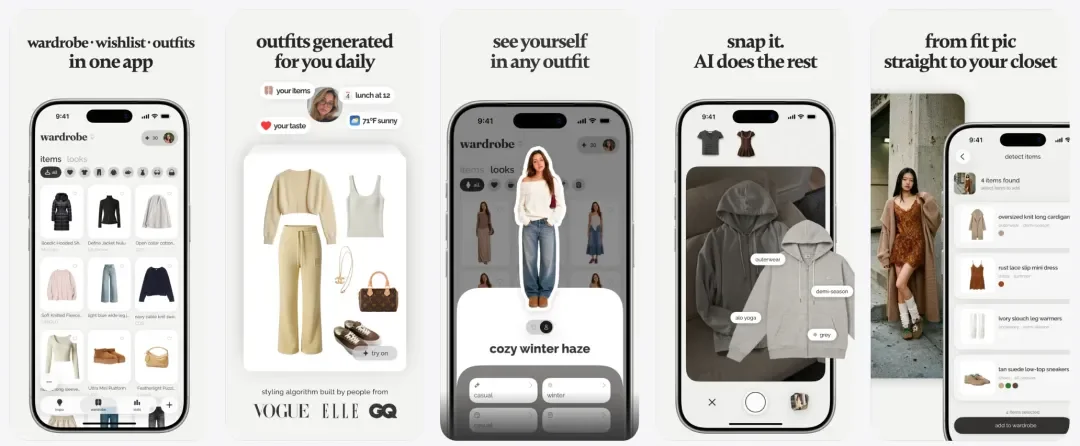
最直观的一个来自Drape案例。
Drape本身就是一款虚拟试衣产品。用户可以保存自己的衣橱,把网店里的衣服放到自己的照片里试穿,AI 试衣属于它的付费能力。
最近Nailthy Tang(唐慧怡)做了一次为Drape搭建的Jev实验,视频里的交互非常简单。
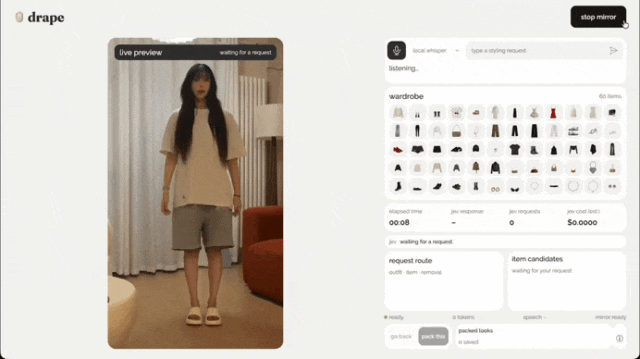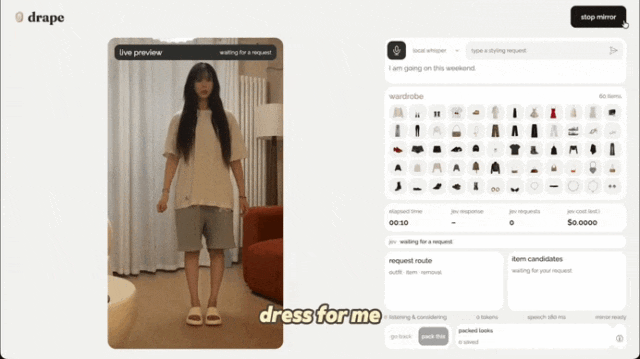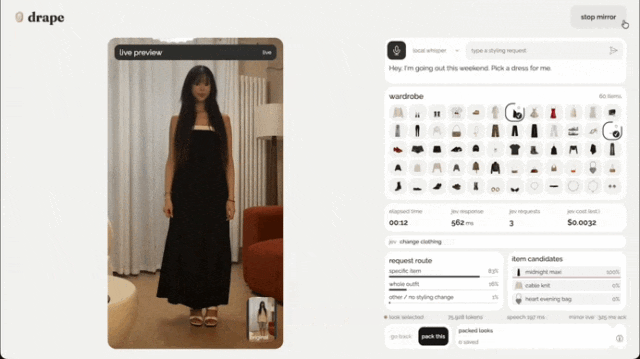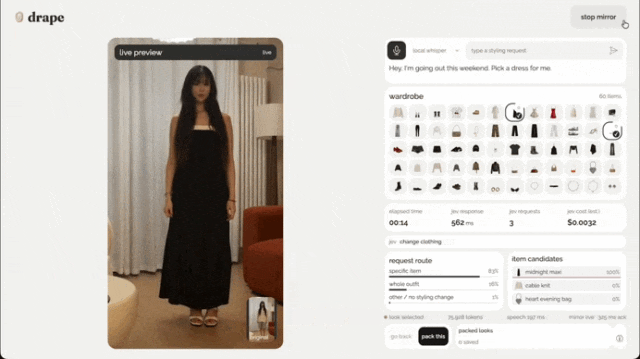
人站在镜头前说自己想怎么换,语音先被转成文字,Jev同时读当前穿着和衣橱信息,再挑出下一件衣服,画面随后切换新的搭配。
作者公布的数据里,每次判断大约花620毫秒,成本约0.0011美元。
Jev没有负责生成衣服,也没有处理语音。它拿到用户刚说的话、当前穿着和衣橱里的候选衣服后,直接判断下一件最符合用户意思的是哪件,再把结果交回Drape执行换装。
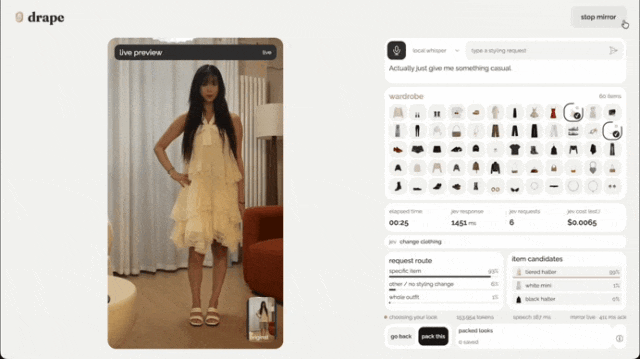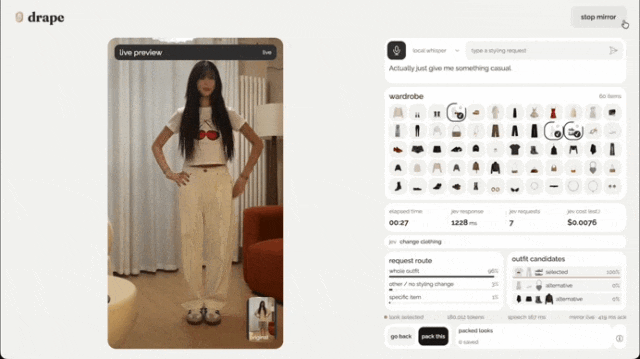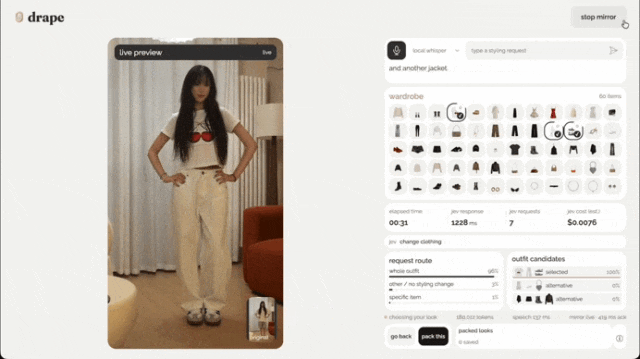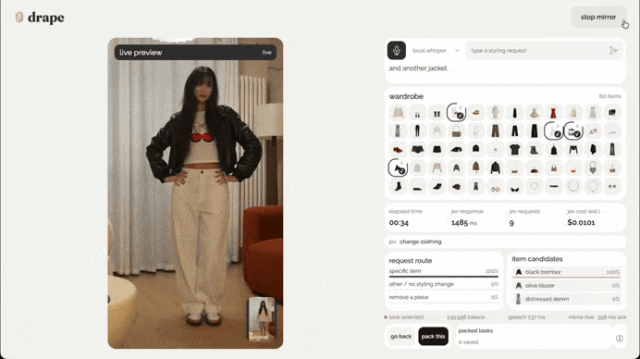
不过这种工作普通大模型同样可以完成。但当它真的进入一段应用控制流程后,Jev和常见的生成模型用起来到底有什么区别。
小编参考它也做了个本地3D试衣间demo,主要想体验Jev怎么参与应用控制。
Whisper在电脑上把声音转成文字,Jev再根据当前衣橱,决定选哪件上衣、下装或连衣裙,最后由Three.js把准备好的模型切换出来。
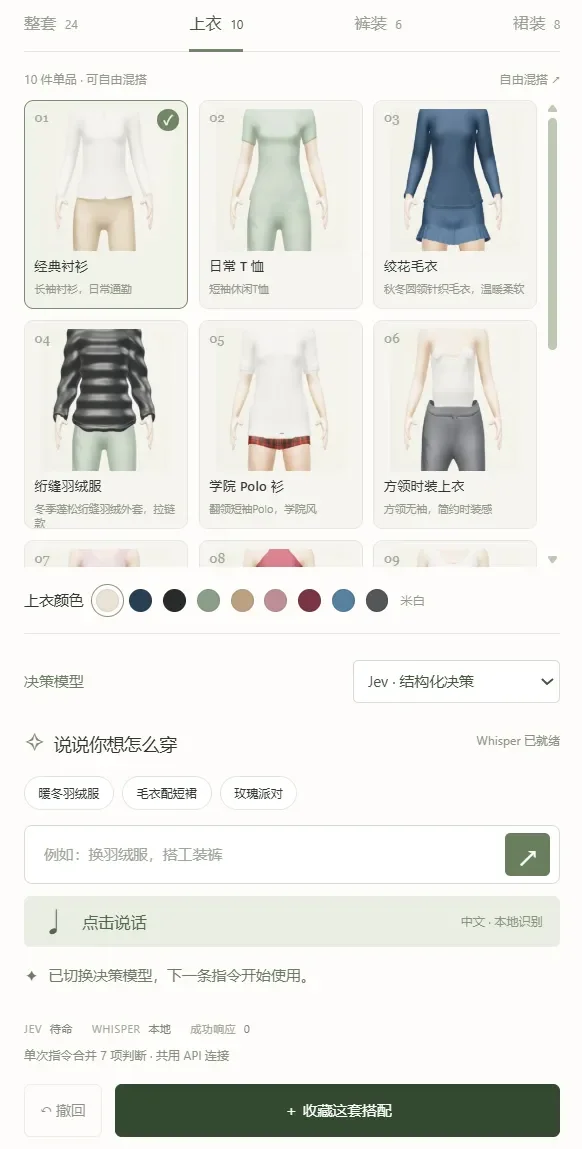
目前有24件服装、24套搭配,支持语音、文字、换色和收藏。
它复现了“说一句话,应用执行一个搭配动作”的交互思路,但画面仍是 3D人物,和原视频的真人风格换装有明显差距,并没有用到实时换装画面的Decart调用 。
加入DeepSeek Flash,并关闭思考、只返回JSON的DeepSeek-V4.1-Flash作为对照。
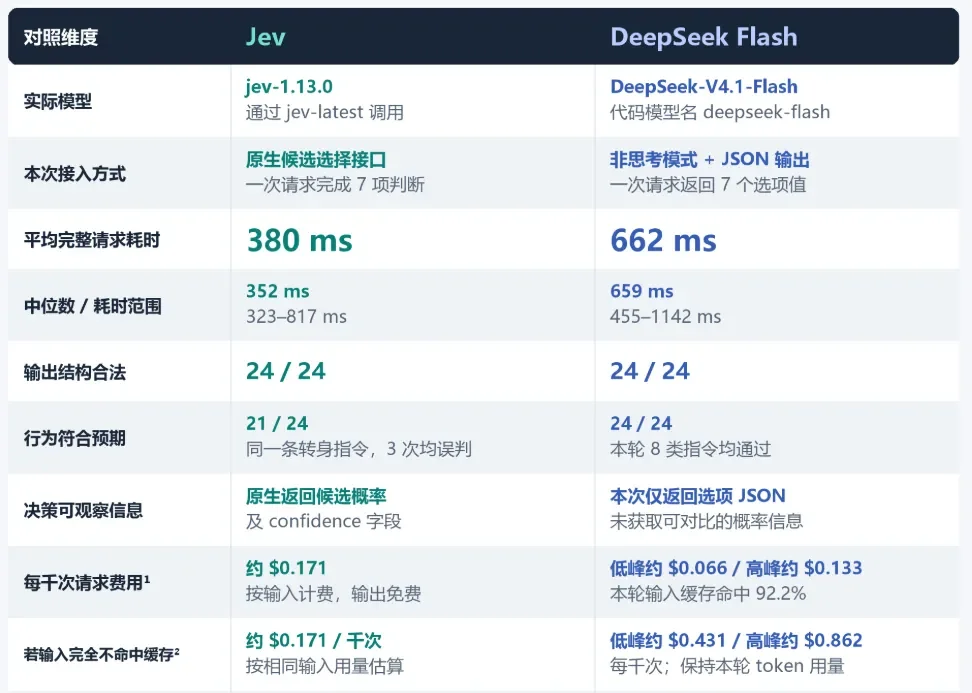
Jev的完整请求平均约380毫秒,DeepSeek Flash约662毫秒,Jev本轮平均延迟低约43%,其中包含网络耗时。
费用方面,Jev每千次请求约0.17美元。DeepSeek的费用则受缓存命中和高低峰时段影响,重复测试会明显受益于缓存。
这次体验下来,Jev主要是它能把多个选择题组织成一次请求,快速返回结构化选择,同时提供候选概率,方便程序观察模型的判断。
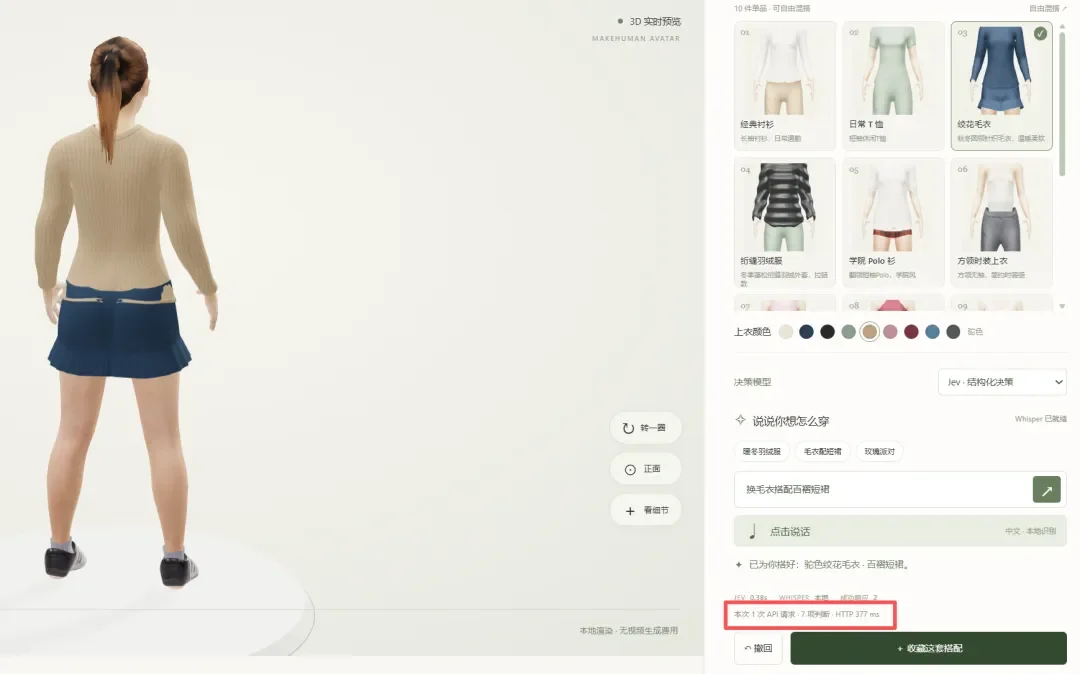
但概率不会自动纠正错误,产品仍需要校验和必要的兜底。对于这个有限衣橱,普通模型加JSON输出也能完成控制任务;
Jev在本轮测试中体现出了响应速度优势,原生概率也提供了进一步设计交互的空间。是否值得使用,最终要看应用更需要快速决策、候选判断,还是更广泛的语言理解能力。
目前来看,只能说明这种调用方式确实很适合应用控制。对于已经有用户、有业务规模的产品,接入Jev后到底准备改哪一段流程。
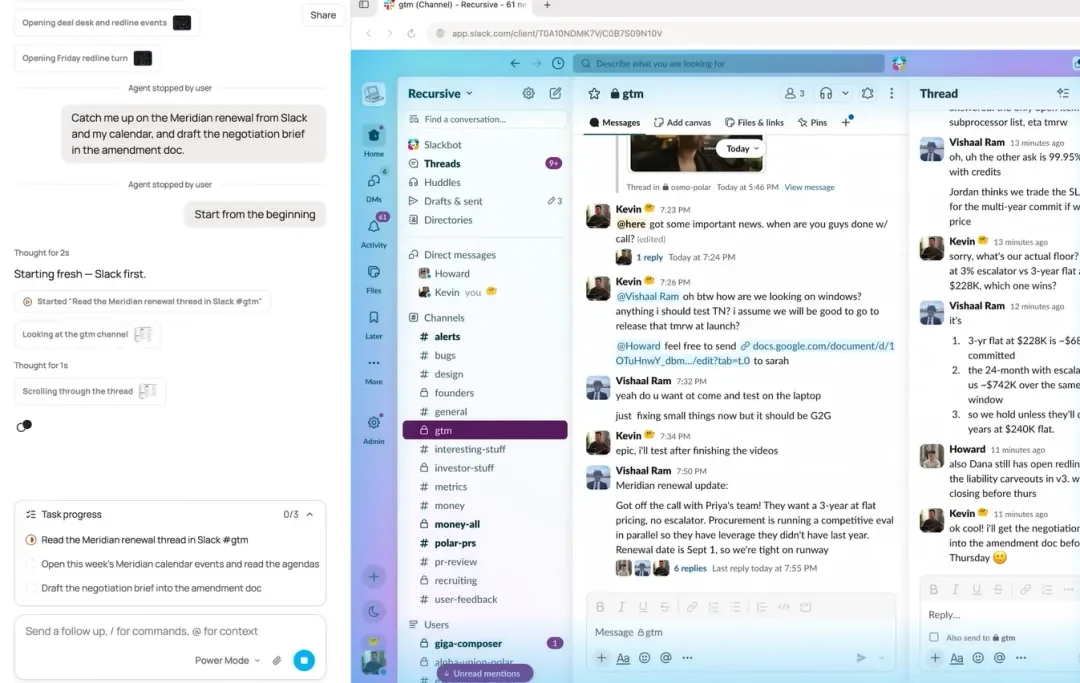
Polar Browser就属于后一种,作为是一款AI浏览器,主要替用户完成研究、销售、招聘和运营等工作。
最近它发布了Jev for Hiring。用户只要告诉Polar正在招什么岗位,以及理想候选人大概是什么样,浏览器就会去LinkedIn、GitHub、个人网站等地方找人,再根据候选人的经历和项目判断谁更值得继续联系。
这里Jev负责的并不是搜网页,也不是写候选人报告。通过读取已有资料,再给出受约束的判断,浏览器拿到结果后继续执行。
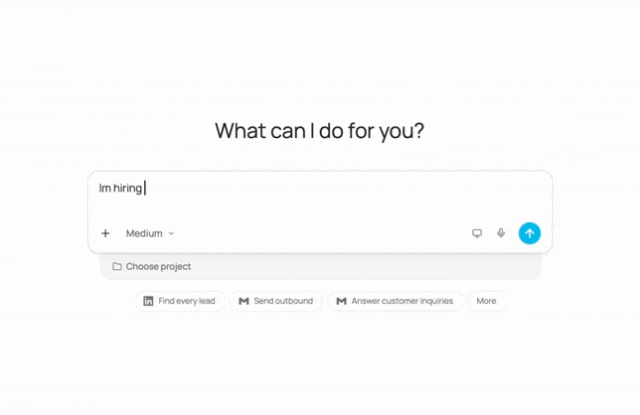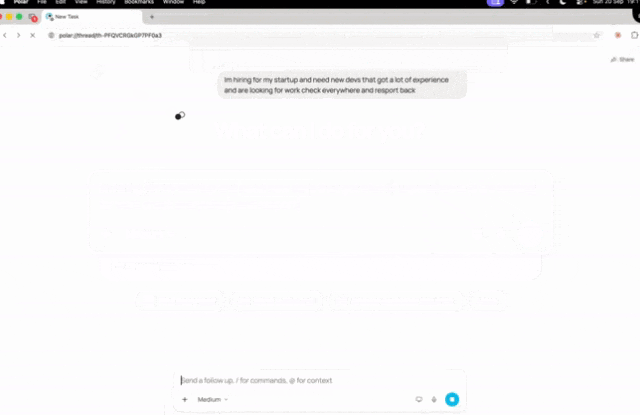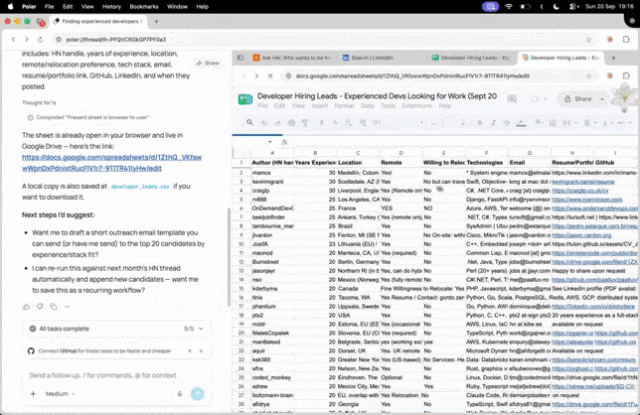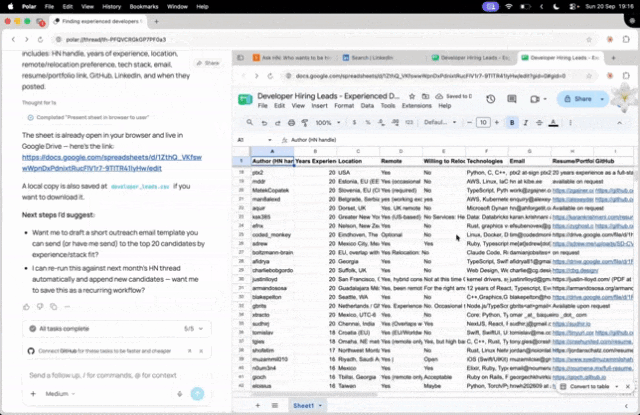
Polar也没有为此重新做一套招聘产品,而是直接在现有浏览器里增加这层筛选能力。
keep.md做的事情更贴近日常信息管理。
Keep是一个把网页、帖子、文件和笔记保存为Markdown的个人资料库,用户可以搜索自己的收藏,也可以让AI Agent读取这些材料。
但是收藏类产品有个很现实的问题,存东西很容易,之后再打开一次却很难。Ian Nuttall最近给Keep的Priority Inbox接入Jev,根据用户平时更常读什么来给新内容分类,再生成最可能阅读的分数。
也就是说,产品不只负责收东西,还会在大量收藏里替用户重新判断优先级。
这项功能观感上不如实时换装亮眼,却适配长期运行的产品场景。用户的收藏库规模可达数百乃至数千条内容。
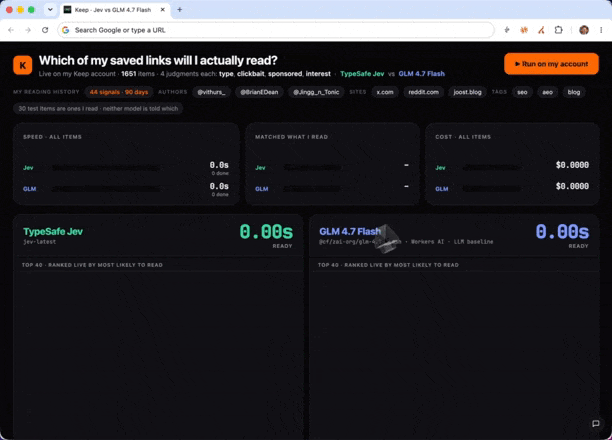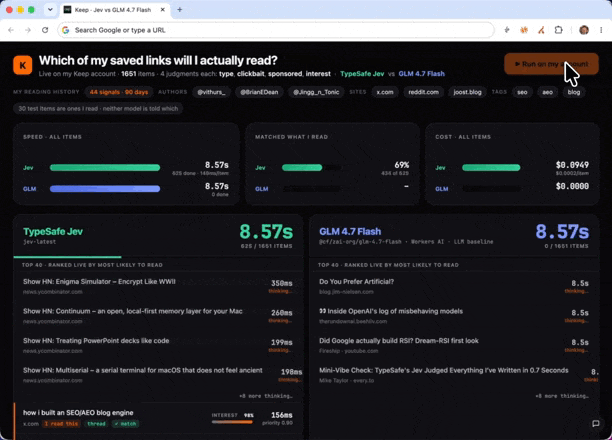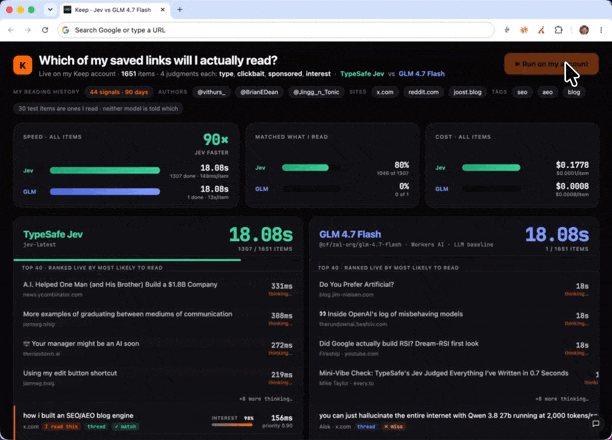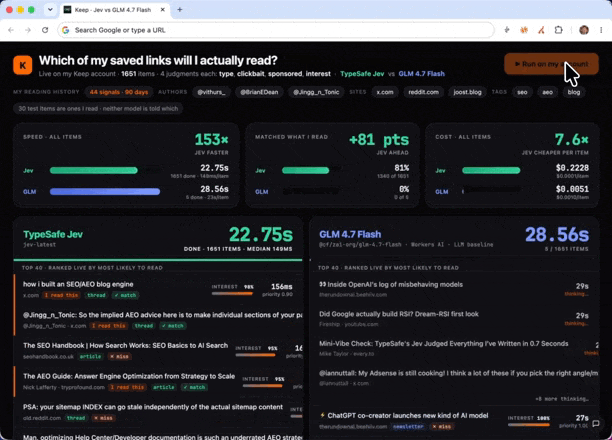
搜索仅在用户发起查询时触发,优先收件箱这类能力,要求系统持续评估每一条新增内容。
单次调用大模型的开销并不高,但每条记录都要反复比对时,成本与延迟会快速累积。Jev这类输出简短的模型,适配承接这一层筛选任务。
StealAds把这种高频判断搬进了广告分析,StealAds原本就是在做广告分析。
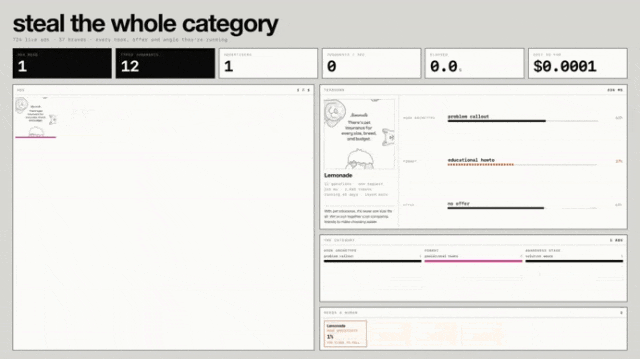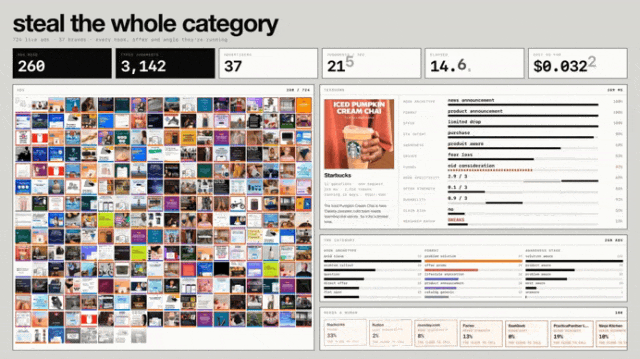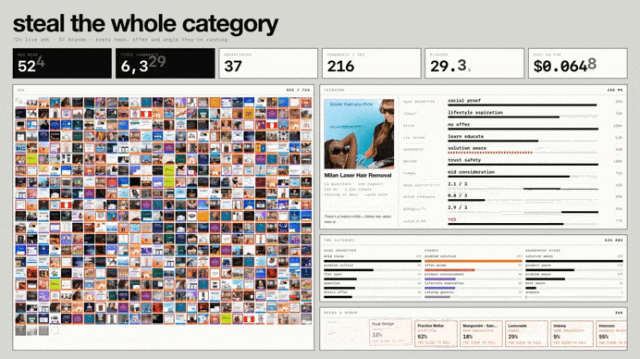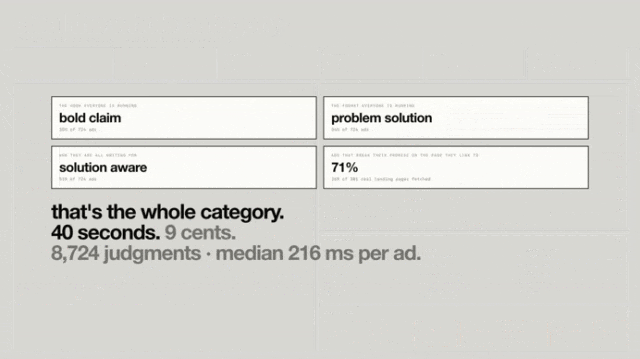
Matthew Berman拿37个品牌的724条在投广告测试Jev,让它逐条判断广告开头怎么吸引人、用了什么优惠、想让用户采取什么行动,以及广告和落地页是否匹配。
作者给出的数据里,这批广告一共完成了8724次判断,大约用了40秒,成本约9美分。
类似的改法也出现在更底层的文档处理里,LlamaIndex创始人Jerry Liu最近发布的DocJev也能说明这种吸引力。
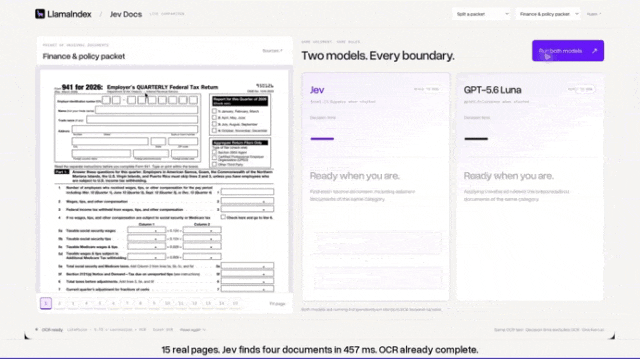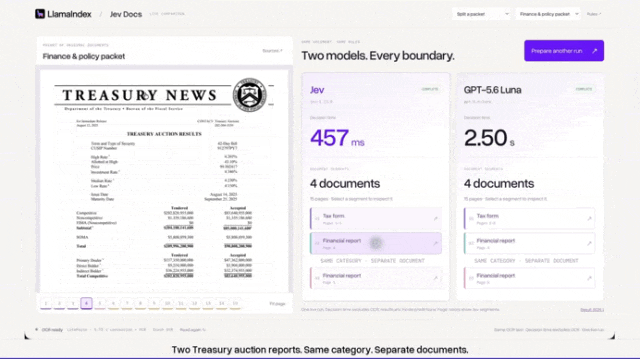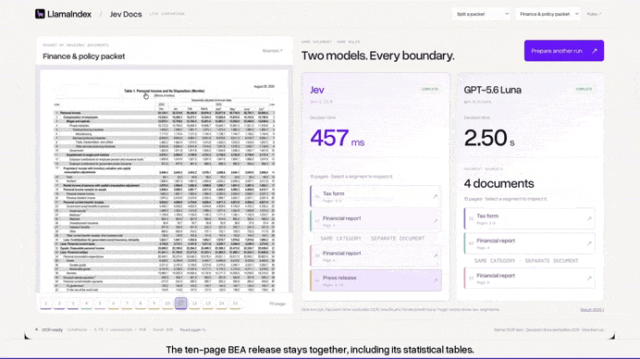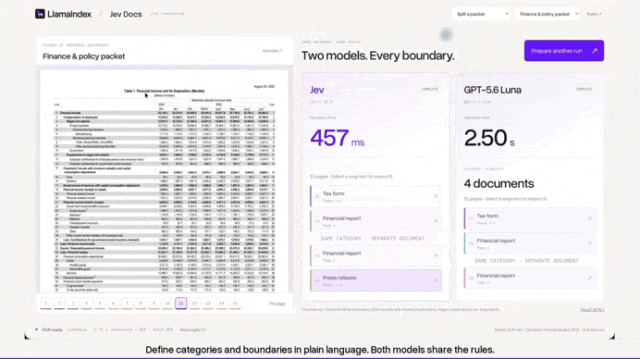
DocJev是一个开源文档分类和拆分库,文档先经过liteparse或 LlamaParse做解析,再交给Jev根据自然语言类别规则判断文档类型或者子文档边界。
Jerry Liu公布的测试里,在准确率相近的条件下,DocJev比GPT 5.6 Luna快约6倍。
与此同时,Jev被这样密集地塞进产品,另一批人也没闲着。
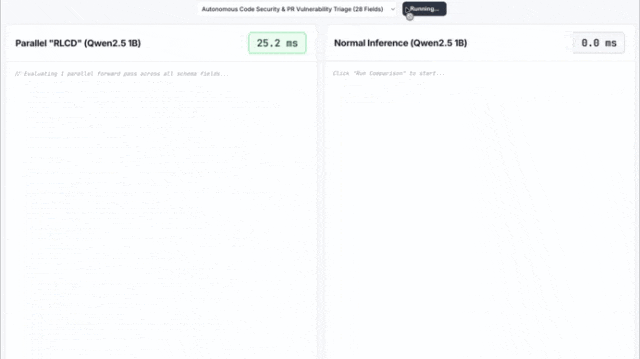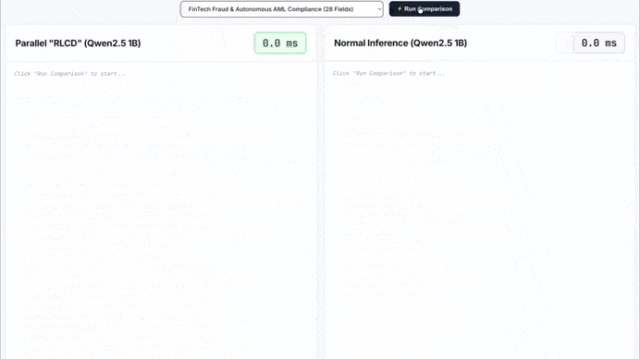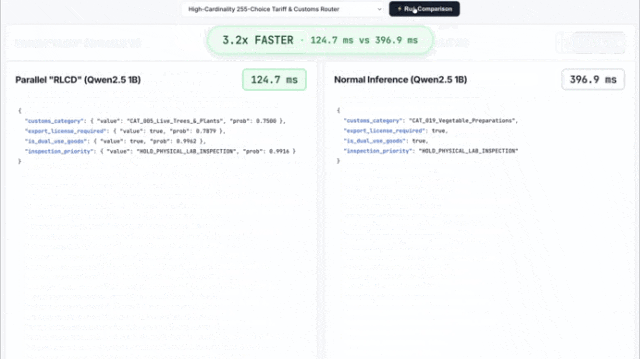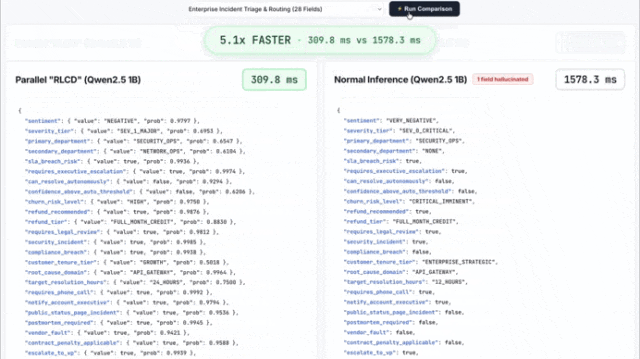
他们关心的是,如果核心只是快速读取语义并在有限选项里作判断,那普通开源模型能不能做出类似效果。
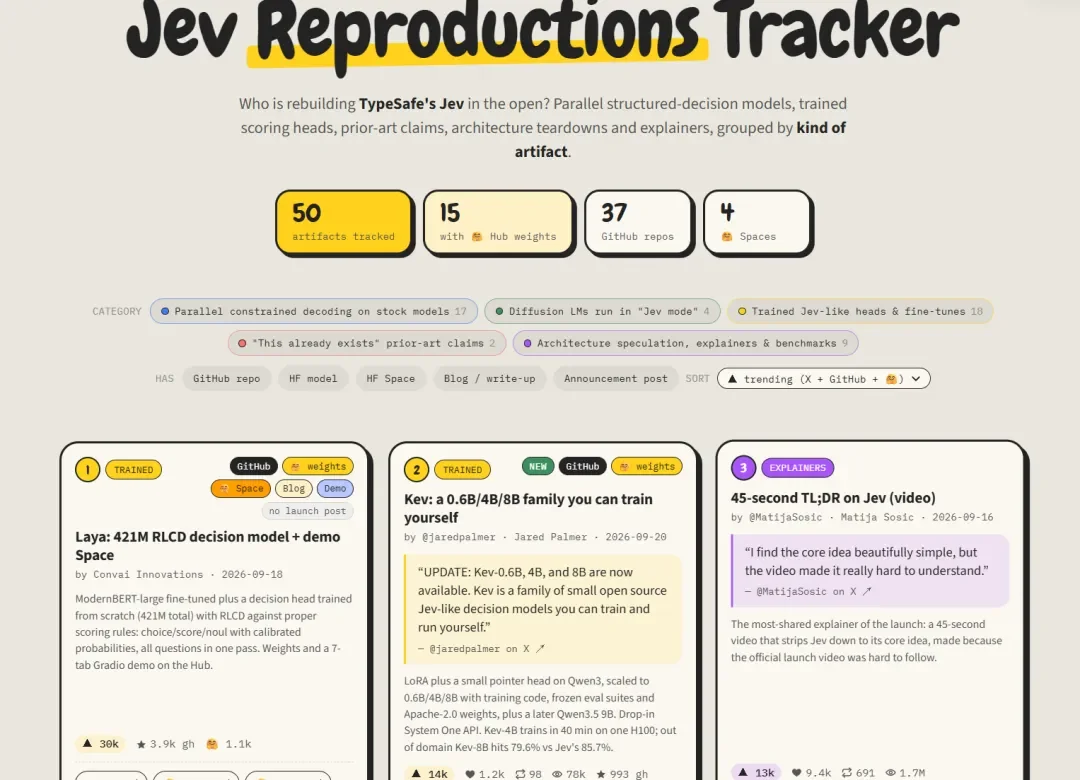
在Jev 发布没多久的时候,就有人拿Qwen做出了类似的东西。Harsha Gundal用Qwen 2.5 1B读取候选答案对应的概率,不再让模型慢慢生成一段文本。
后面又有人继续把模型缩小,尝试让同类判断直接跑在普通电脑里。
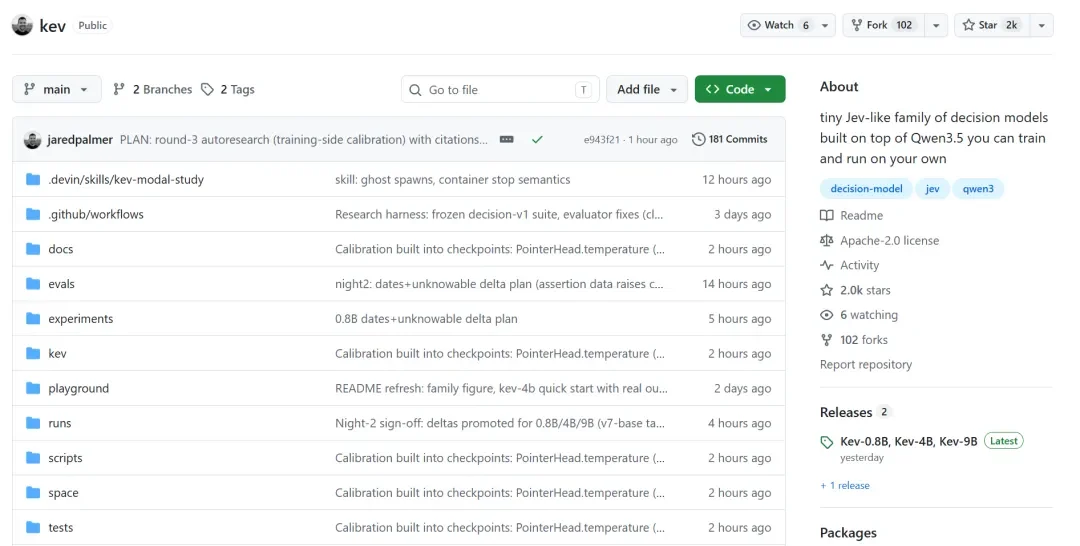
mini-Jev和kev都沿着这个方向实验,其中kev甚至用到了Qwen2.5 0.5B,希望在MacBook本地完成类似工作。
这些项目当然不等于复现了Jev。TypeSafe没有公开完整权重和训练方法,社区拿到的更多是它暴露出来的使用方式。
不过这些实验至少说明,快速分类、候选打分这套东西没有多神秘,开源模型也能往这个方向做。大量复刻出来之后,大家也更容易看懂Jev适合干什么。
它不是所有AI任务都能接,更适合答案本身有固定选项,程序要反复跑大量判断的场景。
Drape的衣橱只有有限候选,Polar每次都在已有候选人里筛选,Keep给已有内容重新排序,StealAds判断的是预先定义好的广告属性,DocJev也只需要在既定类别和文档边界里作选择。
Computer Use同样符合这套逻辑。网页当前能点击的DOM元素本来就是一个有限集合,模型只需要不断读取页面状态,再挑下一步动作。页面更新以后继续判断,整个过程可以形成很快的循环。
但一旦答案需要模型自己生成,Jev的优势就会迅速缩小。
比如Agent调用编辑工具时,需要现场写出具体参数、代码行或者一段新的文本,这些内容并不存在于提前准备好的候选列表里。
这样的工作仍然需要生成模型完成。Jev更适合接管其中那些边界明确、反复发生的选择题,而不是替掉整个Agent。
本地7B模型测试也印证了这一点。普通模型依靠提示词约束,同样可以只输出0、1或是置信度,部分场景下准确率还会更高。
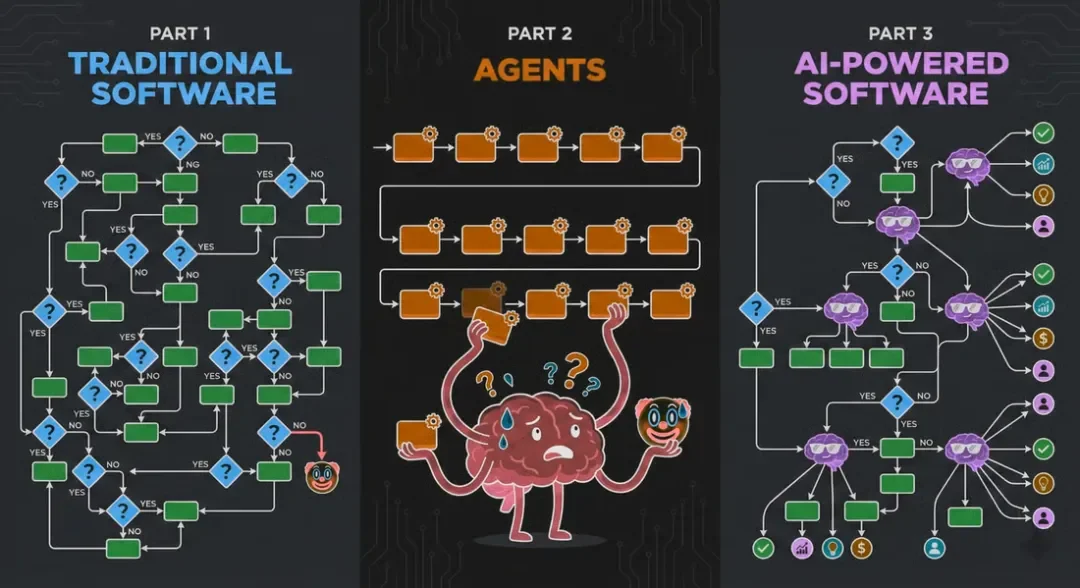
Jev的优势集中在响应速度与结构化输出能力。 它更像是AI软件中新出现的专用组件。
大模型承接复杂理解与内容生成工作,Jev负责处理海量、答案范围固定、对延迟敏感的轻量判断任务。
这也是折腾完这些案例和自己的demo后,对Jev最清楚的一点。
它做的是把一类原本也能交给LLM的小判断单独拆出来,压低到产品愿意高频调用的程度。
AI产品也许接下来不会只有越来越大的通用模型。那些夹在程序流程中间,只负责判断、路由、筛选和检查的专用模型,也会越来越多。
Jev只是最近让这类模型重新进入大家视野的一个代表。
文章来自于“虾蛄AI”,作者“虾蛄内容部”。
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0