核心技巧:通过离散一致性蒸馏做warmup、确定初步结构、逐步引入连续一致性蒸馏和分布蒸馏;音视频采用不同shift、量化策略。
文本到音视频的联合生成模型,成本来自两个方向。
长采样轨迹要求模型反复执行前向计算,高分辨率音视频token又让每一次前向都很重。只减少采样步数,单步计算仍然昂贵;只优化算子,多步采样带来的重复计算依然存在。
为降低此计算成本,来自浙江大学、清华大学、新加坡国立大学等的研究团队推出TurboT2VA。它从两个层面同时处理问题,在模型LTX-2上,训练端将40步教师蒸馏为4步学生。
最终,在单张NVIDIA H20、1024×1792分辨率、121帧的测试设置下,TurboT2VA将生成器耗时从318.74秒降至5.83秒,实现54.67倍生成器加速。
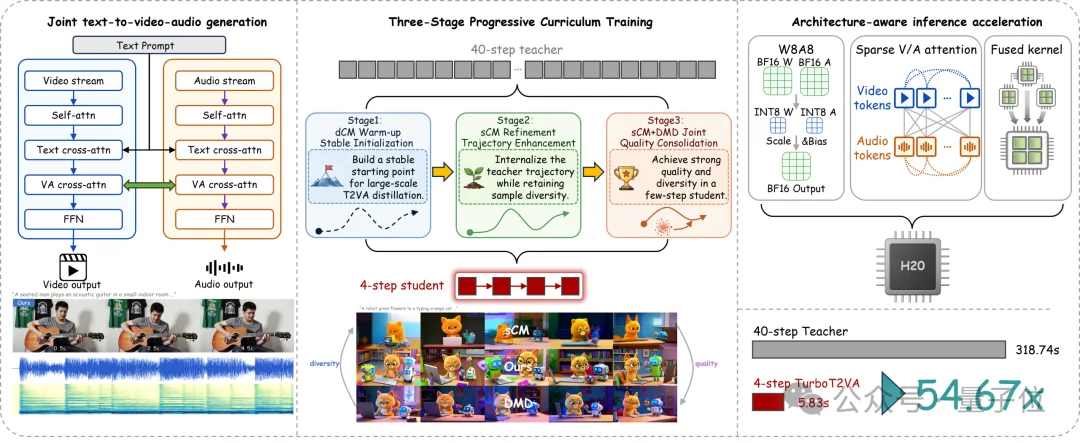
△TurboT2VA总体框架:联合音视频生成、三阶段课程蒸馏与推理加速
核心技巧:先确定生成结构,再逐步引入联合目标
用离散一致性蒸馏warmup,再过渡到sCM+DMD
连续时间一致性模型(sCM,下文的SCM均指sCM)需要估计教师生成轨迹的局部方向。模型扩大到19B,并且同时处理视频与音频后,这一步对数值稳定性的要求更高。TurboT2VA因此采用分阶段训练,让学生先获得基本的去噪能力。
第一阶段使用离散一致性蒸馏(dCM)。学生在离散噪声水平之间学习一致的预测,先确定粗粒度的联合去噪结构,包括基本去噪能力与稳定的时间步条件响应。dCM不需要连续时间的轨迹切线估计,适合作为大模型蒸馏的warmup。
第二阶段从这个初始化继续训练,引入sCM。学生进一步学习教师的连续生成轨迹,让不同噪声水平下的预测保持一致。对于音视频任务,这一阶段需要同时保留画面中的运动演变、声音事件的发展,以及两者的时间对应关系。
第三阶段保留sCM,并加入分布匹配蒸馏(DMD)。此时学生已经具备较稳定的生成轨迹,DMD再推动生成结果向教师分布靠近,改善最终样本的感知质量;持续参与训练的sCM则约束轨迹结构,保留不同随机种子带来的变化。
训练顺序是dCM warmup→sCM refinement→sCM+DMD联合优化。三个阶段沿用同一个学生模型,变化的是训练目标及其引入时机。这里的“确定初步结构”,指建立联合去噪与生成轨迹的先验,模型仍使用原有LTX-2架构。
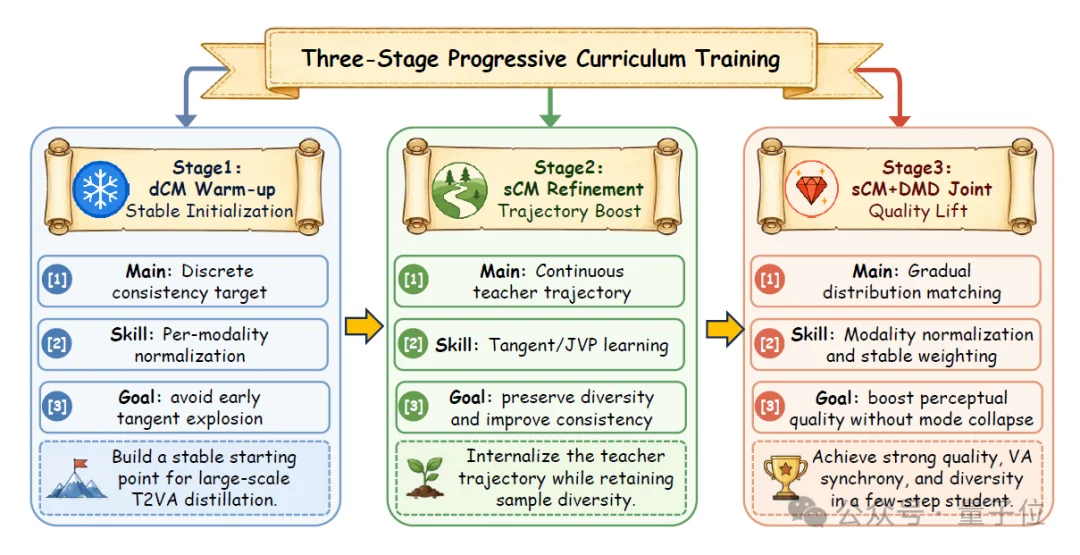
△三阶段课程训练:离散一致性预热、连续一致性细化、联合分布匹配
音视频采用不同的时间步shift
音频与视频的隐变量维度、时间分辨率和学习节奏不同。训练中为两个模态分别设置时间步shift,可以调整各自在噪声水平上的分配,使音视频的去噪调度与各自特征相适应。
实现时,需要区分共享的基础时间变量与各模态经过shift后的有效时间。两个模态仍属于同一条配对样本,共享文本条件,通过联合Transformer交换信息;模态各自的噪声构造和时间条件则需要与对应的调度保持一致。
这里的shift指扩散时间或噪声调度的偏移。CFG guidance scale控制文本条件引导的强度,是另一项参数。调试音视频联合蒸馏时,应分别核对这两类设置,避免把引导强度的差异误当成时间调度的差异。
量化策略:按算子和注意力路径分别处理
四步蒸馏减少了模型调用次数,单次调用仍要执行19B模型的计算。TurboT2VA将推理优化叠加在蒸馏后的学生上,无需为这套推理栈重新训练学生模型。
在线性层上,方法采用W8A8:权重按输出通道做静态INT8量化,激活按行做动态INT8量化。矩阵乘法使用INT32累加,在完整累加结束后统一应用缩放与偏置,减少分块计算中重复缩放的开销。不同音视频分支的矩阵形状并不相同,无法满足优化算子要求的分支回退到原生BF16计算。
在注意力上,视频和音频的自注意力使用SageSLA。H20路径将Query、Key量化为INT8,Value聚合使用FP8;高分辨率配置的Key块保留比例为0.3。对于较短的音频序列,运行时保证至少保留一个Key块。双向音视频交叉注意力和文本交叉注意力继续采用密集计算,保留完整的跨模态交互与文本条件路径。
此外,归一化、调制、门控残差更新和旋转位置编码等操作通过算子融合减少中间读写。单样本推理还会根据共享文本掩码,去掉音视频条件嵌入中的填充位置,减少文本交叉注意力的冗余计算。
为什么要把SCM与DMD结合起来?
一致性蒸馏保留轨迹,分布蒸馏改善样本质量
一致性蒸馏约束的是不同噪声水平下的预测关系。学生沿教师的生成轨迹学习,因而能够用很少的采样步数得到结果。dCM在离散时间点之间建立这种关系,sCM则在连续时间上学习轨迹的一致性,需要通过雅可比向量积(JVP)估计局部变化方向。
对音视频联合生成来说,轨迹学习影响整段内容的演变:物体怎样运动,声音怎样出现,动作与声音在什么时刻对应。保留这些变化,有助于学生继承教师的时间结构和样本多样性。
DMD关注学生生成分布与教师分布之间的差异。它利用score层面的差异提供更新方向,推动学生生成更接近教师分布的样本。已有的DMD、DMD2工作展示了这一路线在少步生成中的感知质量优势,但分布匹配也可能偏向有限的高概率模式,使不同随机种子的结果越来越相似。
因此,两种目标可以分工:sCM保留生成轨迹及其覆盖范围,DMD改善最终输出的感知质量。已有rCM工作采用了score正则化与连续一致性结合的思路,TurboT2VA将这类联合蒸馏扩展到大参数量级的音视频生成,并进一步设计训练顺序与模态平衡机制。
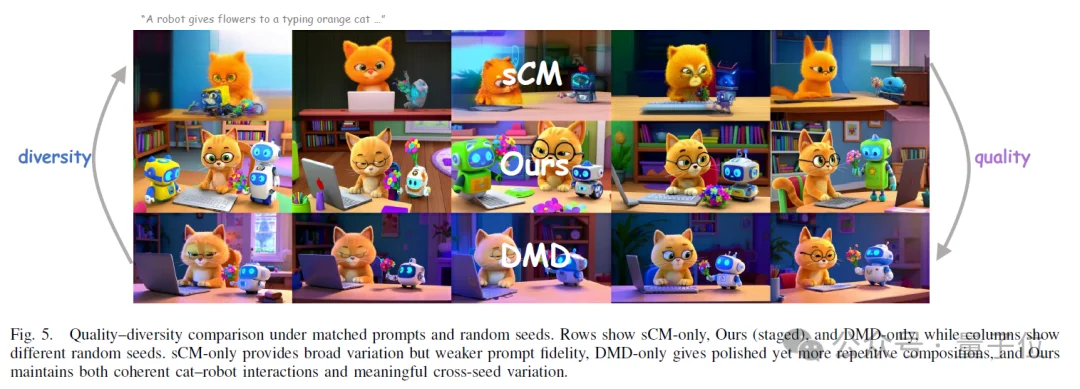
△相同提示词下的质量与多样性对比:sCM、TurboT2VA与DMD
图中各列对应不同随机种子。sCM的构图变化较大,但部分结果对提示词的表达较弱;DMD的画面更规整,构图也更重复。分阶段联合训练保留了猫与机器人之间的互动,同时留下可见的跨种子变化。
为什么不从第一步就同时训练SCM与DMD?
论文比较了直接联合训练与分阶段训练。直接使用sCM+DMD可以收敛,也能生成合理结果;分阶段方案进入联合训练阶段后,在相同训练步数下取得了更高的Javis Score。
作者对这一现象的解释是:过早加入分布匹配时,学生尚未学到覆盖足够广的生成轨迹,就开始受到较强的分布级约束,可能削弱从教师轨迹中继承的多样性。先做dCM warmup和sCM refinement,可以给后续DMD提供更稳定、覆盖更充分的起点。
在T2VA中,这种覆盖范围还包括运动轨迹、声音事件、节奏和音画对应方式。逐步引入目标,让轨迹学习先建立这些关系,再由分布匹配改善最终输出。
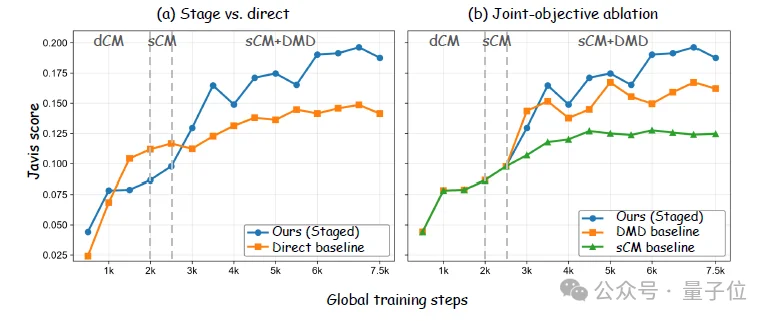
△消融实验:分阶段与直接联合训练对比,以及不同蒸馏目标对比
左图比较分阶段训练与直接联合训练;右图比较联合目标与单独使用sCM、DMD的结果。两张图纵轴均为Javis Score,反映音视频对齐表现。样本多样性则需要结合不同随机种子的生成结果与独立的多样性评估判断。
联合训练如何处理音视频差异?
配对输入,联合前向传播
TurboT2VA在配对的视频与音频隐变量上进行蒸馏。同一条样本的两个模态共享文本条件,分别采样噪声,一起进入联合Transformer;学生通过一次前向传播输出视频和音频预测。
损失按模态分别计算,梯度通过同一个跨模态计算图回传。视频分支能够利用音频token,音频分支也能够利用视频token。计算sCM所需的JVP时,局部方向同样经过跨模态模型,使轨迹学习包含音视频之间的相互影响。
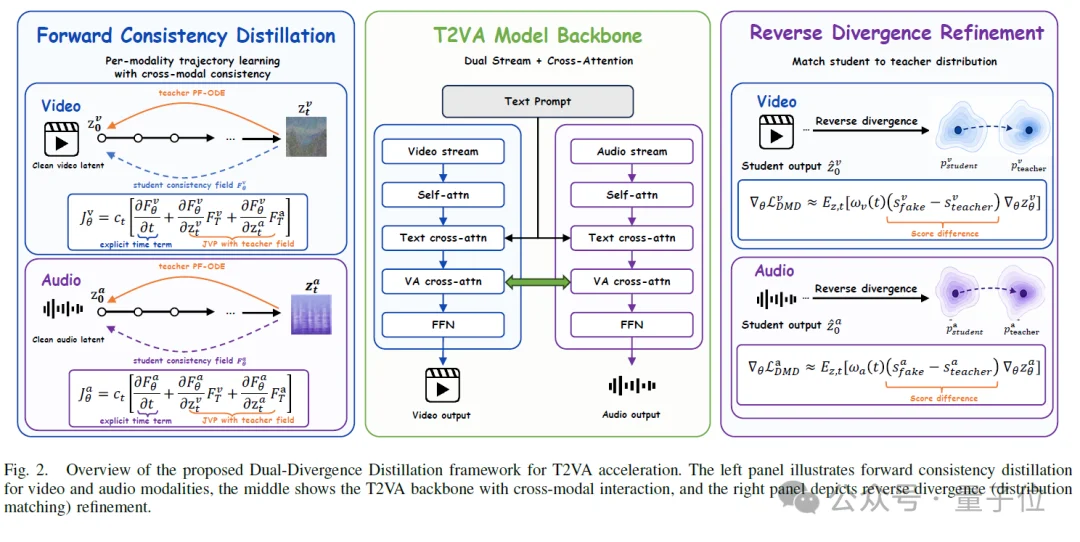
△联合蒸馏框架:配对轨迹的一致性学习、跨模态交互与分布匹配
两种目标采用不同的归一化方式
视频与音频的隐变量规模不同,直接相加损失容易让某一模态主导优化。TurboT2VA分别处理两种目标的更新尺度。
sCM对每个模态的方向向量做L2归一化,再组合模态损失,以减轻视频与音频之间的尺度差异。DMD则使用学生样本与教师预测之间的残差尺度归一化,让分布匹配信号相对于各模态自身的误差大小进行调整。
DMD的监督作用于同一学生生成的配对音视频样本。两个目标使用相同批次、文本条件和配对隐变量,在联合训练时分别约束轨迹与输出分布。归一化后的损失还通过模态权重和目标权重控制相对强度。
训练配置与阶段衔接
主实验使用10万条文本、视频、音频配对样本,在8张H20上训练,分辨率为512×768,长度为121帧,训练约耗时21小时。
论文给出的主模型训练安排为:2000步dCM warmup、500步sCM refinement,以及4500步sCM+DMD联合优化,总计7000步。联合阶段的sCM与DMD权重相同。消融曲线则统一展示到7500步,用于比较不同优化路径。
实验结果:四步生成与推理栈分别带来多少加速?
标准分辨率:50.52秒降到2.51秒
在512×768、121帧的标准评测设置下,40步教师的生成器耗时为50.52秒,4步学生为2.51秒,对应约20.1倍加速。
JavisBench结果中,学生的Visual指标由教师的1.968提升至2.389,Motion由0.783提升至0.849。音画对齐方面,Javis Score从0.165提升至0.196,Desync从0.617降至0.388,其中Desync越低越好。这些结果展示了四步学生在画面、运动和音画对齐上的表现。
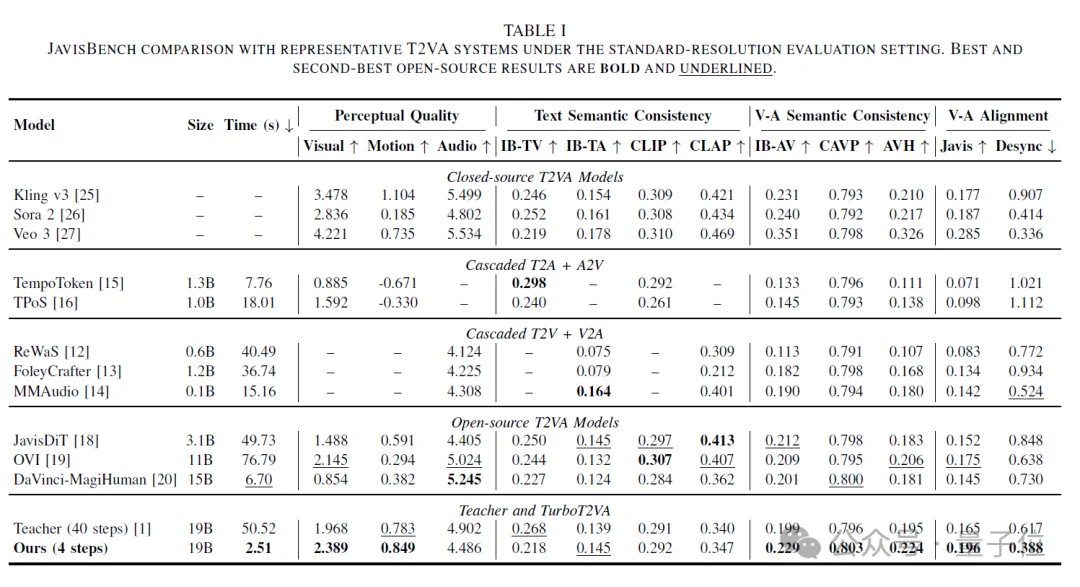
△JavisBench结果:教师、四步学生与其他音视频生成系统的指标对比
论文还使用VBench和TTA-Bench分别评估视频与音频保真度,并用ImageBind比较同一提示词下不同随机种子生成样本的嵌入距离。综合这些评测,纯sCM更偏向保留多样性,纯DMD更偏向感知质量,分阶段联合方案在两者之间取得了更好的平衡。
高分辨率:完整推理栈达到54.67倍生成器加速
高分辨率测试采用单张NVIDIA H20,输出为1024×1792、121帧。官方仓库给出了逐项叠加优化的耗时:
- 40步教师、密集注意力:318.74秒。
- 教师加入W8A8与FastNorm:233.34秒。
- 在此基础上切换到4步学生:12.16秒。
- 继续加入SageSLA和文本填充压缩:5.83秒。
最终配置相对教师达到54.67倍加速。作为参照,同分辨率下未叠加这些推理优化的纯4步学生耗时为16.50秒,完整推理栈在此基础上进一步带来约2.83倍加速。
以上高分辨率数字统计生成器耗时,不包含模型加载、音视频解码、封装和磁盘读写。54.67倍对应这一测试口径下的生成器加速。
论文:https://arxiv.org/abs/2608.24674
代码与演示:https://github.com/thu-ml/TurboDiffusion/tree/main/turbot2va
文章来自于微信公众号 “量子位”,作者 “量子位”
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0