Latent-space diffusion和Pixel-space diffusion,是扩散模型高分辨率图像生成的两条主要路线。
二者各有优势,也各有明显瓶颈。
Latent diffusion高效稳定,但VAE压缩会丢失高频细节;Pixel diffusion能够保留细节,但优化更困难,训练和推理的计算成本往往也更高。
针对这一矛盾,来自中科大和智象HiDream.ai的研究团队提出Hybrid Latent-Pixel Diffusion Transformer(Hi-DiT):在一个共享Transformer backbone内同时协调Latent stream与Pixel stream。
它在早期高噪声阶段用Latent stream完成全局结构规划,后期低噪声阶段再打开Pixel stream补充高频纹理,从而缓解纯Latent模型细节不足和纯Pixel模型优化困难之间的矛盾。论文已被ECCV 2026接收。
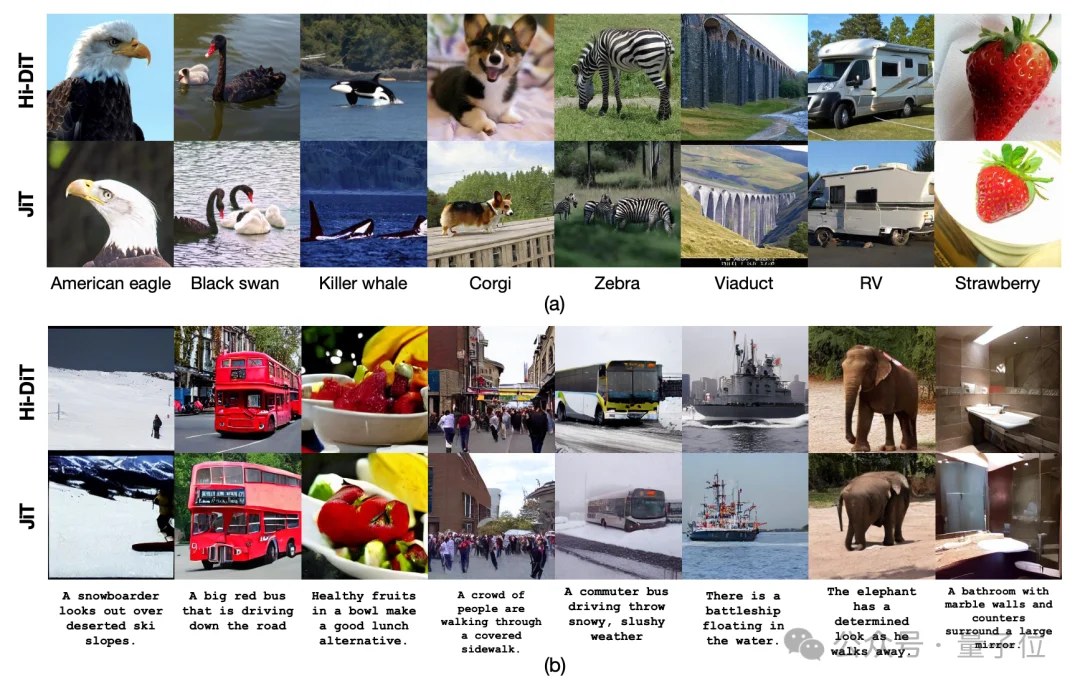
△论文定性结果示例:Hi-DiT在ImageNet类别生成和MS-COCO文生图任务上均呈现更清晰的细节与更稳定的语义对齐。
为什么要做Latent-Pixel混合扩散?
当前高分辨率图像生成中,Latent-space diffusion与Pixel-space diffusion各有优势,也各有明显瓶颈。
Latent Diffusion Models通过VAE将图像压缩到低维Latent manifold,可以显著降低计算开销并提升训练稳定性;但VAE的压缩和解码过程不可避免地会丢失一部分高频信息,导致纹理、边界和局部细节的恢复存在上限。
Pixel-space diffusion则绕开了VAE压缩瓶颈,直接在像素或patchified Pixel tokens上建模,理论上更有利于保留细节。然而原始像素分布维度高、熵大,模型需要在同一个去噪过程中同时学习全局语义结构与局部高频纹理,容易出现容量竞争、优化缓慢和训练不稳定。
Hi-DiT的出发点很直接:扩散去噪并不是一个“每个时间步都同质”的过程。高噪声早期更偏向恢复低频结构和全局语义,低噪声后期才越来越需要合成边缘、纹理等高频细节。因此,与其让同一个模型在全程同时承担两种目标,不如让Latent与Pixel在不同阶段各司其职。
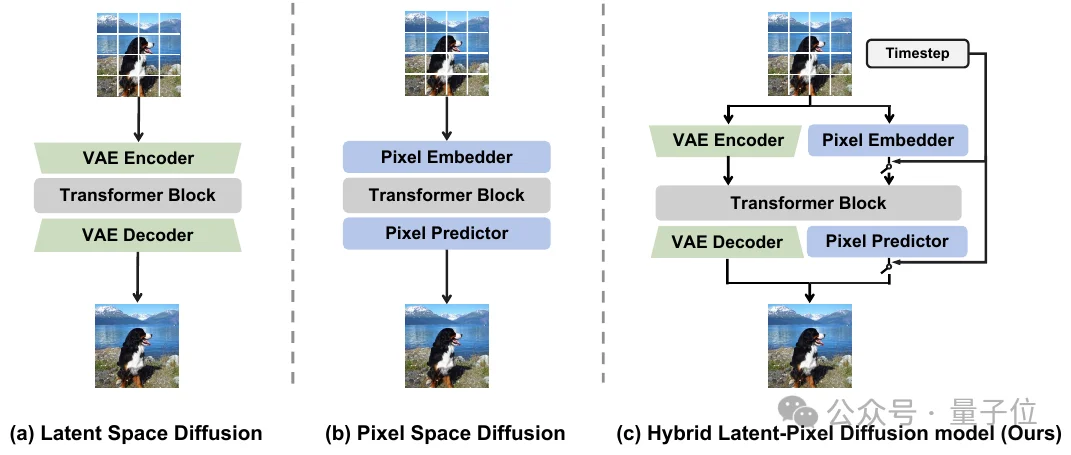
△三类生成范式对比:Latent diffusion高效但可能损失细节;Pixel diffusion保留像素信息但优化困难;Hi-DiT通过时间门控的Latent-Pixel双流结构兼顾二者。
核心方法:时间专业化的双流Hi-DiT
Hi-DiT是一个统一的Hybrid Latent-Pixel Diffusion Transformer。它不是简单地把Latent tokens和Pixel tokens从头到尾拼在一起,而是使用时间门控机制控制Pixel stream何时参与。模型整体仍然运行在一个参数共享的Transformer backbone中,以便Latent与Pixel表征能够交互,同时通过不同的输入投影和输出预测头承担不同目标。
在早期高噪声阶段,模型主要依赖Latent Stream。该分支以VAE Latent为输入,学习全局结构、物体布局和低频语义,从而提供稳定的semantic scaffold。
进入后期低噪声阶段后,Pixel Stream被激活。它直接接收与当前噪声水平一致的Pixel tokens,并与Latent tokens一起送入共享Transformer。此时Latent predictor继续保证结构一致性,Pixel predictor则负责恢复锐利的高频细节。
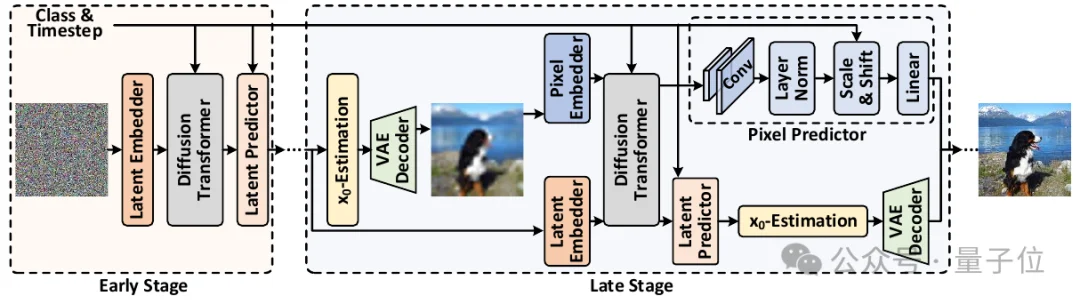
△Hi-DiT框架示意:早期Latent stream建立结构,后期Pixel stream打开并补充高频细节,最终将VAE解码的结构与像素级refinement融合。
两个关键设计
- 设计一:Time-Gated Injection
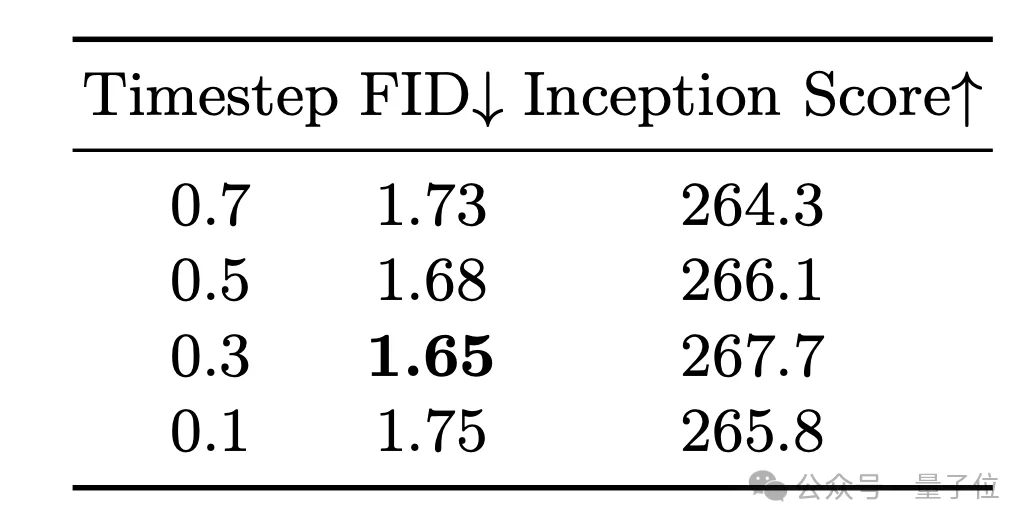
时间门控机制通过G(t)=1(t<τ)控制Pixel tokens的注入。高噪声阶段关闭Pixel stream,避免模型过早承担局部纹理预测;低噪声阶段打开Pixel stream,让模型集中恢复高频细节。论文中默认选择τ=0.3。
- 设计二:High-Frequency Pixel Predictor
传统Pixel diffusion常用单层线性投影从token直接回归大尺寸patch,回归难度较高。Hi-DiT使用分层sub-Pixel decoding:先通过卷积与PixelShuffle逐步上采样,再预测局部sub-patch,从而降低高维像素回归难度。
这两个设计共同服务于一个目标:让模型在合适的时间做合适的事情。Latent stream先负责全局语义,Pixel stream 后负责细节补偿,避免低频结构与高频纹理在全程互相干扰。
实验结果:在多个设置下取得强性能
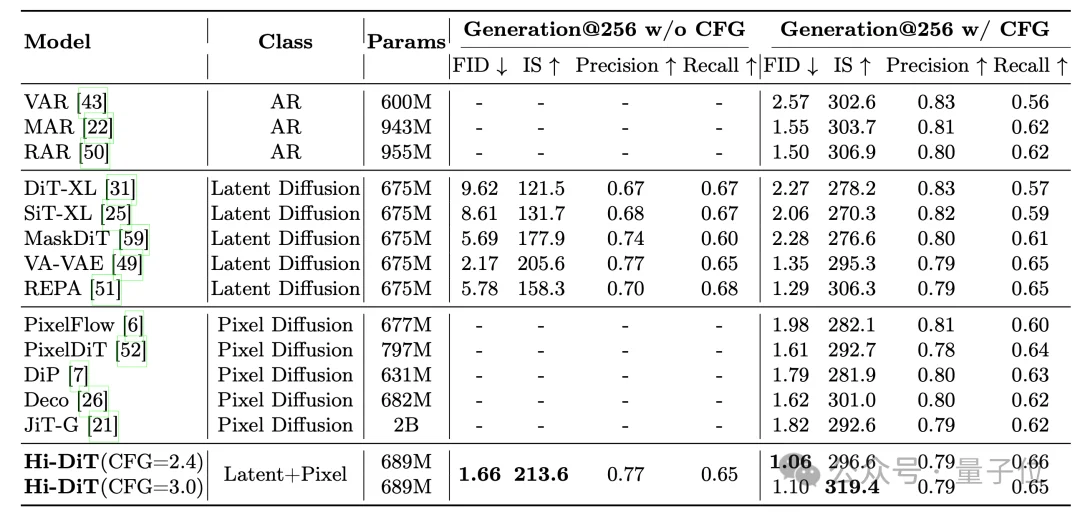
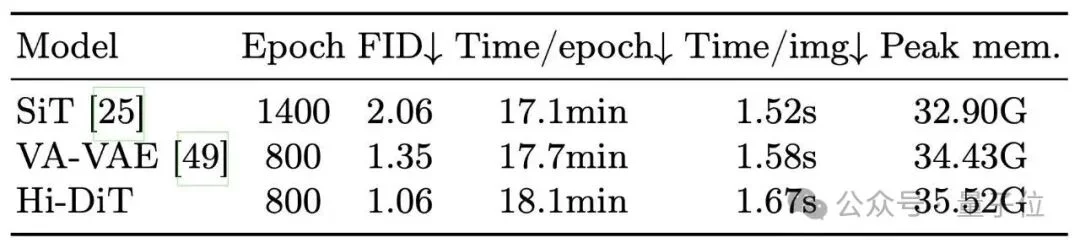
在ImageNet class-conditional generation、ImageNet 512高分辨率生成和MS-COCO text-to-image generation上,Hi-DiT均取得了很有竞争力的结果。尤其是在ImageNet 256×256上,Hi-DiT在CFG设置下达到1.06 FID;在ImageNet 512×512上达到1.26gFID;
从qualitative results也可以看到,Hi-DiT相比纯Pixel-space baseline JiT生成的图像更稳定,局部纹理和物体形状更清晰;在文生图结果中,图像与输入prompt的语义对齐也更紧。
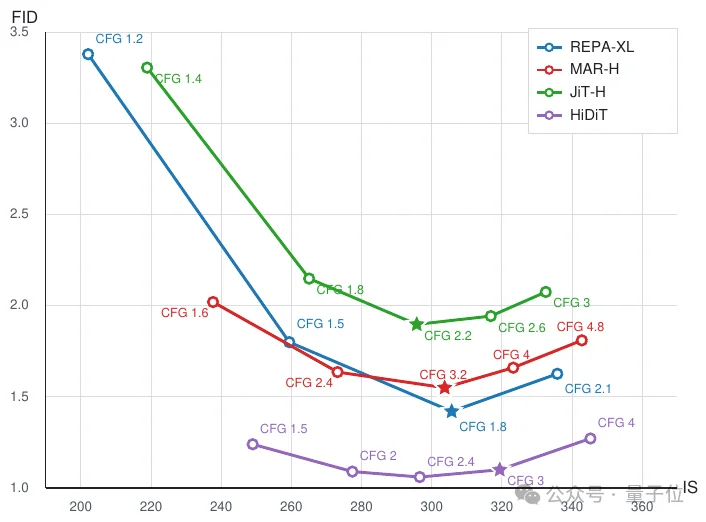
△CFG扫描下的FID-IS trade-off:Hi-DiT在不同CFG scale下保持更优的FID-IS曲线,说明性能收益不是依赖单一guidance scale得到的。
消融分析:为什么这些模块有效?
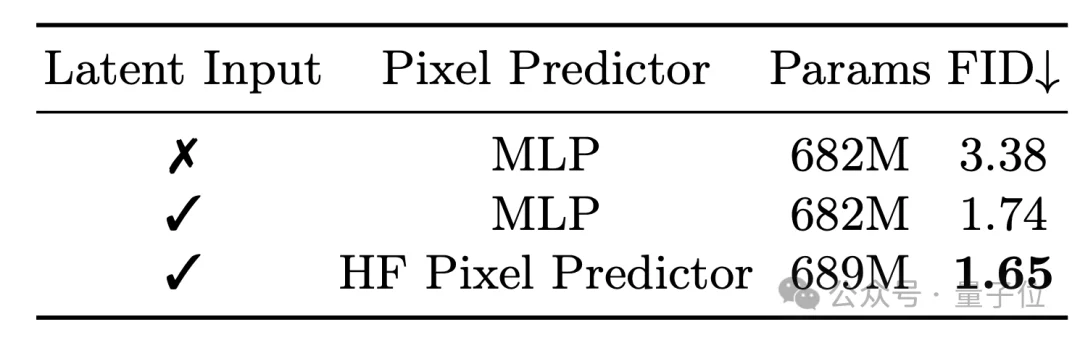
论文在80 epoch的快速验证设置下进行了组件消融。仅使用vanilla Pixel stream且没有Latent input时,FID为3.38,说明直接从patchified Pixel tokens优化原始图像分布难度很高。加入Latent input后,FID降至1.74,说明Latent stream能提供有效的语义支架。进一步使用High-Frequency Pixel Predictor后,FID达到1.65,验证了分层像素预测头对细节建模的帮助。
时间门控阈值τ也很关键。如果Pixel stream打开太早,例如τ=0.7,模型会在高噪声阶段同时预测低频语义和高频细节,重新引入容量竞争;如果打开太晚,例如τ=0.1,Pixel stream参与不足,细节恢复不充分。实验中同样训练80ep的情况下,τ=0.3取得最好结果,FID为1.65,IS为267.7。
效率与实际意义
Hi-DiT并不是用大幅增加计算量换效果。相比SiT和VA-VAE,Hi-DiT的训练与推理开销只小幅增加:每个epoch训练时间从17.1/17.7分钟增至18.1分钟,单图推理时间从1.52/1.58秒增至1.67秒,峰值显存为35.52G。考虑到FID从2.06/1.35进一步提升到1.06,这一额外开销换来的质量收益是比较划算的。
总结
Hi-DiT的核心贡献不是简单地“Latent+Pixel”,而是围绕扩散去噪的时间异质性重新分配模型能力:早期用Latent stream做全局规划,后期用Pixel stream做高频细节恢复。这样的设计在一个共享Transformer backbone内统一了Latent-space generation的语义效率与Pixel-space generation的细节优势。
对于下一代图像生成基础模型,这一思路给出了一个很清晰的方向:不一定要在Latent和Pixel两条路线之间二选一,而可以让不同表征在去噪轨迹的不同阶段发挥不同作用。Hi-DiT证明了这种时间感知的容量分配能够带来更好的生成质量、更稳定的CFG trade-off,以及较小的额外计算开销。
论文标题:Hi-DiT: Hybrid Latent-Pixel Diffusion Transformer for Image Generation
会议:ECCV 2026
任务:图像生成 / Diffusion Transformer / Latent-Pixel Hybrid Generation
核心关键词:Hybrid Latent-Pixel diffusion, Time-Gated denoising, High-Frequency Pixel Predictor
代码:https://github.com/HiDream-ai/Hi-DiT
项目主页/Code:https://github.com/HiDream-ai/Hi-DiT
文章来自于微信公众号 “量子位”,作者 “量子位”
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0