本文已被 EMNLP 2026 Main Conference 接收。论文第一作者为中国人民大学统计与大数据研究院博士研究生薛敦耀,通讯作者为中国人民大学代文林、孟澄研究员。
在一次解码步骤中,大语言模型面对的并不是唯一答案,而是一组具有不同概率的候选 token。为了提升解码多样性,现有方法往往不采取贪心选择的策略而是从概率分布中采样来得到下一步预测。为了避免采样到极小概率 token,Top-p、Min-p 等常用方法根据概率截断候选集合,再从剩余部分进行采样。
这些方法简单有效,但却忽略了一个问题:概率高的 token,不一定能为候选集合带来新的信息。多个高概率 token 可能在语义上高度相似,只是同一条生成路径的不同表达。如果只按概率筛选,它们会被同时保留;而一个概率略低、但能提供不同语义方向的 token,反而可能被提前截断。最终得到的候选集合看似 “可靠”,实际上却包含大量冗余。
中国人民大学代文林研究员、孟澄研究员团队提出的Mahalanobis-Ensemble Decoding(ME-Decoding),将解码中的候选 token 筛选改写为一个动态子集优化问题。方法同时读取模型概率和 token embedding,在每个生成步骤中寻找置信度较高、内部冗余较低的 sampling support。在所测三个模型、三个温度设置的汇总结果中,ME-Decoding 在推理与开放式生成任务上均取得了所比较方法中的最佳平均表现;端到端 GPU 测试中,相比最快的概率截断基线,总延迟仅增加约 3%。
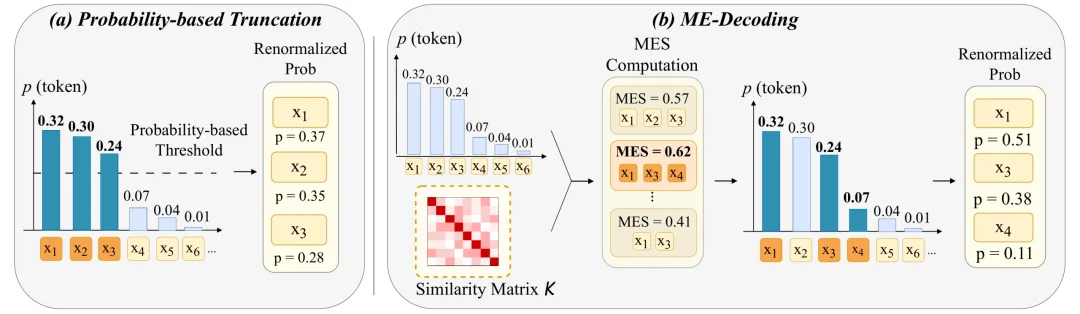
左侧:概率截断仅依据单个 token 的概率决定去留。右侧:ME-Decoding 同时利用 token 概率与 embedding 相似度,选择整体信息量更高的候选子集。
- 论文标题: Beyond Truncation: Rethinking LLM Decoding as Ensemble Pruning
- 论文地址: https://arxiv.org/abs/2609.18723
- 代码地址: https://github.com/sapphirexdy/ME_decoding
ME-Decoding 是怎么做的
ME-Decoding 将候选 token 看作待剪枝的集成成员:既关注单个候选的概率,也考察它与其他候选的语义关系。方法主要可以概括为三步。
第一步:用 Mahalanobis-Ensemble Score 同时衡量概率与冗余
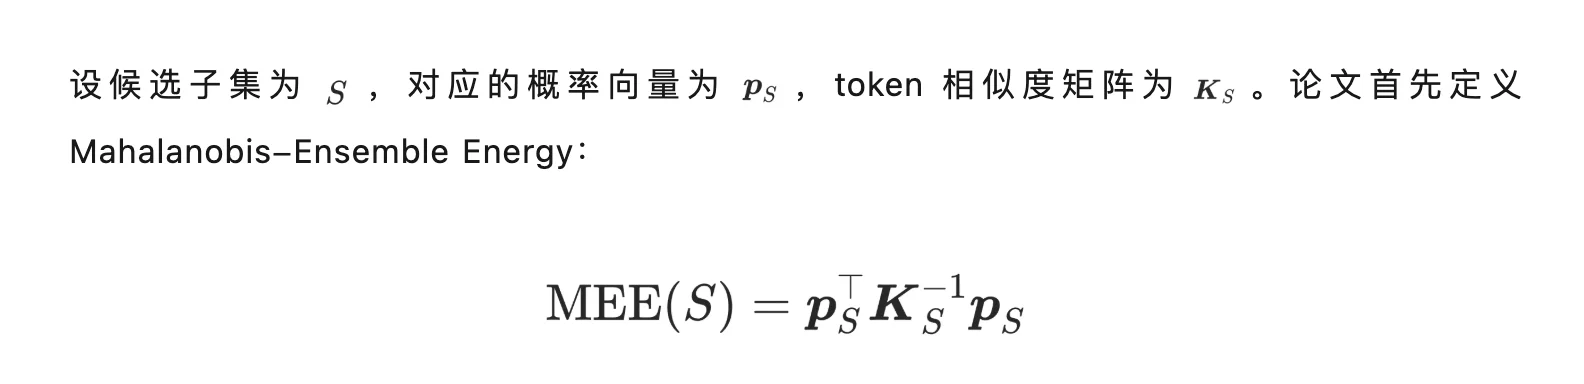
MEE 将候选概率与语义关系纳入同一个集合评分:概率反映模型对候选的置信度,相似度矩阵则反应候选之间的语义关系。直观上,我们希望保留的候选既有较高概率,又能补充当前集合尚未覆盖的信息。
为了同时决定保留多少个候选,论文进一步引入随当前分布不确定性变化的规模惩罚,得到 Mahalanobis-Ensemble Score:
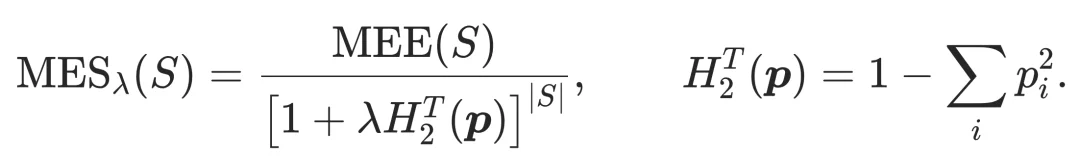
分子衡量候选集合的联合贡献,分母约束集合规模。只有新增候选带来的收益足以抵消规模惩罚时,MES 才会提高。因此,ME-Decoding 评估的是整个子集的质量,并据此决定是否继续扩展候选集合。
第二步:用自适应 kernel 刻画局部语义结构
ME-Decoding 利用归一化后的 token embedding 构造高斯相似度核:
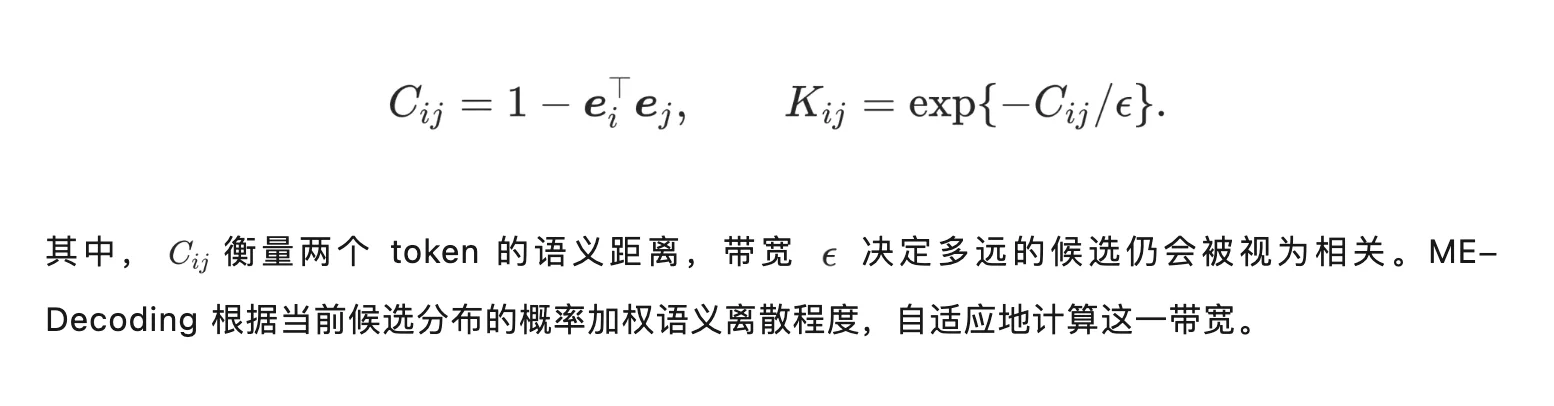
决定多远的候选仍会被视为相关。ME-Decoding 根据当前候选分布的概率加权语义离散程度,自适应地计算这一带宽。
候选的语义分布越集中,带宽越小,核函数关注的距离范围越局部;分布越分散,带宽越大,更远的语义关系也会被纳入评分。这样,每一步的候选筛选都能使用与当前分布相适应的语义尺度。
第三步:逐步扩展候选集,并自动确定集合大小
遍历所有 token 子集需要组合搜索,难以用于逐 token 解码。为此,ME-Decoding 从最高概率 token 开始,每轮选择能带来最大边际 MEE 增益的候选;若加入后 MES 继续上升,就扩展集合,否则立即停止并保留当前集合。候选集确定后,将集合内 token 的原概率重新归一化,再从中采样下一个 token。
这一过程无需预先固定保留的 token 数量,而是根据每一步的概率分布与语义关系自动确定集合大小。实际解码中,最终集合通常很小;结合提前停止,计算量对候选池规模近似线性。
实验结果与分析
论文在 Qwen3-4B、Phi-4-mini 和 Mistral-7B 上评估推理与开放式生成,并与 Min-p、p-less、Top-H、Top-W 等方法比较。
推理任务:不同温度下的稳健性
在 GSM8K 和 GPQA 上,论文比较了三个模型在 T = 1.0、1.5、2.0 下的推理准确率。
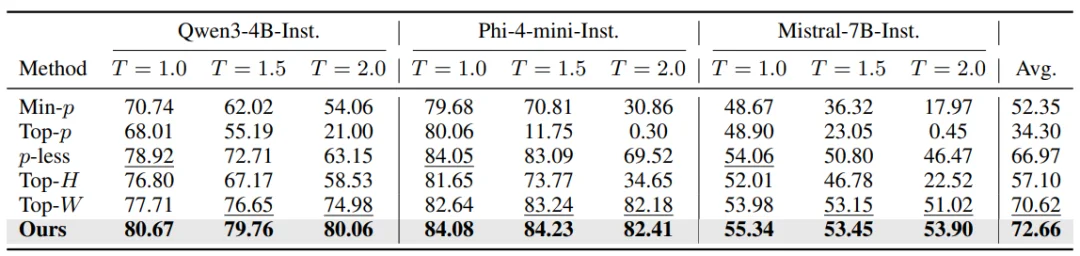
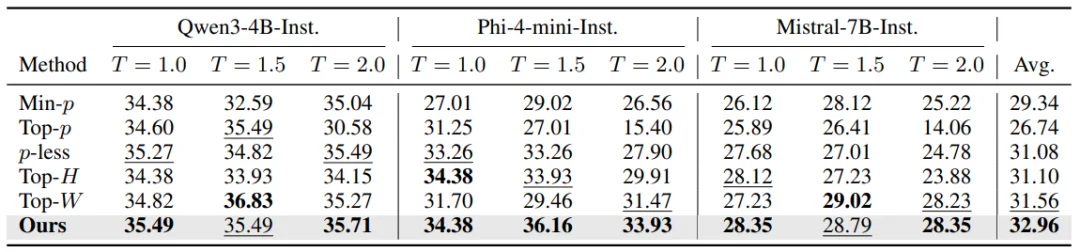
上:GSM8K;下:GPQA。
ME-Decoding 在两个数据集上的平均准确率分别为 72.66% 和 32.96%,均为所比较方法中的最高值。尤其在 GSM8K 的高温设置下,部分概率截断方法出现明显退化,而 ME-Decoding 仍保持较高准确率,体现了跨模型、跨温度的推理稳健性。
开放式生成:指令遵循与对话
在 DeepSeek-V4-Pro 作为评审模型的评估下,ME-Decoding 在 AlpacaEval 和 MT-Bench 上分别取得最高的平均 win rate 与平均分数。这表明,基于集合质量的候选选择也能改善开放式生成中的指令遵循与多轮对话质量。
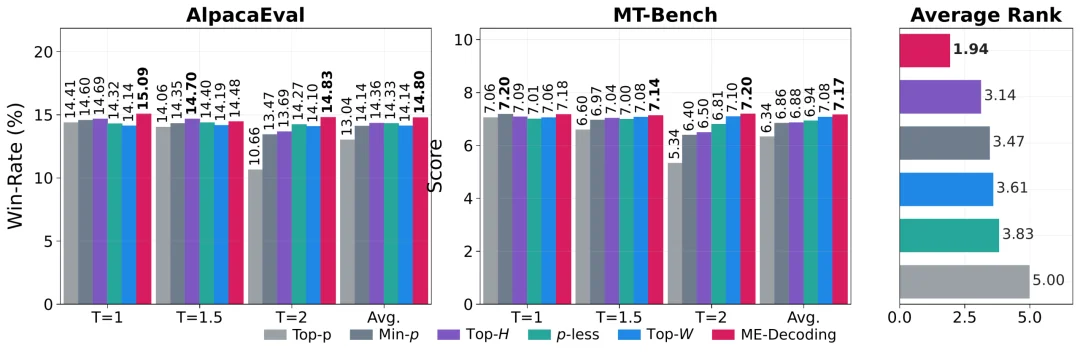
左、中分别为三个模型在不同温度下的平均 AlpacaEval win rate 和 MT-Bench 得分;右侧为所有模型、温度和任务上的综合平均排名,数值越低越好。
进一步分析:性能提升是否仅仅来自候选集大小或采样熵的变化?
论文分别匹配概率方法与 ME-Decoding 的平均支持集大小、剪枝后熵和支持集内两两余弦相似度,比较这些条件近似一致时的推理表现与集合评分。
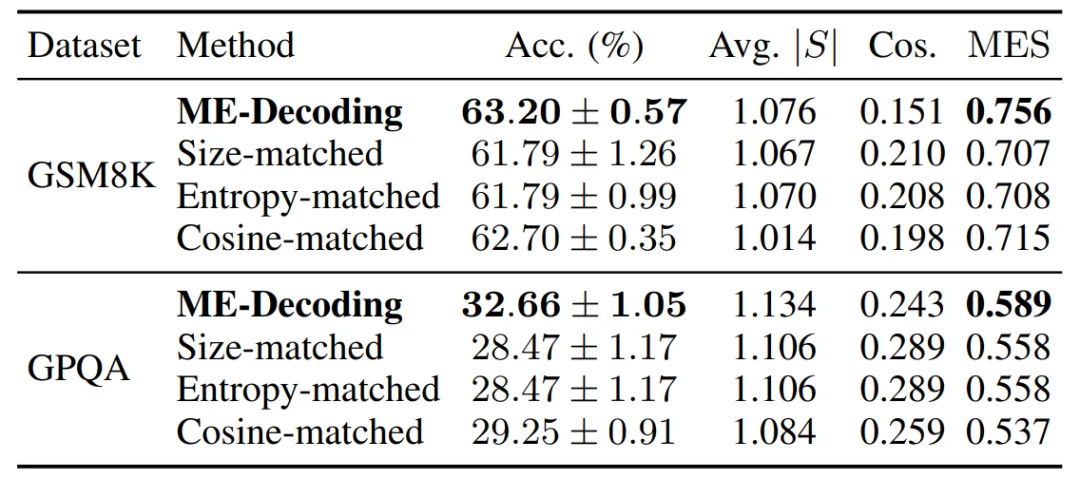
匹配后,ME-Decoding 在 GSM8K 和 GPQA 上仍取得最高准确率,同时保持最高 MES 和最低的语义相似度。这一结果支持其优势来自 MES 对概率与语义冗余的联合评估,而非仅仅缩小支持集、降低采样熵或降低平均余弦相似度。
理论行为与实际开销
论文给出贪心 MES 轨迹单峰的充分条件及相应近似保证。关闭早停机制的实验中,GSM8K 和 GPQA 各条推理轨迹都呈单峰,支持这一停止规则在所测设置中的实际表现。
效率方面,ME-Decoding 在 synthetic CPU benchmark 中,它比 Top-W 快约 3 至 7 倍;端到端 GPU 测试中,相对基于概率截断的最快基线的总延迟仅增加约 3%,仅仅占据模型前向的极小部分开销。
总结
ME-Decoding 提供了不同于传统截断的视角:LLM 解码除了在概率分布上划定阈值,还可以被理解为动态的集合优化问题。整体来看,这项工作有三个特点:
第一,重新定义 token 选择问题。 它将候选 token 看作待剪枝的集成成员,把单点概率选择扩展为集合层面的联合选择。
第二,联合利用置信度与语义几何。 MES 在保留高概率候选的同时,调整已被当前集合覆盖的语义方向的贡献,以获得更紧凑、更有信息量的 sampling support。
第三,高效地适应当前分布。 语义 kernel 的带宽随每一步的候选分布变化,贪心搜索在 MES 不再提升时自动停止,控制候选集合的规模与计算开销。
ME-Decoding 的核心是:筛选候选 token 时,既考虑单个候选的概率,也考虑候选之间的语义冗余,从集合层面决定保留哪些候选。实验表明,这一视角能够改善所测任务的平均表现,并在不同温度下保持稳定。
文章来自于微信公众号 “机器之心”,作者 “机器之心”