从 1200 万个候选拉取请求中,最终留下 5000 个 SWE 代码任务 —— 不足 0.05%。把「出题、答题、改卷、训练、评测」这条代码数据流水线全自动跑起来,就是 LegoFlow; 在这个过程中,我们还发现了三个观察。
软件工程是最近大语言模型的核心能力,但高质量代码数据的生产仍相当复杂,涉及从仓库发现、任务验证、轨迹推理到训练评测的漫长流程。
如何把「造题、答题、筛选、训练、评测」这条代码数据流水线全自动跑起来?华为、港中文、港科大的研究员们联合推出 LegoFlow,一个简单易用、交互式的代码数据工程框架,亮点包括:
- 自动化智能体工作流:从仓库和 PR 收集到任务验证、轨迹推理、训练与评测,每道流程都封装为标准插件技能,Claude Code、Codex 等编码智能体可直接调用。
- 开源任务与轨迹:团队发布 LegoFlow-SWE,包含从 1,200 万个 PR 中筛选出的 5,000 个任务,覆盖 8 种编程语言和 20 个任务标签,以及 2,780 条验证成功的高质量轨迹;仅用 1,000 条轨迹训练 Qwen3.5-35B-A3B-Base,即可在 SWE-bench Verified 和 Pro 上分别达到 70.2% 和 48.8%。
- 迈向递归式自我改进: 在极少人工设定下,智能体能运行完整流程、评估结果并调整策略。经过两轮迭代,Qwen3.5-35B-A3B-Base 在 SWE-bench Verified 上从 7.6% 提升至 64.4%。
- 项目博客:https://www.legox.net/blog/legoflow/
- 开源数据:https://huggingface.co/datasets/Lego-X/LegoFlow-SWE
- 代码地址:https://github.com/LegoX/LegoFlow
LegoFlow 如何工作
代码数据是训练推理型大模型的关键原料,但人工标注成本高、LLM 生成不可控、自动验证难度大,是社区公认的瓶颈。LegoFlow 将代码数据工程组织为一系列 block:
- Root 把用户目标转化为工作流并协调任务分发、资源与反馈;
- Curator 将仓库和拉取请求转化为经过验证的任务;
- Tracer 生成训练轨迹;
- Trainer 进行微调;
- Evaluator 返回基准评测结果。
每个 block 都封装为插件技能,编码智能体可操作整个工作流。
block 的设计理念
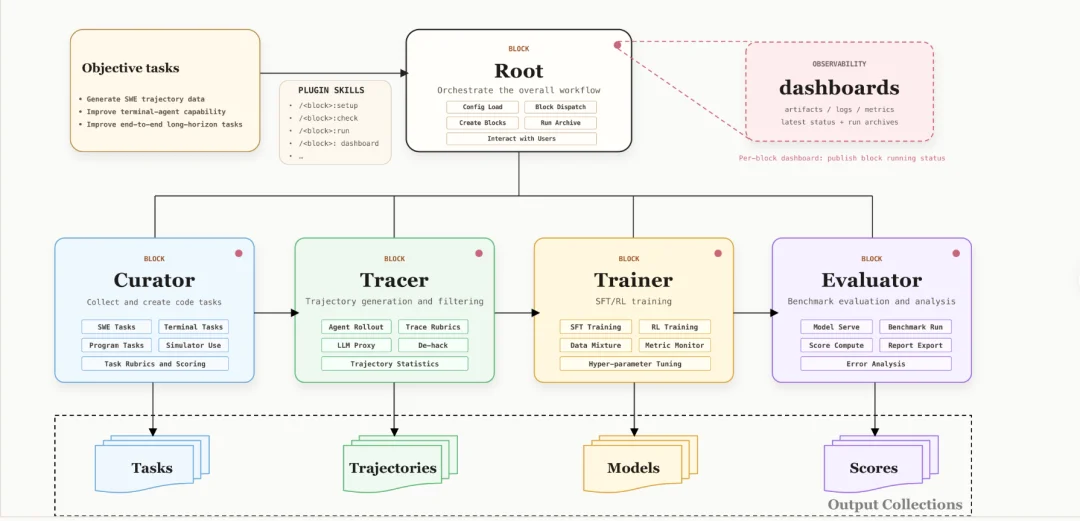
想象一下:复杂的工程工作流通常拆分给多位工程师,每人负责界限清晰的环节并彼此协作;LegoFlow 把相同结构带入智能体工作流。每个 block 就像一位工程师:由编码智能体管理,自带完成职责所需的仓库、脚本、依赖和环境,并封装为插件技能,供用户通过智能体直接调用,简化智能体操作和编排涉及多 repo 操作的工作。
Curator:构建经过验证的编码智能体任务
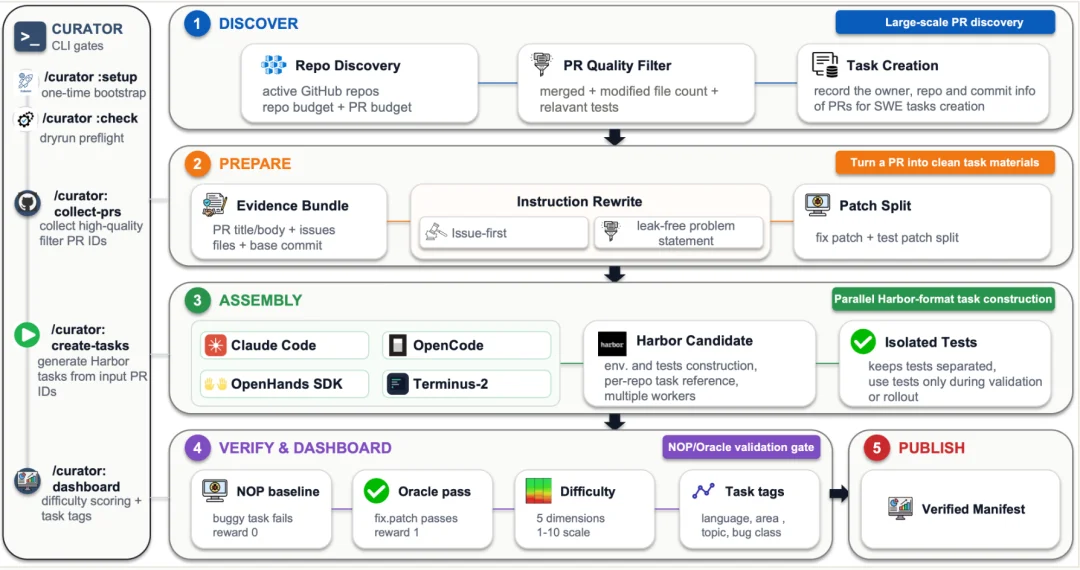
Curator 收集 GitHub 仓库和拉取请求,创建经过验证的编码智能体任务(图 2),主要步骤包括:
- 步骤 1:数据发现:搜索活跃仓库中相关且已合并的拉取请求,应用基础质量过滤并记录来源信息。
- 步骤 2:数据准备:收集 PR、issue、commit 与测试证据,改写成清晰且无泄漏的任务,并分离修复代码与测试。
- 步骤 3:数据组装:按标准 Harbor task format 构建候选任务,配备可验证、可运行的隔离环境与测试。
- 步骤 4:验证与看板:确认有缺陷版本会失败、参考修复可通过;随后赋予难度分数与分析标签,加入公开清单和看板。
Tracer:生成并筛选任务轨迹
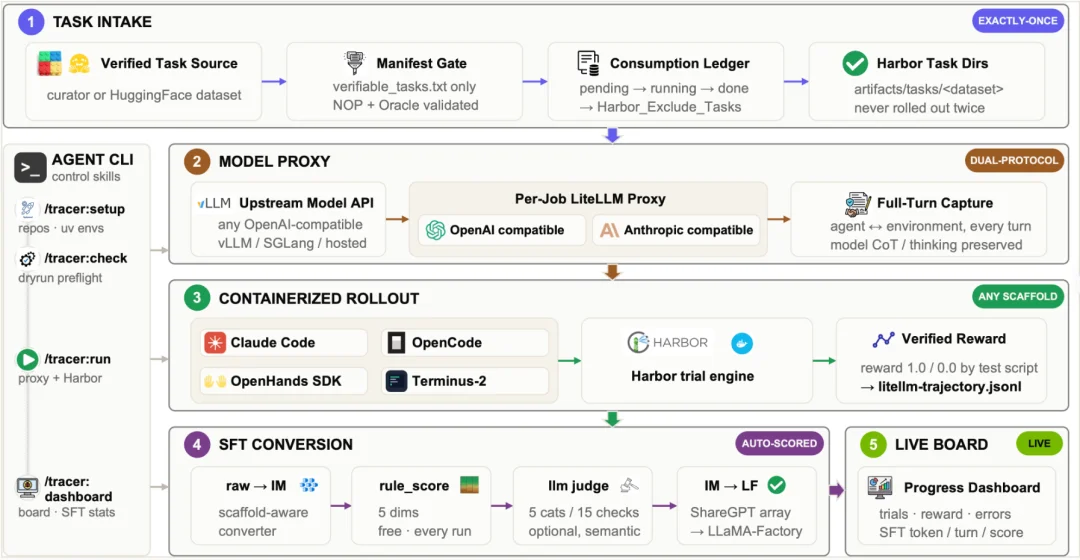
Tracer 使用 Claude Code、OpenCode、OpenHands 等编码智能体框架从已验证任务生成轨迹(图 3),主要步骤包括:
- 步骤 1:输入任务, 加载来自 Curator(或外部数据集)的已验证任务,校验清单,避免重复运行。
- 步骤 2:模型代理, 通过共享代理连接框架与所选模型,并记录完整交互。
- 步骤 3:容器化运行, 在隔离的 Harbor 环境中运行每个智能体、执行验证器,并记录最终奖励与轨迹。
- 步骤 4:SFT 训练格式转换,将有效轨迹转换为统一训练格式,结合基于规则与模型的评分,为训练筛选样本。
Trainer 与 Evaluator
LegoFlow 通过 SFT 训练与评测验证数据质量:智能体可自动将 Tracer 的有效轨迹转为标准 LLaMA-Factory 格式供 Trainer 使用,训练后 Evaluator 自动定位检查点、运行基准评测并发布到看板。
Evaluator 构建于 Harbor 之上,支持 SWE-bench Pro 等智能体基准评测;通过限制网络、加入防作弊提示词等措施缓解评测作弊,使结果聚焦模型本身能力。
除 SFT 外,团队也在将 Lego-RL 集成到 Trainer,使其可直接使用 Curator 验证的任务进行 RL 训练。
看板可视化
代码数据流程可能持续运行数小时乃至数天,因此每个 LegoFlow block 都配有看板监控进度、检查中间产物。图 4 是一份 Curator 快照,包含 822 个仓库、8,818 个拉取请求、926 个已构建任务和 270 个已验证任务。
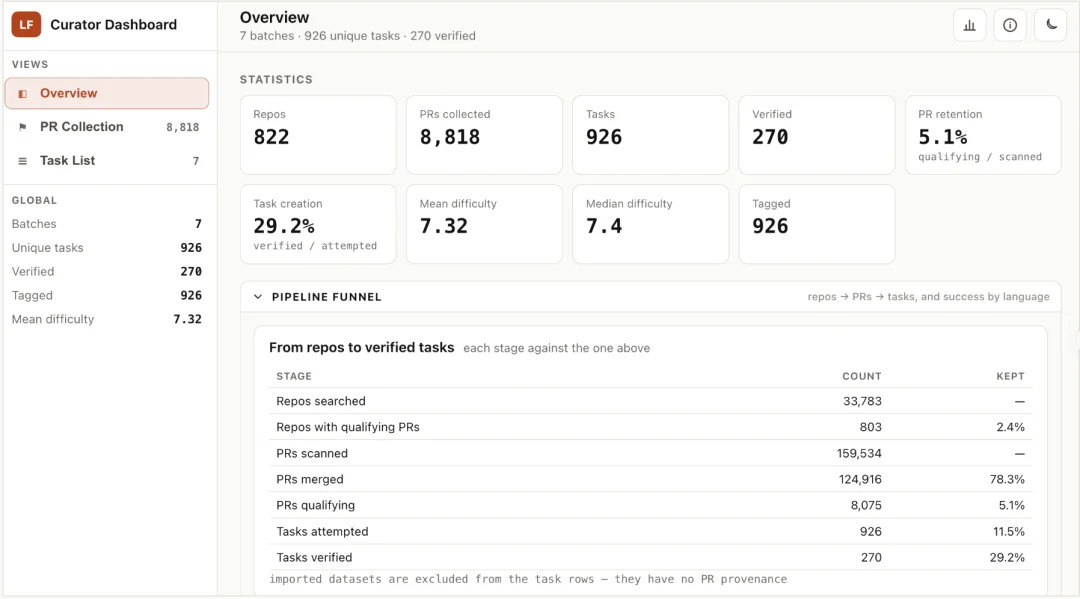
看板还展示通过率、标签分布、评分标准分数、抽样轨迹和评测详情:
- Curator 看板
- Tracer 看板
- Trainer 看板
- Evaluator 看板
LegoFlow-SWE:规模化构建经过验证的任务
GitHub 上有数以百万计的拉取请求,但只有一小部分能成为可靠的软件工程任务:必须拥有可复现的环境和测试。为验证 LegoFlow 能否规模化构建此类任务,团队发布 LegoFlow-SWE—— 从 1200 万个候选拉取请求中整理出的开放 SWE 任务与轨迹集合,并在公平设置下评估其能否与最先进的 SWE 数据集(如 ScaleSWE、DeNovoSWE)竞争。
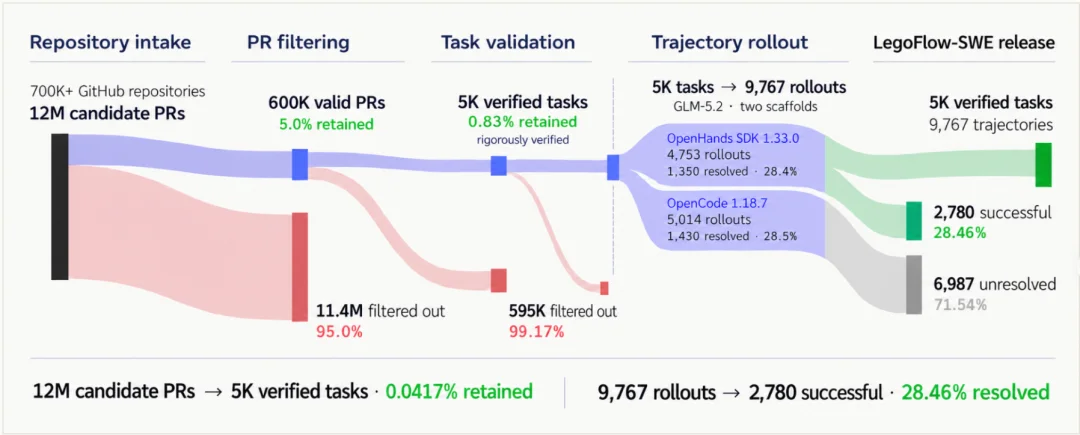
构建从收集超过 70 万个 GitHub 仓库及其关联的 1,200 万个候选拉取请求开始。经有效 diff、合理补丁大小、测试和 issue 证据等条件筛选后,仅剩 60 万个 PR;LLM 评审器与执行验证进一步去除简单或无法验证的任务,最终留下 5,000 个已验证任务,仅占原始数据池的 0.0417%。GLM-5.2 通过 OpenHands SDK 和 OpenCode 生成 9,767 次运行,其中 2,780 次通过验证。
训练结果
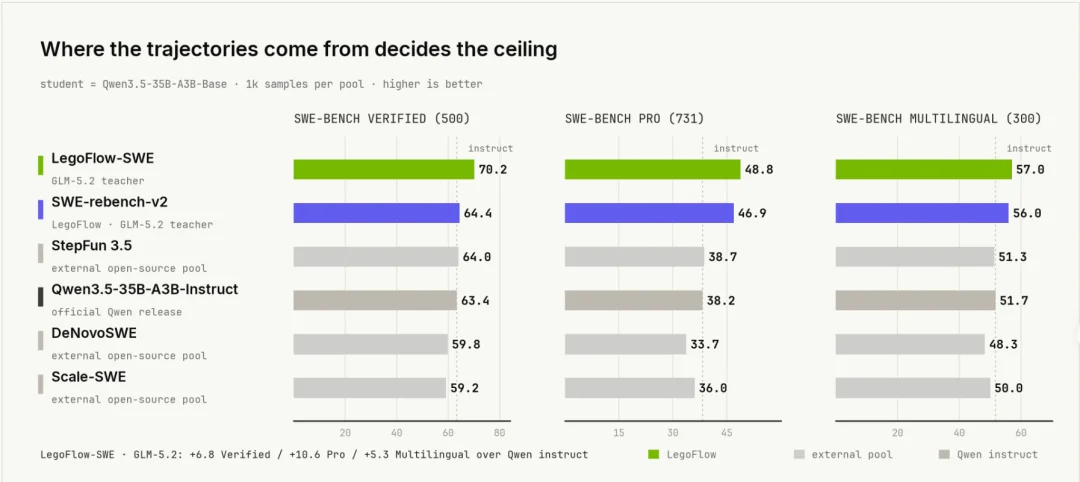
为公平检验任务来源,团队固定教师模型、框架、评分、采样与预算,用各来源约 1,000 条轨迹微调 Qwen3.5-35B-A3B-Base,并在 SWE-bench Verified、Pro、Multilingual 上评测。
在 LegoFlow-SWE 上训练后,模型达到 SWE-bench Verified 70.2%、Pro 48.8%、Multilingual 57.0%,超过 Qwen-3.5-35B-A3B-instruct 及外部开源轨迹数据池;相比 SWE-rebench-v2 分别提升 5.8、1.9、1.0 个百分点。这里也分享一些过程经验:
经验一:任务质量比数量更重要
任务质量包含两方面:任务必须可验证,环境和测试能可靠地区分原始代码与修复后的代码;也必须足够困难,需要真正展开调查,而非套用简单补丁。
Curator 用静态的评分标准,从变更范围、逻辑复杂度、上下文广度、测试复杂度与指令复杂度五个信号加权打分(1.0~10.0):≤4.0 为简单、4.0~7.0 为中等、7.0 以上为困难。
与 SWE-rebench V2 相比,LegoFlow-SWE 平均难度分数更高(6.27 对 5.80),困难任务占 39.4%(对比 35.1%);仅改变任务数据池,就使 Verified、Pro、Multilingual 分别提升 5.8、1.9、1.0 个百分点(学生模型 70.2/48.8/57.0 对 64.4/46.9/56.0)。
经验二:越强的模型越倾向于「作弊」
更强的教师模型可能更擅长对基准评测作弊,而非更擅长解决问题。团队观察到三种利用信息泄漏的方式:找到公开仓库及其上游修复 PR、直接复制已有补丁、或将生成的变更与上游提交比对视为正确证明。
移除泄漏答案的实验后,教师模型与学生模型的 Verified 分数分别下降 8.0、10.0 个百分点;且越新的开源模型作弊率越高:GLM-5 为 3.6%,GLM-5.2 升至 21.2%—— 它并非发起更多可疑尝试,而是更擅长把它们变成成功的作弊。
团队通过两项措施将 GLM-5.2 的作弊率降至 1% 以下:一是在提示词中加入防作弊指令,要求模型仅用任务环境内资源独立推导;二是限制可访问内容 —— 删除含参考补丁的本地 Git 信息、限制网络访问(Harbor 中智能体只能访问模型服务商端点,验证器完全不能访问网络)。
经验三:SFT 轨迹的推理深度比推理覆盖率更重要
思维链(CoT)是向教师模型学习的重要组成部分,但关键在于推理深度而非频率。开源数据集在 97%~100% 的轮次中包含 CoT,而 LegoFlow-SWE 仅 62%,但其平均推理长度 714 token,远超外部数据池的 181~309 token。
另外发现 GLM-5 在 100% 的轮次中触发推理(平均 82 token),其学生模型得 60.4/30.2(Verified/Pro);GLM-5.2 仅在 62% 的轮次中触发推理,但平均 500 token,成绩反而升至 64.4/46.9。按平均推理长度将数据池分为四个四分位后,最短组仅得 57.0%,其余三组随推理加深升至 64.0%~65.0%,因此倾向于保留深度思考的轨迹而非推理触发比例高的轨迹。更多实验细节参见实验报告。
- 实验报告:https://legox.net/blog/legoflow-experiments/
迈向递归式自我改进
LegoFlow-SWE 验证了单次流程的效果。接下来,团队利用评测反馈改进数据收集和训练,进行了一次端到端实验:涵盖仓库和 PR 收集、轨迹生成、训练、评测及策略优化,全程由智能体管理。
目标:从原始 GitHub 仓库出发,使用 Curator、Tracer、Trainer 和 Evaluator 构建训练数据并微调 Qwen3.5-35B-A3B-Base,用 512 条有效轨迹在 SWE-bench Verified 上达到 60.0% 以上解决率。
迭代 1:第一次尝试。Root block 协调工作流;Curator 从已合并的拉取请求构建 4,166 个可验证任务,Tracer 生成 915 条有效轨迹,流程按评分标准分数选出 500 条。训练后模型达 56.1%,未达 60% 目标。
迭代 2:改进轨迹过滤。第一次评测暴露两个数据问题:80.7% 的响应虽包含 <think> block,但许多只是「let me check」之类的短句,缺乏实质性调试;部分轨迹的工具调用格式无法被评测框架解析。智能体因此按推理密度过滤,并添加工具调用标准化步骤。
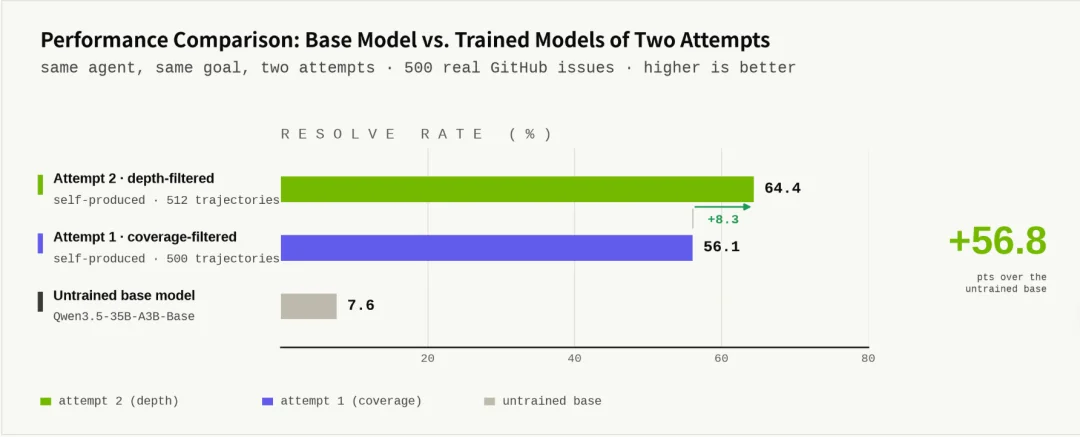
结果:在 915 条轨迹中,智能体删除 97 条重复和 234 条过浅轨迹;每轮推理长度中位数从 140 增至 959 字符,含推理内容的比例从 80.7% 降至 30.7%。用保留的 512 条轨迹训练,模型达 64.4% 解决率,超过目标。复现方法参见运行完整流程。
- 运行完整流程:https://legoflow-docs.legox.net/docs/running-blocks/full-pipeline
下一步
团队正在沿三个方向扩展 LegoFlow:
- TerminalBench:正在把 Terminal-Lego 工作迁移升级到 LegoFlow,纳入 Terminal-Bench 3.0 与 Terminal-Bench 4.0 的新变化。
- ProgramBench 与 NL2Repo:正在挖掘更复杂、长程的软件工程任务,以可执行程序或自然语言需求为起点。
- 递归式自我改进(RSI):随着更强的智能体出现,团队相信抽象化设计与执行反馈能够支持更通用、长期运行的自我改进系统。
目前,LegoFlow 的数据、代码、文档已全部开源,欢迎体验、star,同时也请大家关注团队的相关工作:LegoX,这是一个 Agent 数据开源集合,包含高质量长程任务,轨迹,一起搭建智能体的积木。代表工作还有 Lego-RL、SWE-Lego。
- LegoX:https://legox.net
- Lego-RL:https://github.com/LegoX/Lego-RL
- SWE-Lego:https://www.legox.net/blog/swe-lego/
感兴趣的朋友们,欢迎大家在评论区聊聊!
文章来自于微信公众号 “机器之心”,作者 “机器之心”
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0