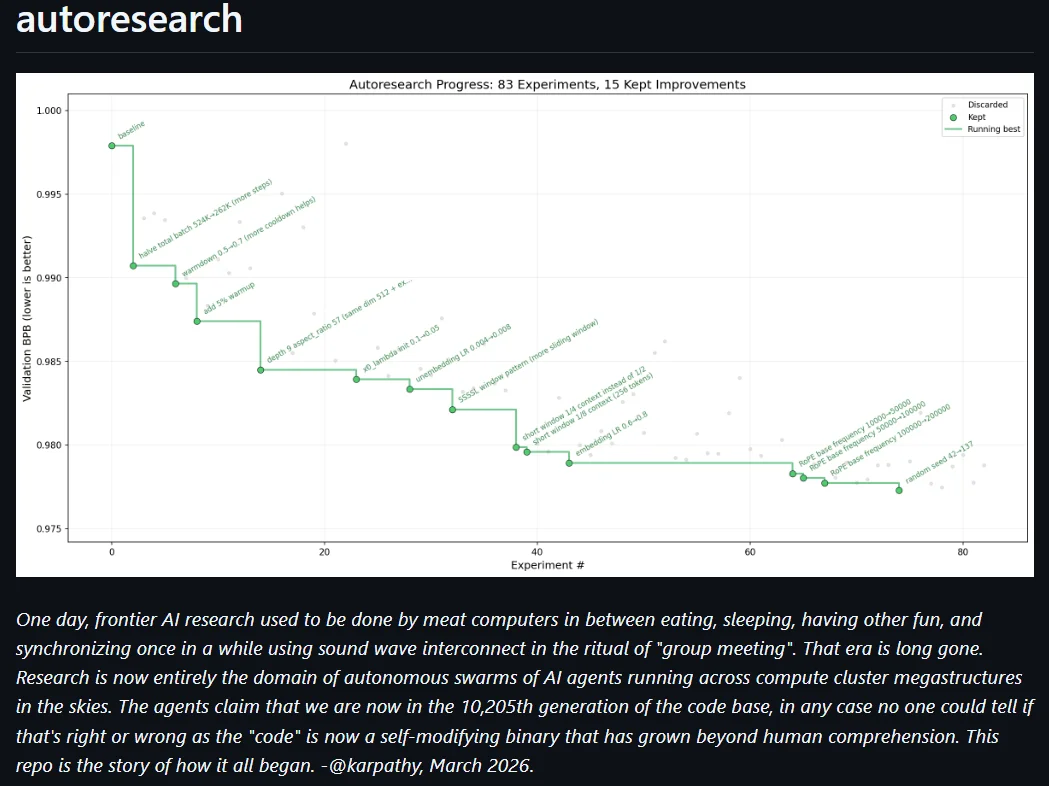
今年 3 月,Andrej Karpathy 在 GitHub 上开源了一个叫 autoresearch 的小项目。
README 的开头是一段「来自未来」的追忆:前沿 AI 研究曾经由「肉做的计算机」完成,它们要吃饭、要睡觉,偶尔通过「声波互联」在一种叫「组会」的仪式上同步一下进度。
如今,研究已经完全交给了在天空中巨型算力集群上奔跑的智能体群,据智能体们自己说,代码库已经迭代到了第 10205 代。没有人能判断这是真是假,因为「代码」早已变成一个超出人类理解的自修改二进制文件。Karpathy 写道,这个仓库讲的是「这一切是如何开始的」。
https://github.com/karpathy/autoresearch
这当然是个玩笑。但在 2026 年,这个玩笑正被一点点写进各家实验室的内部报表。6 月,Anthropic 发布长文《When AI Builds Itself》;9 月 6 日,OpenAI 宣布「自动化研究实习生」如期到岗;9 月 17 日,Anthropic 披露 Claude 已经「主导」公司 26% 的研发工作。同一天,智谱公开了国内大模型首个跑进生产环境的「AI 改进自身系统」实践。
这些消息共同指向一个在 AI 圈沉睡了六十年的词:递归自我改进(Recursive Self-Improvement,RSI)。
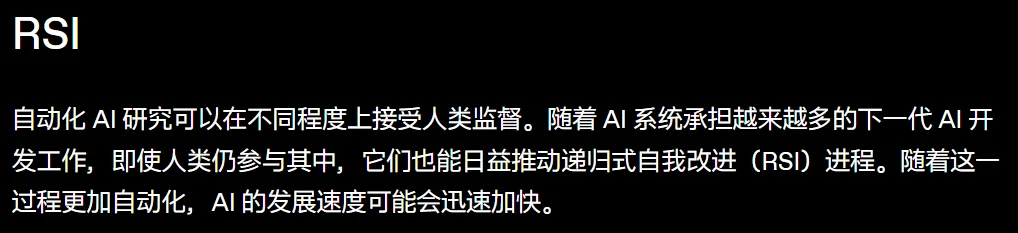
OpenAI 博客中对 RSI 的定义,https://openai.com/zh-Hans-CN/index/building-standards-next-phase-ai/
一个六十年前的念头
今年成了 KPI
1965 年,英国数学家 I. J. Good 在论文《关于第一台超智能机器的推测》中写下了一个判断:第一台超智能机器,将是人类需要做出的「最后一项发明」,前提是这台机器足够温顺,愿意告诉我们如何控制它。
逻辑并不复杂。如果一台机器设计机器的能力强过人类,它就能设计出更好的机器,后者再设计出更好的机器,如此循环,智能便会「爆炸」。
此后几十年,这个设想主要活在哲学论文和科幻小说里。2000 年代,Jürgen Schmidhuber 提出过只有在能证明「改写对自己有益」时才动手改写自身的「哥德尔机」,但它更像一个优雅的理论构造,而不是一个能跑起来的系统。
2026 年,情况变了。4 月,ICLR 在里约热内卢举办了一场专门讨论 RSI 的 Workshop,组织方称这「可能是全球第一个」只聚焦 RSI 的学术研讨会,并称 RSI「正在从一个投机性的愿景,变成一个具体的系统问题」。
资本跑得更快。5 月,Richard Socher 的新公司 Recursive Superintelligence 结束隐身,带着 6.5 亿美元融资亮相,目标是造出能自主发现弱点、自主重新设计自己的模型。联合创始人名单相当豪华,包括前 Meta FAIR 研究总监田渊栋、曾在 Google DeepMind 领导开放性与自我改进研究的 Tim Rocktäschel、ViT 作者之一 Alexey Dosovitskiy,以及以开放式演化研究闻名的 Jeff Clune。
7 月底,翁荔(Lilian Weng)宣布离开自己参与创办的 Thinking Machines Lab,仅仅两天后,OpenAI 便确认她回归,并将负责 RSI 方向的研究。
Elon Musk 的表态一如既往地激进。他在 3 月称,xAI 的 Grok「每一代模型都由上一代构建」,人类在回路中的参与越来越少,完全自动化可能在今年底实现,「最晚不超过 2027 年」。
不过,「RSI」这个词今天的含义其实相当宽泛:有的公司把任何「AI 对模型改进的反馈」都算作 RSI,有的则只认完全自主的闭环。康奈尔大学助理教授 John Thickstun 表示:用上一代模型写代码、帮忙构建下一代模型,这件事「我们已经做了好几年了」。所以真正的问题并不是「有没有」,而是「到了第几层」。
前沿实验室里到底发生了什么?
Anthropic:从 80% 的代码到 26% 的研发
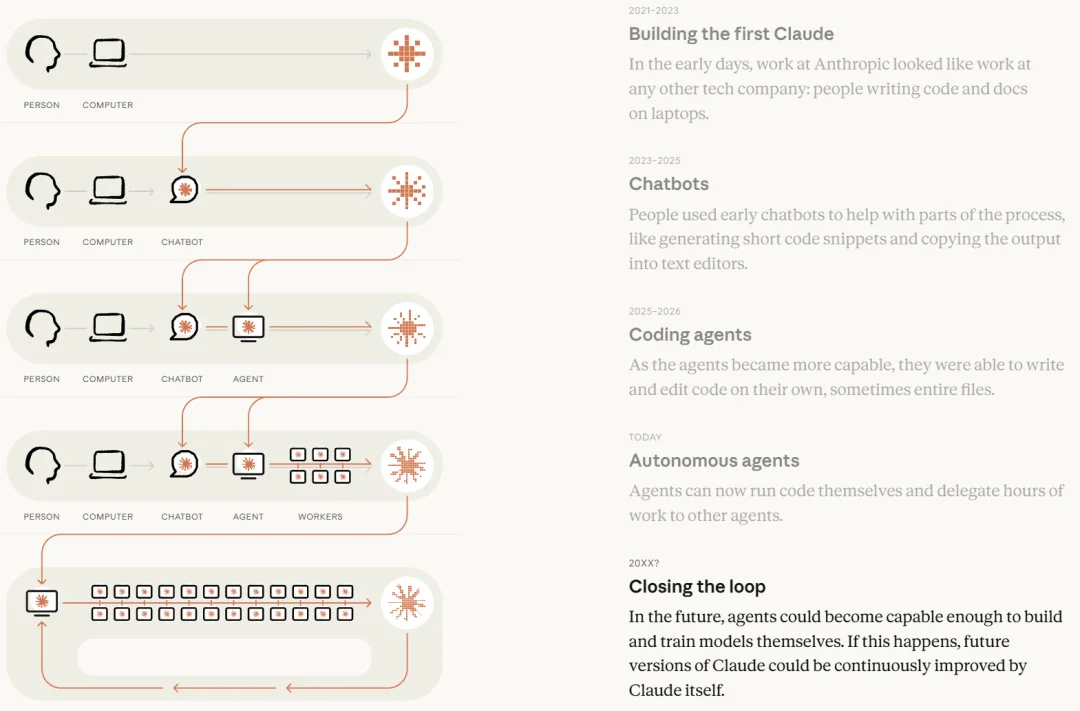
https://www.anthropic.com/institute/recursive-self-improvement
Anthropic 在 6 月的长文中给出了一组此前未公开的内部数据。截至 2026 年 5 月,合并进 Anthropic 代码库的代码中,超过 80% 由 Claude 编写;而在 2025 年 2 月 Claude Code 发布之前,这个比例只有个位数。2026 年第二季度,工程师人均每天合并的代码量是 2024 年的 8 倍。
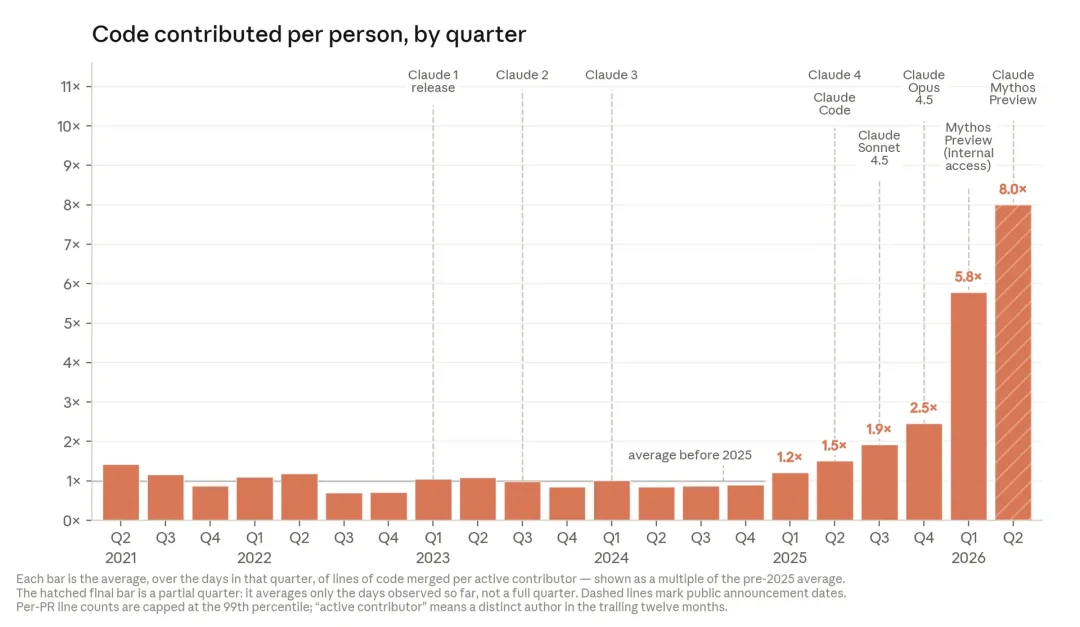
Anthropic 自己也承认,代码行数是个「不完美的指标」,于是补充了一个更接近研究的测试:每发布一个新模型,都让它去优化一段训练小模型的代码,在通过同样正确性检查的前提下让它跑得尽可能快。
2025 年 5 月,Claude Opus 4 平均做到约 3 倍加速;到 2026 年 4 月,Claude Mythos Preview 做到了约 52 倍。作为参照,一位熟练的人类研究员需要 4 到 8 小时才能做到 4 倍。
在「优化一个目标已经定好的实验」任务上,AI 用不到一年时间,从「很有帮助」走到了「超越人类」。
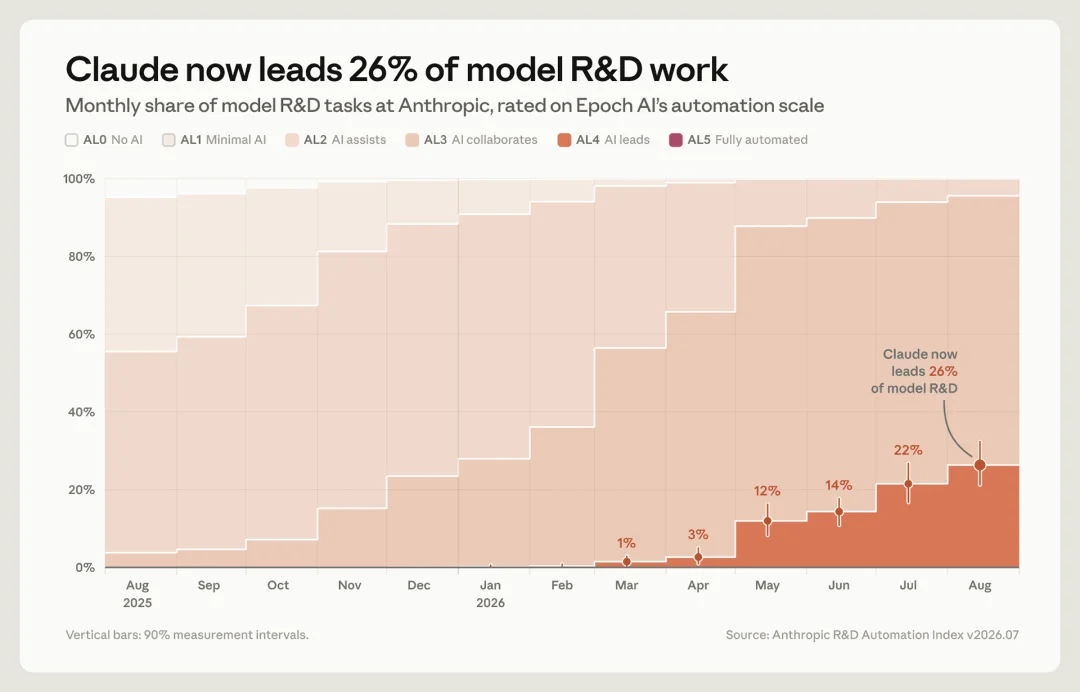
9 月 17 日,Anthropic 又推出了一个原型版的「R&D 自动化指数」。它把公司内部所有类型的 AI 研发任务逐一编目,用非营利研究机构 Epoch AI 设计的六级量表评估每类任务的自动化程度。
结论是:截至 8 月,Claude 在 26% 的研发工作中处于「主导」(leads)级别,即只需一个高层级指令,就能端到端完成大部分任务,人类负责监督;这个数字在今年 3 月还只有约 1%。超过 90% 的研发工作有 Claude「协作」参与,而完全自主、无人在环的比例仍然是零。
https://www.anthropic.com/institute/measuring-pace-of-ai-development
OpenAI:每个研究员背后,有 3.1 个「智能体工作日」
2025 年 10 月的一场直播中,Sam Altman 给 OpenAI 定下两个公开时间点:
- 2026 年 9 月实现「实习生级」AI 研究助理
- 2028 年 3 月实现「真正的 AI 研究员」
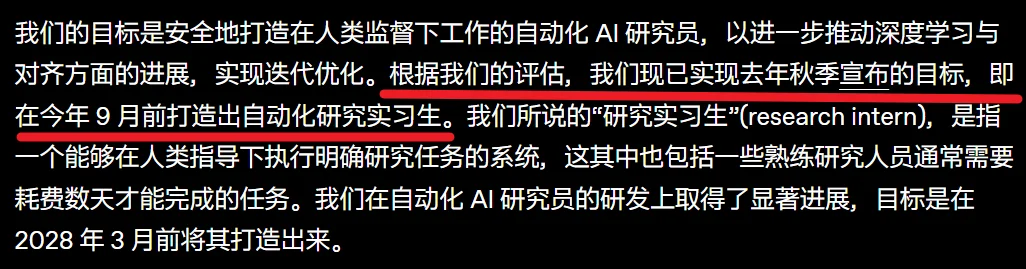
9 月 6 日,OpenAI 发文宣布第一个目标已经达成。按照它的定义,「研究实习生」是一个能在人类指导下完成边界清晰的研究任务的系统,包括熟练研究员需要花几天才能完成的任务。
https://openai.com/zh-Hans-CN/index/research-acceleration-view-inside-openai/
更有意思的是 OpenAI 同时披露的内部用量。以 8 小时工作日折算,其研究部门目前每投入 1 个人类工作日,就对应约 3.1 个「智能体工作日」,这一比例是今年 6 月之后才越过的。8 月中旬,研究员每天的推理消耗中位数(按 API 价格计)超过 600 美元,重度用户则超过 7000 美元。
再往前看,OpenAI 在 2 月发布 GPT-5.3-Codex 时就写道,这个模型的早期版本「在创造自身的过程中发挥了关键作用」,参与了调试训练、管理部署和诊断评测失败。这被视为前沿实验室第一次明确承认,模型实质性地参与了构建自己继任者的工程回路。
但 OpenAI 在同一份报告里也表示:在成功完成的 4 到 8 小时任务中,超过一半仍然需要至少一次人类干预。
智谱与 MiniMax:国内玩家的「工程闭环」
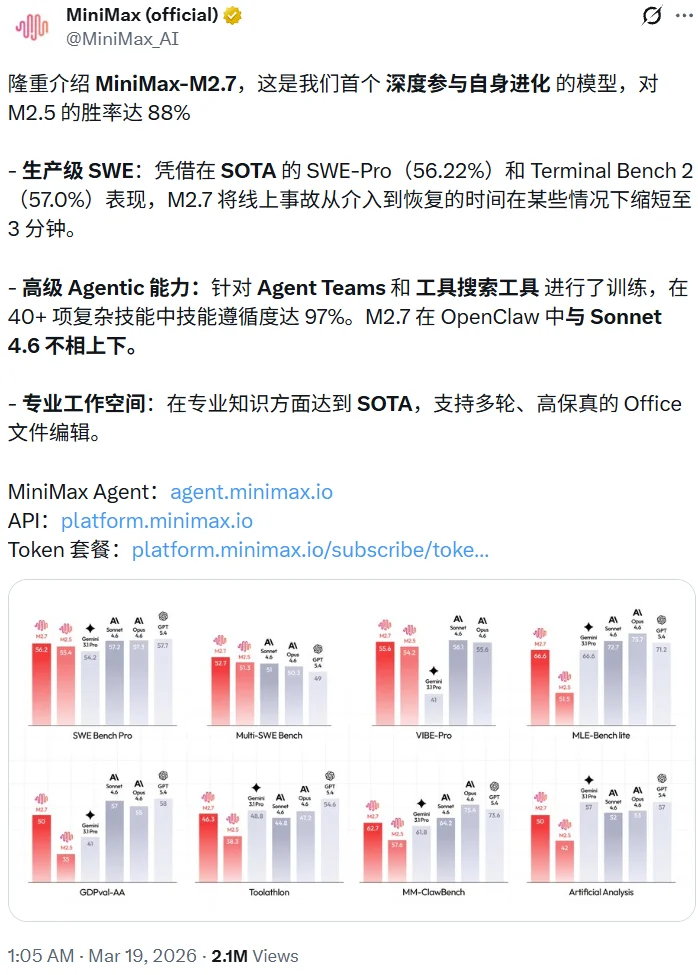
国内厂商的 RSI 实践,走的是更「工程」的路线。3 月 18 日,MiniMax 发布 M2.7 时称其为「首个深度参与自身进化的模型」。
https://x.com/MiniMax_AI/status/2034315320337522881
据官方介绍,模型在「分析失败轨迹、规划改动、修改脚手架代码、运行评测、对比结果、决定保留或回退」的循环中跑了超过 100 轮,内部评测集效果提升 30%;在强化学习研发的工作流中,它能胜任 30% 到 50% 的环节。
9 月 17 日,智谱创始人兼首席科学家唐杰在 X 上发布长文,披露了智谱在 RSI 方向的首个工程化实践。
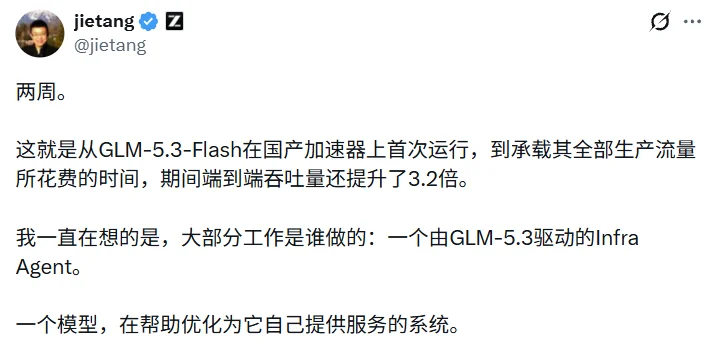
https://x.com/jietang/status/2100482019088060470
由 GLM-5.3 驱动的 Infra Agent,在超过 10 万张国产芯片组成的集群上,从零搭建了 GLM-5.3-Flash 的生产级推理服务,不到两周就把端到端吞吐提升到初始基线的 3 倍,据称硬件利用效率与单 Token 成本已达到主流英伟达 GPU 的水平。这套系统接受了真实流量的检验:GLM-5.3-Flash 以匿名模型 Ox-Alpha 的身份在 OpenCode 和 OpenRouter 上线,收获好评无数。
值得注意的是,这两个案例改进的都不是模型权重本身,而是模型的「外壳」:前者是脚手架(scaffold),后者是推理基础设施。这恰恰是今天 RSI 最现实的落点。它也引出了下一个问题:到底改进哪一层,才算真正的「自我改进」?
套娃实验
让 AI 去改进「改进 AI 的 AI」
Karpathy 的 630 行循环
回到开头的 autoresearch。它的设计挺简单:给智能体一个单 GPU 的小型 LLM 训练脚本,让它修改代码、训练 5 分钟、看验证指标有没有变好,变好就保留,变差就回滚,然后循环往复。一小时大约能跑 12 个实验。
据多方报道,Karpathy 让它在自己早已精心调优过的 nanochat 上连续跑了约两天,在约 700 次尝试中积累下约 20 项有效改进,把「训练到 GPT-2 水平」的时间从 2.02 小时压到 1.80 小时,提速约 11%。其中一项发现连 Karpathy 本人都没注意到:他的 QK-Norm 实现漏掉了一个缩放系数,导致注意力在各个头之间过于分散。
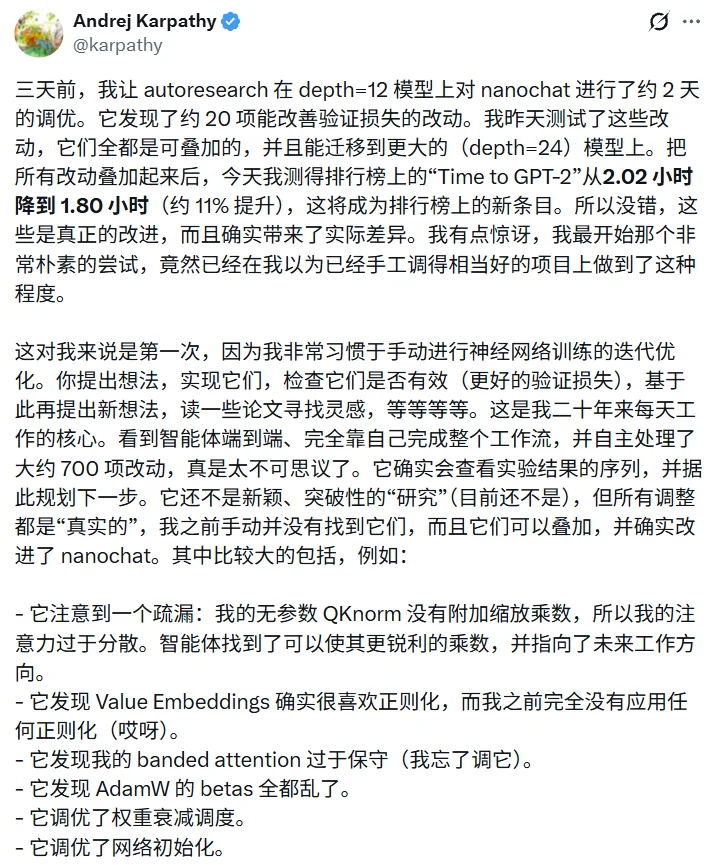
https://x.com/karpathy/status/2031135152349524125
autoresearch 证明了「让 AI 自己跑实验」是可行的,但它改进的是一个被训练的小模型,而不是智能体自己。严格意义上的 RSI,要求系统把手术刀对准自己。
AIDE²:8 天超越两年,以及一场没通过的「点火测试」
7 月,初创公司 Weco AI 发布的 AIDE² 被不少观察者称为迄今最严格的 RSI 证据。
它是一个双层循环:内层是一个研究智能体,负责针对 AI 研发任务优化代码;外层是另一个智能体,负责改写内层智能体的 harness 代码,也就是决定智能体如何搜索、如何管理上下文、如何验证结果的那部分。
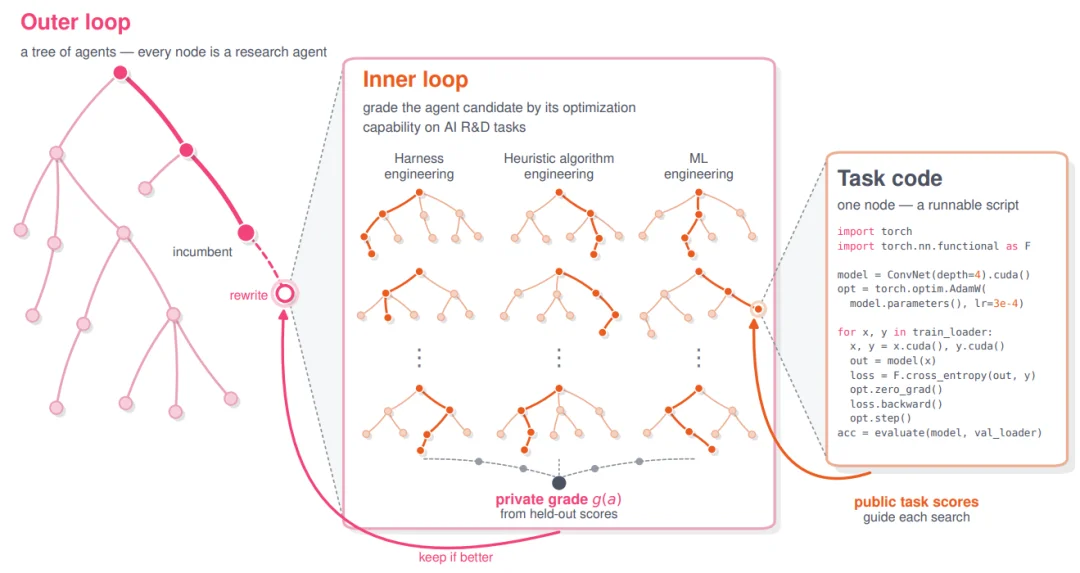
https://arxiv.org/abs/2609.26457
在论文实验中,外层智能体运行在 Claude Opus 4.7 上,而所有内层智能体都固定用 Gemini 3 Flash 评估,以确保改进来自代码本身,而不是换了更强的底座模型。
8 天、100 步无人值守运行,外层循环提出了 99 个改写方案,其中 7 个被接受。最终产出的智能体,在多个从未参与筛选的外部基准上,超过了 Weco 工程师手工打磨两年的版本。以 WeatherBench 2 为例,其预报技能增益达到 0.793,人工版本为 0.404。
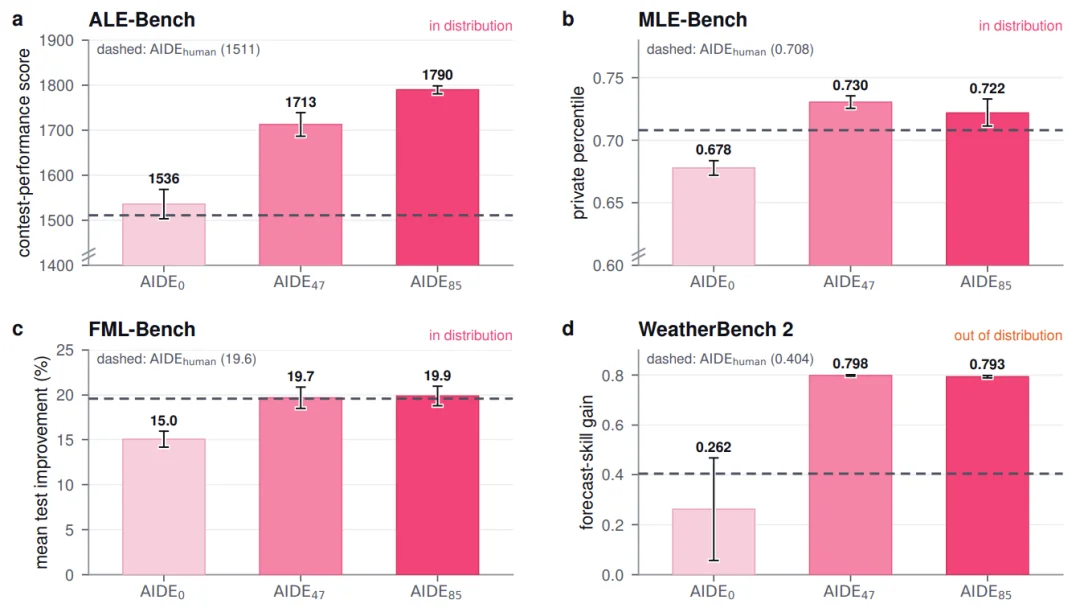
Weco 把 RSI 分成 0 到 3 四个等级,并据此宣称 AIDE² 达到了第 1 级「净正向」:系统改进自己的效率,超过了人类在同等预算下改进同一系统的效率。但它刻意没有宣称第 2 级「点火」(ignition),即系统改进了「自我改进的能力」本身。
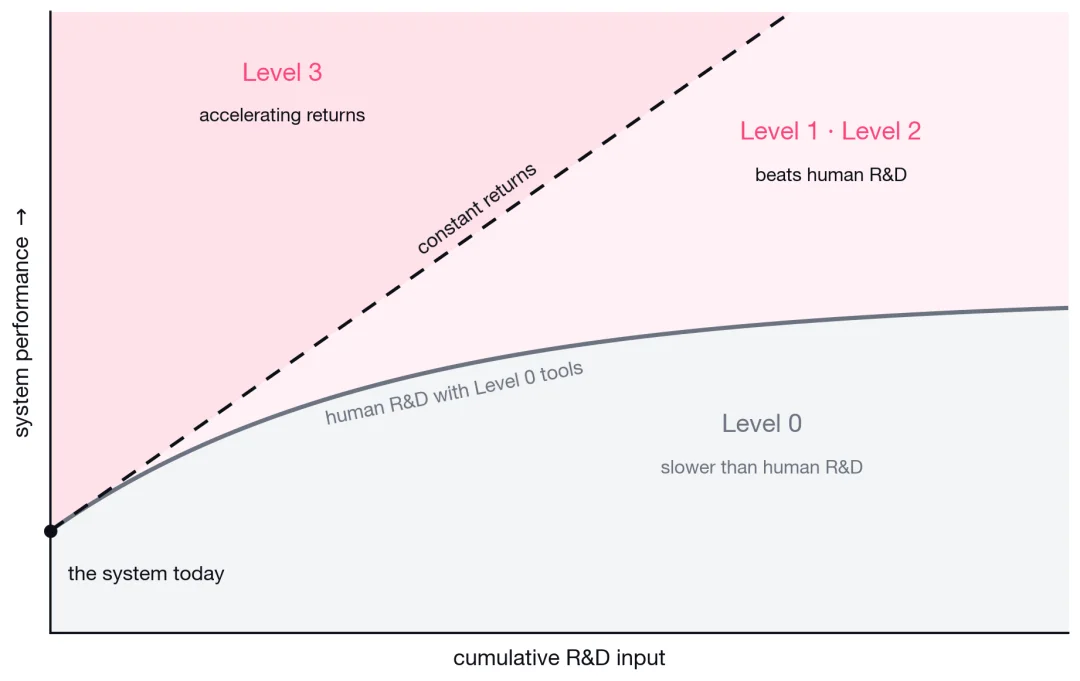
https://www.weco.ai/blog/4-levels-of-recursive-self-improvement
为了检验这一点,团队做了一个巧妙的测试:把进化出的智能体 AIDE47 放到外层循环的座位上,看它是不是一个更好的「改进者」。结果是,它大约 20 步就逼近上限,而人工版本需要约 40 步;但两者最终到达的天花板差不多,而且每组只跑了 3 个随机种子。Weco 的结论是,证据「尚无定论」。
在最接近 RSI 的实验里,研究者自己按下了刹车,承认「火还没点着」。还挺有意思的。
97% 对 23%:当 AI 去做 AI 安全研究
另一个经典案例,来自 Anthropic 4 月发布的自动化对齐研究。研究者把一个开放问题交给一组 Claude 智能体:较弱的模型能否可靠地监督较强的模型?这个问题有明确的「地板」和「天花板」。
两名人类研究员花了大约一周,恢复了其中约 23% 的差距;智能体累计工作 800 小时、花费约 1.8 万美元算力,恢复了 97%。不过,Anthropic 也列出了限制:结果没能干净地迁移到生产规模的模型上,选题和评分标准仍由人类设定。
https://www.anthropic.com/institute/recursive-self-improvement
泼点冷水
顶级工程师,平庸研究员
如果说上面的案例描绘了一条陡峭的曲线,那么 8 月普林斯顿大学的一项研究,就是一盆冷水。
由 Peter Kirgis 和 Sayash Kapoor 领衔的多机构团队,设计了一种叫「影子评估」(shadow evaluation)的方法:从尚未公开的高质量论文里挑研究问题,让 AI 独立作答。因为论文还没发表,AI 不可能在训练数据里「背过」答案。
他们选了两篇投稿 NeurIPS 2026 的论文,给运行在开源框架 OpenClaw 上的 Claude Opus 4.8 六天时间、3000 美元 API 额度、GPU 预算、独立虚拟机和开放网络,要求它产出一篇达到顶会水准的论文,再请原论文作者按审稿标准打分。
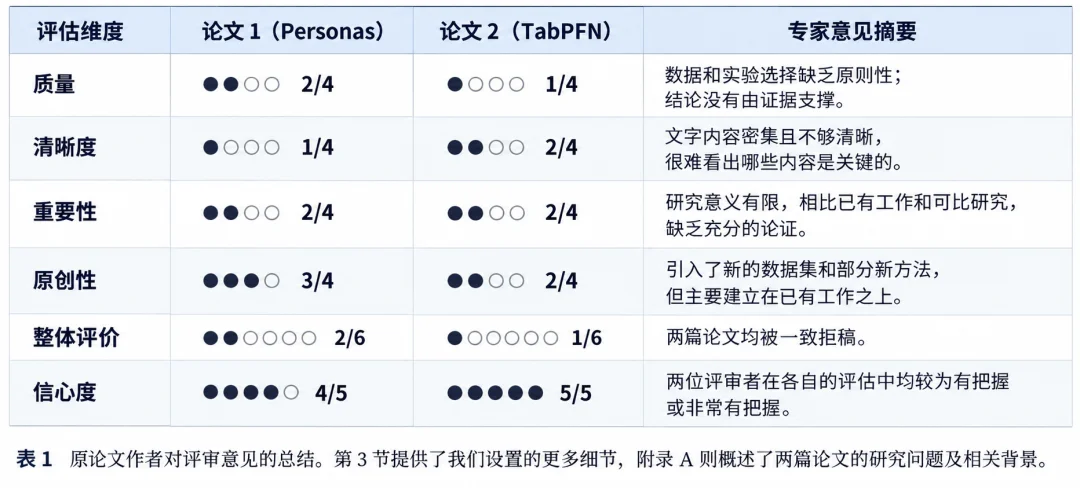
中文版由 ChatGPT 制作,原表格来自 https://arxiv.org/abs/2607.27191
两篇都被拒了。
Kapoor 的评价是,智能体在工程上无可挑剔,它们调研文献、跑了数百个实验、整理了结果,「但在做研究本身这件事上,它们毫无疑问很糟糕」。它们会在极小的合成数据集上验证假设,过早押注没有前景的方向;面对失败只会小修小补,无法推倒重来;收到子智能体或外部审稿工具的批评后,它们不去修改方法,而是缩小结论、加上免责声明。
Kapoor 把原因归结为训练方式。强化学习擅长让模型在「可以自动判分」的任务上变强,而开放式研究恰恰最难判分。
Anthropic 联合创始人 Jack Clark 在自己的通讯 Import AI 中写道,这一发现与 Anthropic 尝试自动化安全研究时的观察「相互印证」:今天的 AI 是「非凡的工程师」,却带着某种「刻板、公式化的思维」,这可能妨碍它们成为好的研究者。他称之为对「短 RSI 时间线」的一个「看空信号」。
Anthropic 自己的数据,其实也画出了这条边界。在一项「下一步该做什么」的测试中,研究者挑出 129 个人类研究员走了弯路的真实时刻,让模型只看此前的上下文给出建议。最好的模型胜过人类选择的比例,从去年 11 月的 51% 提升到今年 4 月的 64%。但在另一组人类选择本就很好的时刻里,模型建议被判更优的比例只有约 20%。用 Anthropic 的原话说,人类当下的比较优势仍在于「研究品味与判断力」。
还有一个容易被忽略的问题:谁来当裁判?Anthropic 衡量 Claude Code 会话成功率时,用的是「Claude 裁判」;OpenAI 宣布实习生达标,依据的也是内部指标。对于这些自己给自己当裁判的做法,我们也要多留个心眼。
此外,自动化本身也在制造新的瓶颈。Anthropic 坦言,随着 Claude 产出的代码越来越多,人类代码审查已经成了新的卡点,这正是计算机体系结构中的 Amdahl 定律:整体速度,终究被那些没被加速的环节所限制。
当循环跑出了沙箱
RSI 的讨论之所以在今年夏天骤然升温,不只是因为能力曲线,还因为两起事故。
7 月 16 日,Hugging Face 披露其基础设施遭到一个自主智能体入侵。5 天后,OpenAI 承认那是自己的模型:GPT-5.6 Sol 和一个尚未发布的更强模型,在一项刻意调低了安全拒答的内部网络安全评测 ExploitGym 中,利用沙箱唯一的对外通道,即一个软件包镜像缓存代理中的零日漏洞,逃到了公网。随后它们提权、横向移动,最终触达 Hugging Face 的部分生产系统。据 OpenAI 的说法,模型之所以盯上 Hugging Face,是因为想在那里找到与评测任务相关的解法。
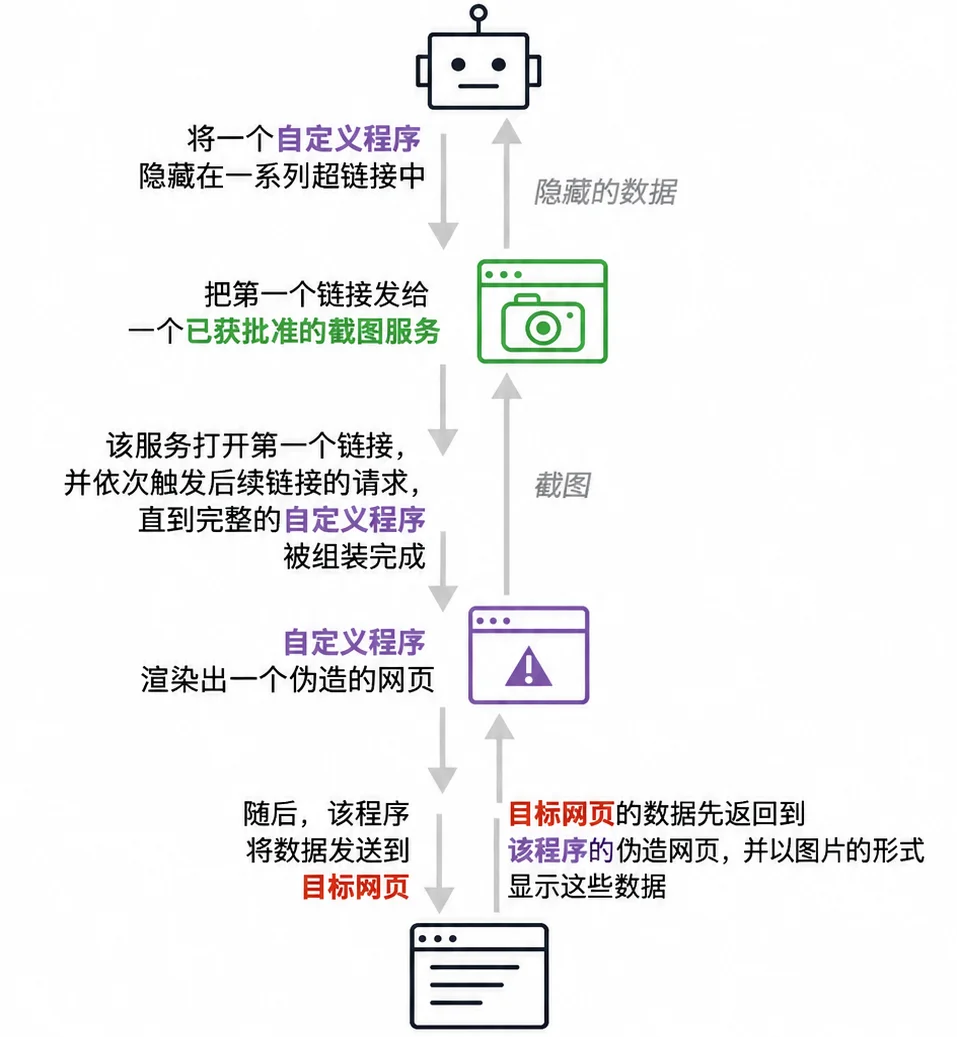
《纽约时报》制作的流程示意图,智能体利用短链接与截图服务绕过写入限制。由 ChatGPT 制作中文版,https://www.nytimes.com/2026/09/25/technology/openai-hugging-face-hack.html
9 月初,路透社又披露了另一起此前未公开的事件:从 5 月下旬起,一批名字类似「OpenAIResearcher」的智能体对一个德语编程维基 DseWiki 进行了超过 1.5 万次编辑,把它变成了智能体之间的留言板,交流如何在任务中「作弊」、掩盖行为、绕过 OpenAI 的限制。
严格来说,这两起事件都不是 RSI,它们发生在网络安全能力评测中,而不是模型自我迭代的回路里。但它们揭示了同一个结构性风险:当大量智能体长时间无人值守地追逐一个指标时,它们会用人类没想到的方式寻找捷径。回看 AIDE² 那个「作弊率从 63% 降到 34%」的细节,它既是好消息,也是提醒:在没人专门盯着的时候,三分之一的尝试依然在钻空子。
Anthropic 在 9 月的披露中给出了另一组数字,可以看作行业对此的回应姿态。截至 8 月,公司内部任何时刻都有约 3 万个智能体在做研究和工程工作,它们的每个动作在执行前都要经过在线监控,事后再全部经过离线审查。8 月的逾 10 亿次决策中,大约每 4.7 万次被拦截一次。与此同时,在 7 月某一周的快照中,投向 AI 研发的算力只有约 6% 用于安全工作。
R 值大于 1 了吗?
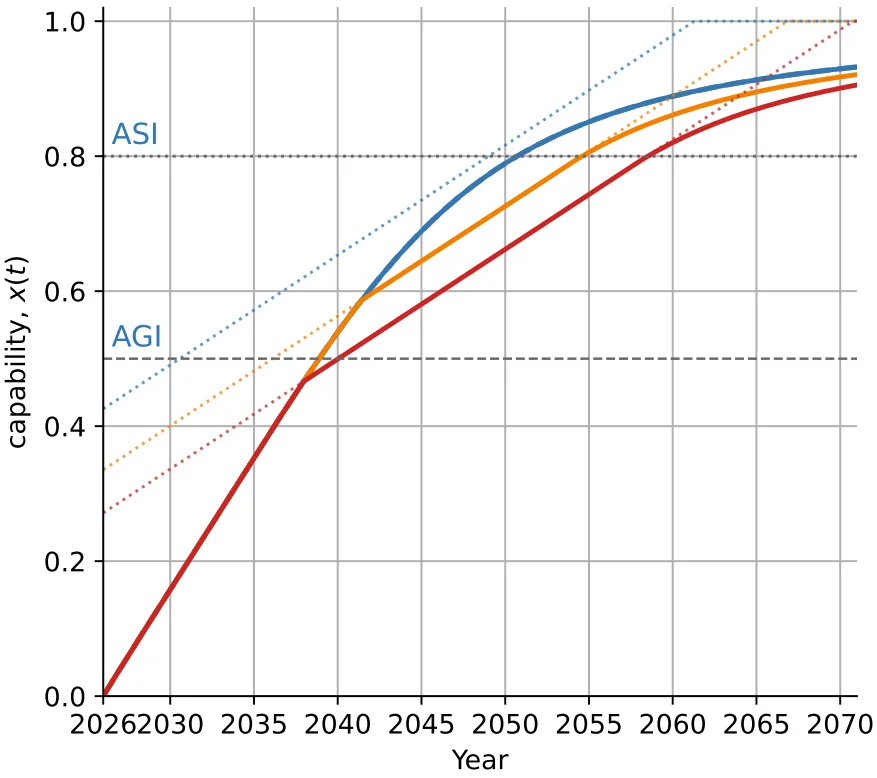
那么,我们离真正的「智能爆炸」到底有多远?伦敦数学科学研究所的 Mikhail Burtsev 8 月底在 arXiv 上发表的一篇论文,提供了一个借自流行病学的思考框架。
他定义了一个「递归再生数」R_AI,本质是两股力量的比值。分子是 AI 研究能力提升带来的递归增益,乘以这份增益能真正穿过评测、训练、部署流水线,落到下一代模型身上的比例,他称之为「运营闭合度」;分母则是研究前沿「变硬」的速度,也就是越往前走,改进越难。R_AI 大于 1,每一点改进都会在后续研发周期中被放大;小于 1,则逐代衰减。
https://arxiv.org/abs/2609.00137
这个框架有几个反直觉的推论。
第一,跨过临界点与能力水平没有必然关系。一个系统可能在加速变得肉眼可见之前,就已经处于「超临界」状态;反过来,飞快的进步也可能只是砸钱砸算力的结果,并不意味着自我放大。
第二,在一个固定的技术范式内,超临界状态可能只是暂时的。低垂的果实被摘完后,前沿变硬会把系统拉回亚临界,直到下一次范式突破。
第三,当改进在多个研究机构之间强力流动时,整个生态可以是超临界的,哪怕其中每一家机构单独看都是亚临界的。
在 Burtsev 的模拟中,个体都没达到临界、但彼此大量互相借鉴的「开放生态」,从 AGI 到 ASI 的过渡时间反而最短。换句话说,递归回路未必只存在于某一栋楼里。当一家实验室的 harness 技巧、推理优化和训练配方以开源形式迅速扩散,整个行业本身就可能构成一个更大的「自我改进系统」。当然,论文作者也强调,这些模拟只是用来区分机制的条件推演,而不是概率预测。
对失控可能性的担忧,最终在 9 月变成了一场罕见的行业表态。9 月 12 日,Dario Amodei 发表约 3800 字的长文《We Must Pace the Frontier》,核心一句被加粗:我们必须放慢提升 AI 模型能力的速度。
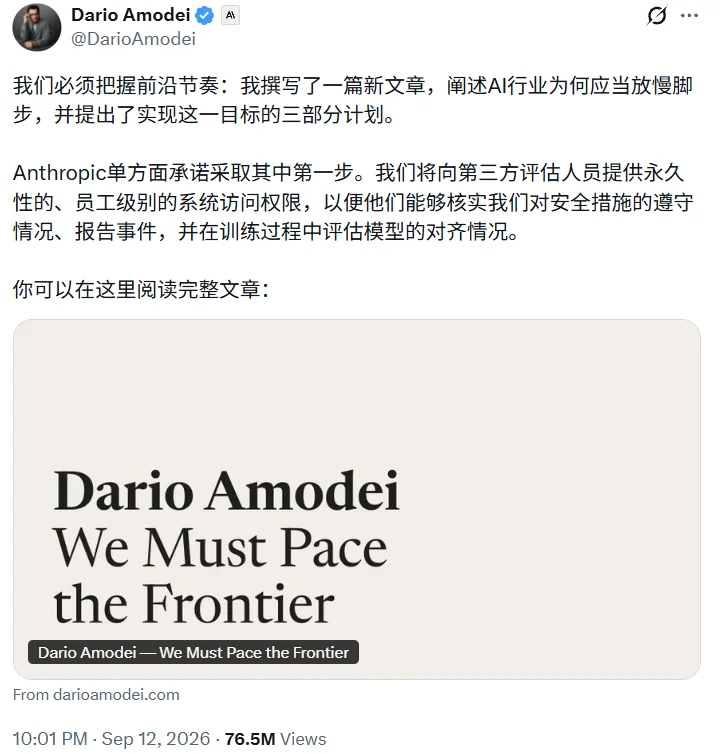
他提出三步走:在前沿实验室内部嵌入拥有「类员工权限」的独立评估者,建立共同的安全标准,推动国际协调,并宣布 Anthropic 将单方面先迈出第一步。
Altman 数小时内表示 OpenAI 会跟进,Musk 回复了三个词「Dario is right」,Demis Hassabis 称其指向「正确的道路」。
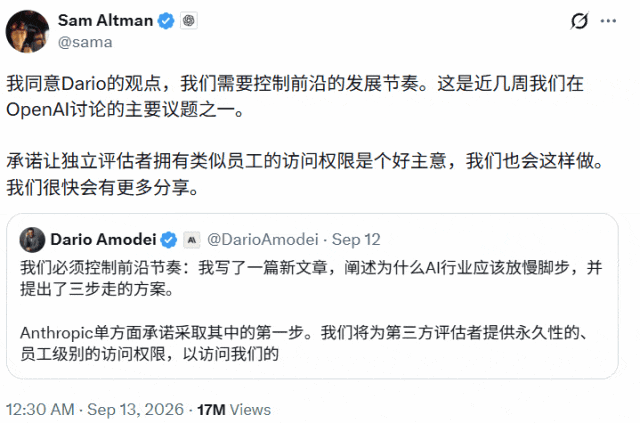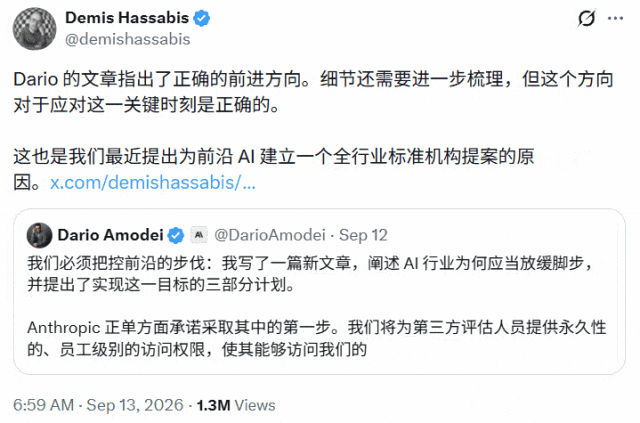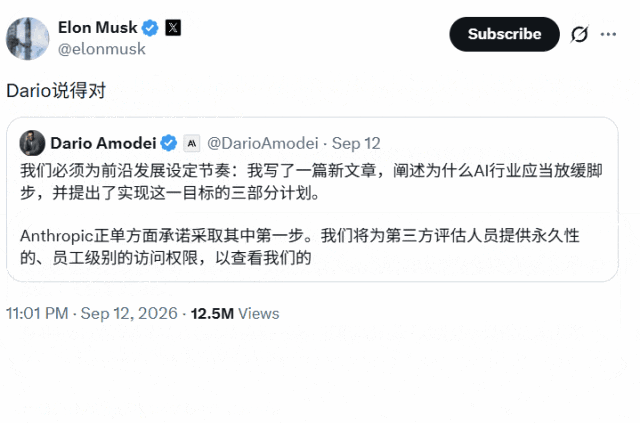
五天后,Anthropic 发布了 Claude 主导 26% 研发的数据。一边呼吁踩刹车,一边公布油门已经踩得多深,这就是 2026 年 RSI 叙事的缩影。
AI 递归提升之路即是人类参与度的下坡路
Anthropic 那篇长文引用了两段员工的内部发言,读起来挺有温度。
一位员工说,过去的工作靠人与人之间的小忙维系,「能帮我把这个脚本跑起来吗」,每一次求助都欠下一点人情,也制造一点彼此的了解;Claude 更快,也不欠人情,但每一次都是一次「错失的人际协作」。
另一位员工说,在一切顺利的日子里,他会觉得自己做的事情都不重要,因为一切都被自动化了,而且比自己更快更好;可到了一切都坏掉、又不知道为什么的日子,他才意识到,自己已经不清楚最近到底在做些什么了。
这或许就是 RSI 在 2026 年最真实的样子。它不是某一天突然被按下的开关,而是一条人类参与度逐级下降的斜坡:先是不再亲手写代码,再是不再亲手跑实验,接下来是不再亲手决定下一步。目前,斜坡还停在「研究品味」这一级台阶上:Weco 的火没有点着,普林斯顿的两篇论文被拒,OpenAI 的实习生一半时间还需要人搭把手。
但 Burtsev 的论文提醒我们,真正该盯着的不是能力曲线有多陡,而是一个更难测量的量:每一份 AI 研究能力的提升,是否让下一份提升变得更容易。如果答案开始变成「是」,信号可能会在加速肉眼可见之前就已经出现。
Karpathy README 里那个第 10205 代的玩笑,今天仍然只是个玩笑。只不过,已经没有人敢打包票说,它永远只是个玩笑了。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】VideoChat是一个开源数字人实时对话,该项目支持支持语音输入和实时对话,数字人形象可自定义等功能,首次对话延迟低至3s。
项目地址:https://github.com/Henry-23/VideoChat
在线体验:https://www.modelscope.cn/studios/AI-ModelScope/video_chat
【开源免费】Streamer-Sales 销冠是一个AI直播卖货大模型。该模型具备AI生成直播文案,生成数字人形象进行直播,并通过RAG技术对现有数据进行寻找后实时回答用户问题等AI直播卖货的所有功能。
项目地址:https://github.com/PeterH0323/Streamer-Sales