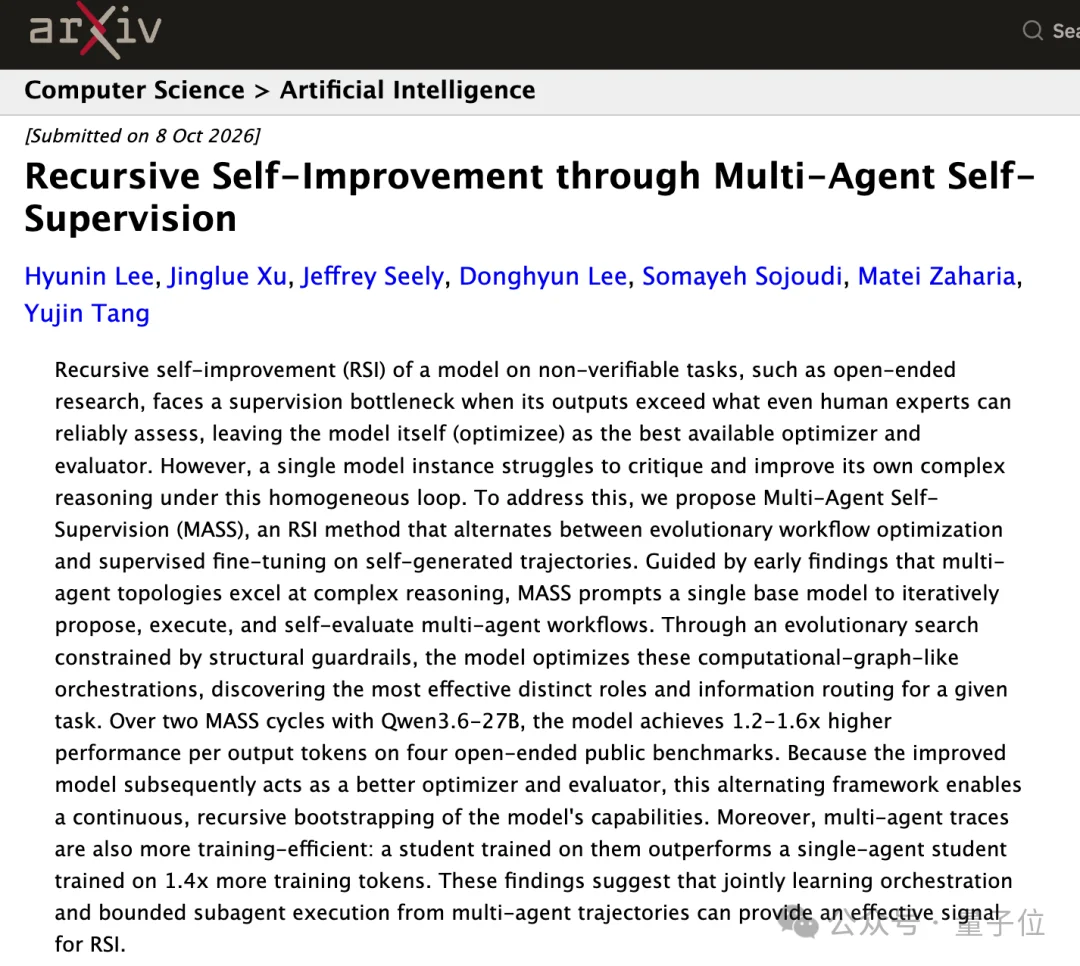
由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。
他们让同一个开源模型自己分身组队,像《火影忍者》中的漩涡鸣人一样,自己学会给分身派活、挑毛病、做训练,最后再把所有经验灌回本体,让下一轮自己更能打。
跑完两轮自我进化后,模型在多项开放式科研任务里的输出Token效率直接提升了1.2~1.6倍,自我评估准确率也从73%一路飙到了93%。
不愧是Transformer作者联合创办的公司啊,连自己卷自己都卷出了新花样、不烧心。
这项研究也证明了一件事:想要实现RSI,不一定非要依赖更强大的人类训练师或更大体量的导师模型。
AI自己分身组队,就能在内部把自己卷上天…
一个模型分饰三角,自己给自己搭班子
模型自己教自己,之前最头疼的问题是什么?
同质化盲区。
如果让单个模型自己写答案、自己打分、自己改错,它很容易在自己的偏见里打转。
因为它本来就不知道自己的错在哪,所以所谓的自我反思,往往只是把错误答案换个语气再强化一遍。
为了打破这个死循环,研究团队搬出了明斯基在《心智社会》里的经典构想:把一个复杂智能体拆成多个简单组件的协作系统。
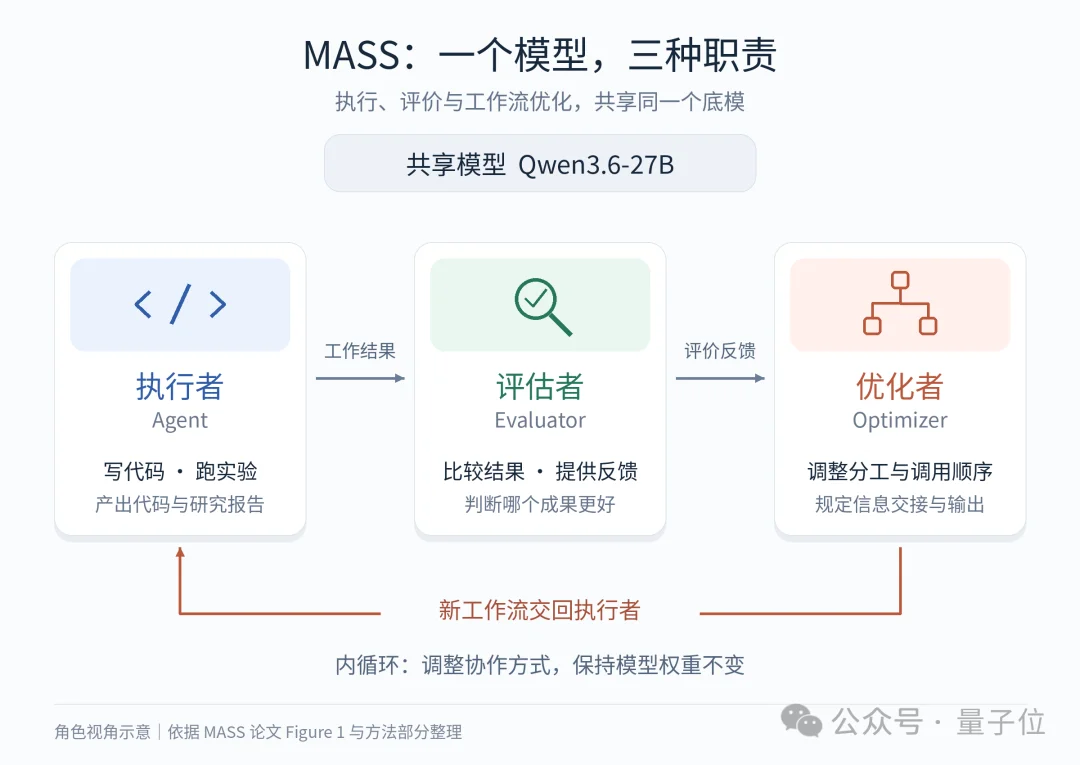
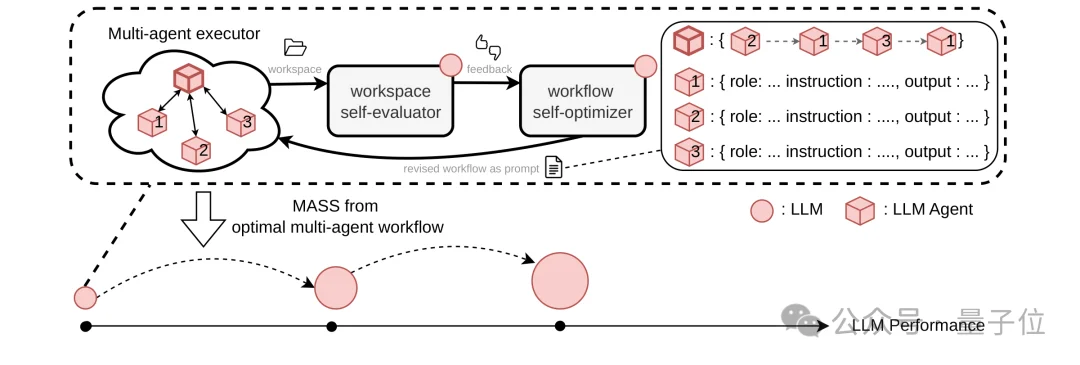
在MASS框架里,研究团队基于Qwen3.6-27B,让同一个模型同时在底层扮演三个角色:
- 执行者(Agent):负责老老实实写代码、跑实验。
- 评估者(Evaluator):对执行者产出的工作结果进行横向打分和挑刺。
- 优化者(Optimizer):根据评估者的反馈,动态调整团队里各个分身的角色分工、调用顺序和信息交接规则。
整个训练被切成了内圈和外圈两个循环。
内循环在模型权重完全固定的状态下进行,优化者不断调整由纯文本定义的多智能体工作流,规定谁向谁汇报、每个子节点要交付什么输出契约。
评估者则负责在旁边裁判,一路优胜劣汰,筛选出当前版本最擅长搞科研的黄金工作流。
外循环则是把这套黄金工作流跑出来的优秀多智能体协作轨迹收集起来,对模型底模做一次监督微调(SFT)。
把这套分身协作的本领内化进模型权重之后,新一代模型出炉,立刻无缝接管执行者、评估者和优化者这三个角色,接着开启下一轮套娃。
卷完两轮,效率飙升但偏科严重
那自己跟自己组队卷了两轮,效果究竟怎么样?
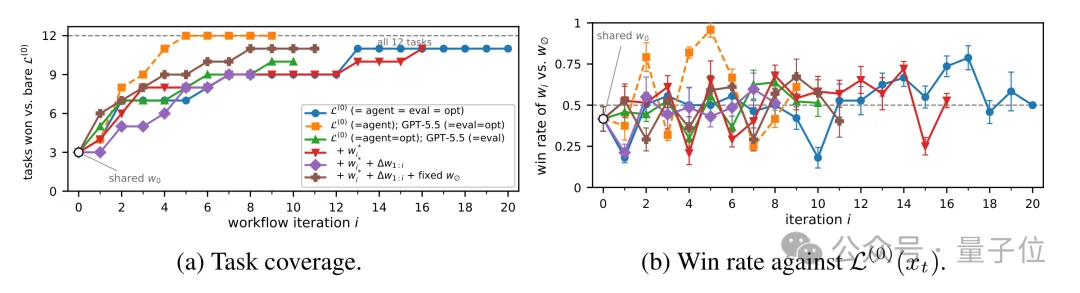
研究团队在涵盖金融、机器人、制药等长程研究任务以及多个公开基准上拉出来遛了遛,数据可以说是相当惊艳。
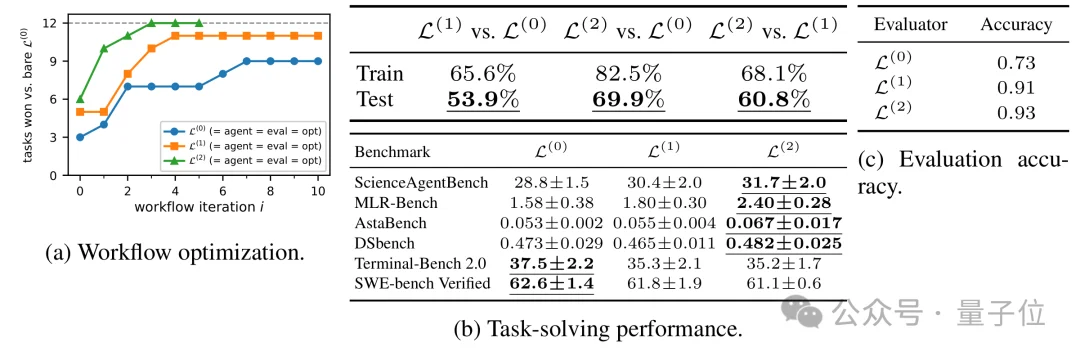
在三个测试任务里,第二代模型面对初始基模的胜率直接从第一代的53.9%冲到了69.9%。
在ScienceAgentBench、MLR-Bench、DSBench、AstaBench四个开放式研究基准上,第二代模型每输出一个Token带来的得分提升了1.2~1.6倍。
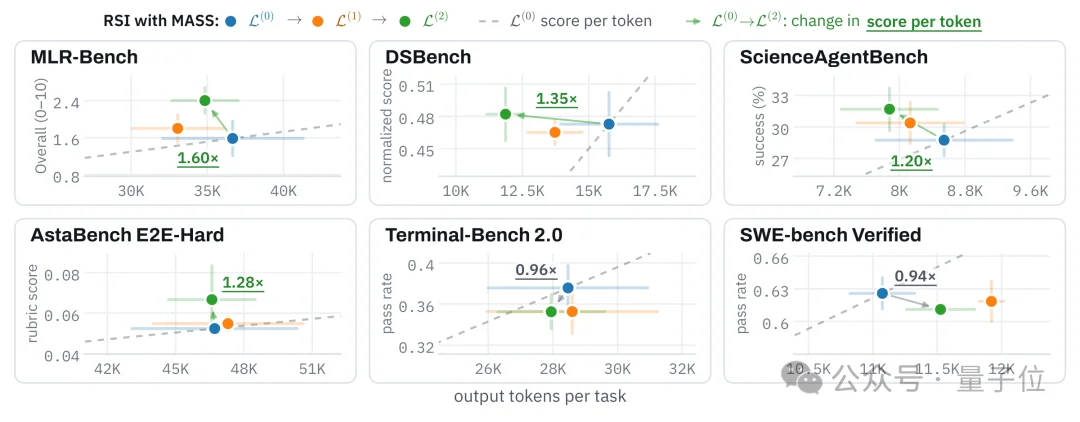
这说明它干科研不再像以前那样车轱辘话连篇,而是学会了直奔主题。
更神的是自评能力的迁移。
微调过程只用了任务求解的轨迹数据,根本没专门训练模型的裁判能力。
但第二代模型在自我评估上的准确率,却从初始模型的73%一路蹿到了93%,找高质量工作流的速度也明显变快了。
不过,研究团队并没有把这项成果吹上天,直接在论文里交代了局限:
1、他们只验证了两轮循环。到底能套娃迭代多少代而不发生模型崩溃,目前还是个未知数。
2、偏科现象很明显。在开放式科研和数据分析上进步神速,但在SWE-bench Verified和Terminal-Bench 2.0这类硬核软件工程与终端基准测试中,成绩并没有同步改善。
3、工作流搜索容易翻车。优化器改动工作流时偶发性能暴跌,文本上微调几个词,结果却可能天差地别。
这么看来,当前制约RSI进化速度的核心瓶颈,其实依然卡在优化器本身的生成水平上…
为什么多智能体轨迹能打赢单智能体?
那么多智能体的数据,凭什么就能比单智能体强?
为了摸清这个底细,研究人员做了一组对比实验,结果太恐怖了。
他们用不同的轨迹数据去微调同一个Qwen3.6-27B底模,结果发现:
- 喂给模型多智能体轨迹(M+),消耗了28.82M训练Token,对基模的胜率达到了68.3%。
- 喂给模型单智能体轨迹(S++),足足灌了42M训练Token(多用了约1.4倍数据),胜率却只有64.0%。
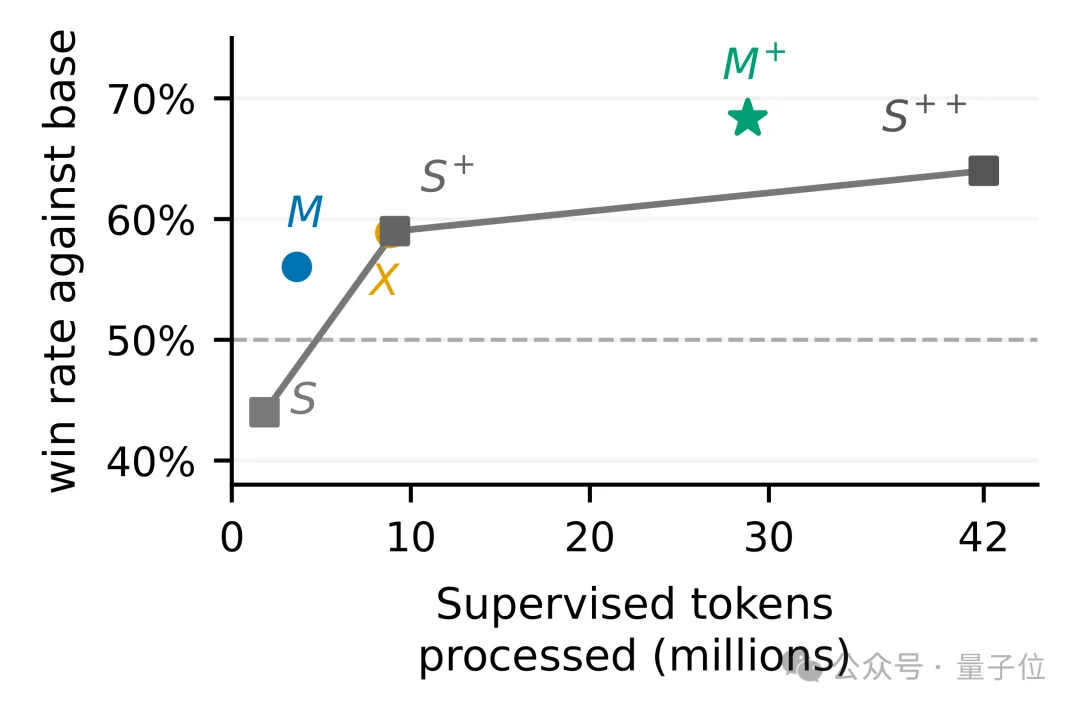
少用了31.4%的Token,但多智能体数据训练出来的模型却把单智能体按在地上打。
那么为什么会出现这种降维打击?
秘密或许在于任务的认知解耦。
在单智能体轨迹里,模型既要想宏观架构,又要抠具体代码,长程上下文混在一起极难学习。
而在多智能体协作里,总指挥只管拆解任务和核对产出,子智能体只管在局部边界里写代码。两类轨迹共同更新同一个权重,模型同时掌握了宏观调度和局部攻坚两种本领。
更关键的是,微调后的模型真正把这种协作直觉内化了。
在完全不给工作流提示词的裸奔状态下,初始模型自主发起子任务调用的概率只有1/110,而第二代模型直接暴涨到了87/110;
跨子智能体的代码交接行为也从1/110飙升到了83/110。
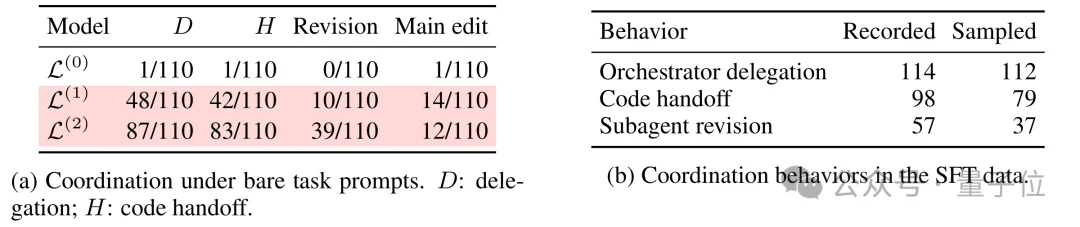
它不再需要人类在Prompt里苦口婆心地教它怎么分工,自己提笔就知道该叫分身出来干活了。
豪华天团:Transformer核心作者坐镇,伯克利与Spark之父深度联手
而搞出这项研究的Sakana AI,在业界也一直是个画风独特的物种。
2023年成立于东京,名字在日语里就是鱼的意思。
比起硬堆算力和暴力美学,他们更痴迷于从自然界、生物演化和复杂系统里找灵感,专门研究进化算法、模型融合和自主智能体。
而这份独特的学术基因,很大程度上源自其豪华的创始团队:
Sakana AI的联合创始人兼CTO Llion Jones为前谷歌老将,是改变整个AI时代历史的Transformer奠基论文《Attention Is All You Need》的八位核心作者之一。
△Llion Jones
在离开谷歌创办Sakana AI后,他带领团队持续探索超越传统前馈训练的新范式。
CEO David Ha曾领导Google Brain东京研究团队,是进化算法与创意AI领域的全球顶尖专家。
△David Ha
而除了创始人带来的Transformer正统底蕴与进化计算基因,这篇论文的具体作者阵容也同样堪称“全明星”,深度融合了Sakana AI 与 UC Berkeley的顶尖科研力量。
篇幅有限,咱们就简单说两个吧。
例如论文的一作Hyunin Lee,他既是加州大学伯克利分校机械工程系博士候选人,也曾以最高荣誉毕业于韩国首尔大学,曾先后在OpenAI和Meta担任研究实习生,拥有顶尖工业界与前沿学术界的复合背景。
△Hyunin Lee
又比如Matei Zaharia,他是伯克利EECS副教授,Databricks联合创始人兼CTO,也是Apache Spark项目的发起人。
△Matei Zaharia
真是大神齐聚啊,amazing。
参考链接:
[1]https://arxiv.org/abs/2610.12176v1
[2]https://x.com/LargitData1/status/2109306509423439889
文章来自于"量子位",作者 "文婷"。
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0