基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
这项工作来自哈尔滨工业大学(深圳)、新加坡国立大学 Show Lab 等机构。团队用机器人骨架监督视频中的潜在动作(latent action),让运动隐向量更准确地表征机器人的运动,物体响应等视觉变化则由另一个隐向量保留。真实控制指令由此有了专门的运动表示作为对齐目标。
在 DROID 的评测中,相比 DreamDojo,SkeLAM 的末端轨迹误差降低了 19.5%,感知距离 LPIPS 降低了 11.1%。
- 论文标题:Skeleton-Grounded Latent Action Model for Robot World Models
- 论文链接:https://aopolin-lv.github.io/SkeLAM/assets/SkeLAM.pdf
- 项目主页与视频:aopolin-lv.github.io/SkeLAM
人类视频作为提示:
零样本跨形态运动迁移
这组实验的输入是一段 UniSkill 人类演示视频,以及一张机器人场景图片。RGB 编码器从演示中提取潜在动作,世界模型据此在给定的机器人场景中生成后续视频。
人手向下推毛巾,生成的机械臂随之下探;换成人手向上抽纸,机械臂也转而抬起。人手与机械臂的外观、结构和所在场景都不同,演示中的运动方向仍然体现在生成结果中。相比之下,DreamDojo 在这两组示例中的末端位移较小。
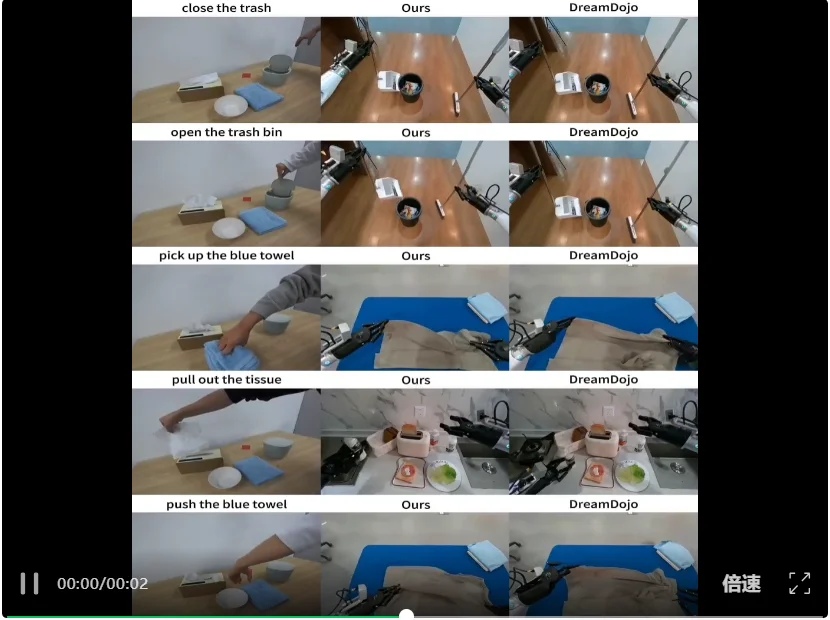
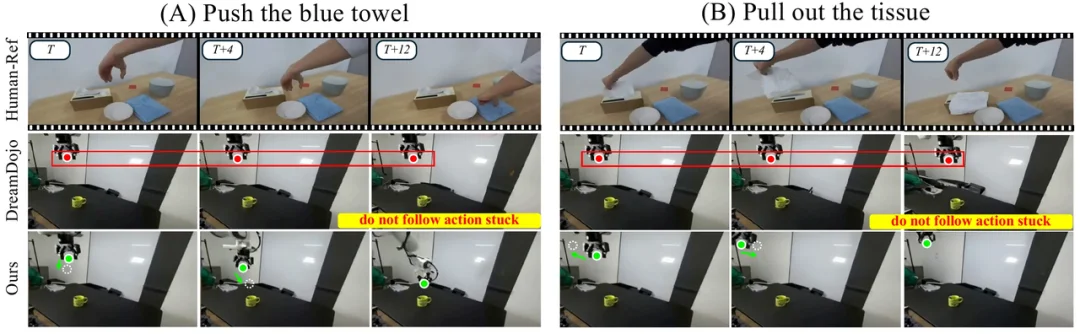
图 1|两组零样本迁移示例:向下推毛巾与向上抽纸。每组从上到下依次为人类演示、DreamDojo 和 SkeLAM,圆点标出了末端位置。机器人画面为模型生成结果。
人类演示在这里充当了推理时的运动上下文:更换演示,就能在这些例子中改变生成的运动,而无需更新模型参数。这是 in-context human-to-robot motion transfer 的一种具体形式,也为零样本跨形态运动迁移(zero-shot cross-embodiment motion transfer)提供了定性证据。
骨架监督,
让潜在动作更容易对齐真实控制
从视频中学习动作,首先要处理机械臂运动与物体响应混在一起的问题。机械臂向前移动,可能推走一个杯子,也可能什么都没碰到。控制指令可以相同,视频里的变化却不一样。如果这些变化都被编码到同一个潜在动作中,真实控制指令就需要对应一个随场景变化的目标。
SkeLAM 用骨架约束其中的运动分量。骨架记录机器人的关节位置和连接关系,为视频中的运动提供参照;另一部分残差表示则保留补充的视觉动态。两部分共同支持视频重建,也分别为世界模型提供条件。
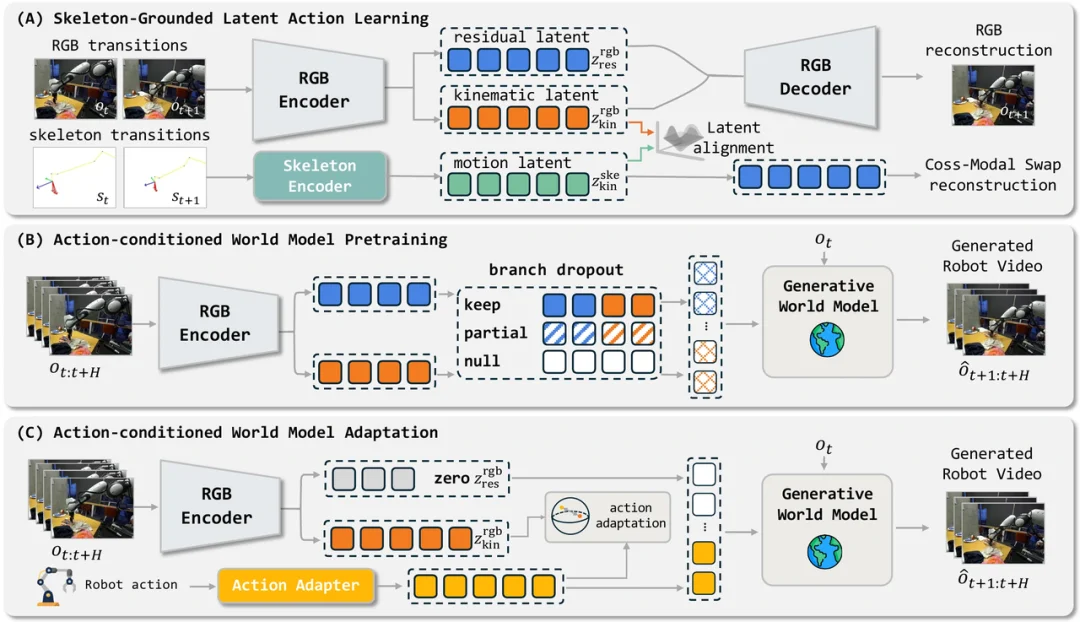
图 2|SkeLAM 方法概览。骨架监督视频中的运动表示,运动与残差分量分别为世界模型提供条件,动作适配器再把机器人指令映射到运动表示。
给潜在动作一个明确的运动参考
同样的机械臂运动,在不同接触状态下,可能带来不同的物体响应。这些变化都有助于重建视频,但当潜在动作同时包含运动与交互结果时,机器人控制指令就需要对应一个随场景变化的目标。
SkeLAM 用骨架来约束其中的运动分量。骨架保留了机器人关节的位置和连接关系,能比较直接地描述机器人怎么动;另一部分残差表示则保留补充的视觉动态。两部分共同支持视频重建,也分别为世界模型提供条件。
具体来说,骨架解码器会监督从 RGB 视频中提取的运动分量,使它能够预测对应的骨架变化。跨模态交换重建则进一步要求:将 RGB 重建中的运动分量替换成对应的骨架表示、保留原有残差后,模型仍需还原同一段画面变化。这样,视频与骨架表示之间的对应会直接影响重建结果。
为了将这套表示用于机器人控制,SkeLAM 训练了一个轻量的动作适配器,将真实机器人动作映射到运动分量,再用适配器预测的条件微调世界模型。推理时,模型根据当前画面和机器人动作生成未来视频,残差输入置零。
生成结果是否更贴近真实运动
在 DROID 评测中,对比 DreamDojo,SkeLAM 的末端轨迹误差 ADE 从 51.11 降至 41.15 像素,视觉距离 LPIPS 从 0.1473 降至 0.1310。前者衡量生成运动与参考轨迹的偏差,后者反映生成画面与真实视频的感知差异。
下面的对比展示了这些差异在画面中的表现。SkeLAM 更接近参考视频中的弯曲轨迹,也较好地保留了桌面布局。
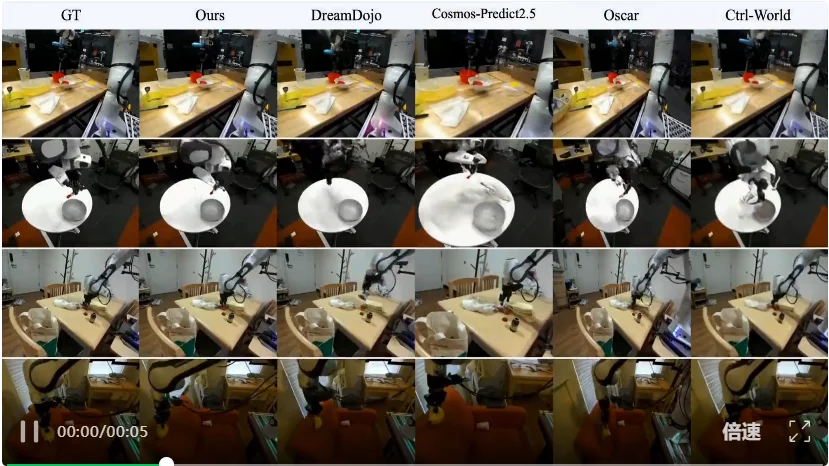
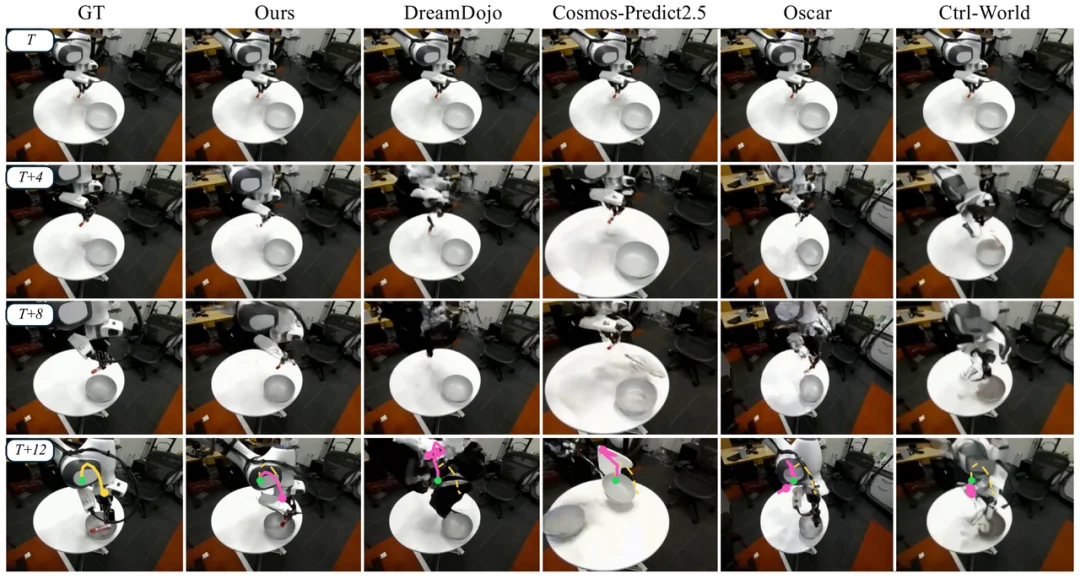
图 3|同一初始画面和机器人动作下的生成结果。最左列为真实视频,第二列为 SkeLAM;最后一行叠加了末端运动轨迹,方便比较生成运动与参考运动的偏差。
让更多人类视频成为机器人学习的资源
沿着这个方向,大规模人类操作视频,尤其是第一视角视频,有望成为机器人世界模型的运动来源。如果能从中稳定提取可迁移的动作表示,就有机会把更多人类演示用于机器人场景的视频生成,扩展可供模型学习的交互过程,并进一步探索它们在机器人策略训练与评估中的价值。
从这些生成结果走向真实机器人,还需要检验更复杂的接触与更长的操作过程,并评估生成的视频对策略学习和闭环执行的实际帮助。
完整论文、介绍视频与更多可视化结果见项目主页。
作者简介
- Qi Lv:本文第一作者,来自哈尔滨工业大学(深圳)与新加坡国立大学,相关研究涉及机器人操作、动作表征和世界模型。
- Jiayi Lin: 来自哈尔滨工业大学(深圳),相关研究涉及机器人操作、动作表征和世界模型。
- Yuxin Jiang:新加坡国立大学与 A*STAR 博士生,研究方向包括生成模型、视频世界模型及其在具身智能中的应用。
- Mike Shou Zheng:本文通讯作者,新加坡国立大学助理教授,研究方向包括视频理解与多模态智能。
文章来自于"机器之心",作者 "机器之心"。
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner