激动的心,颤抖的手。
Google的世界模型Genie 4,在我等了一年多以后,终于来了。
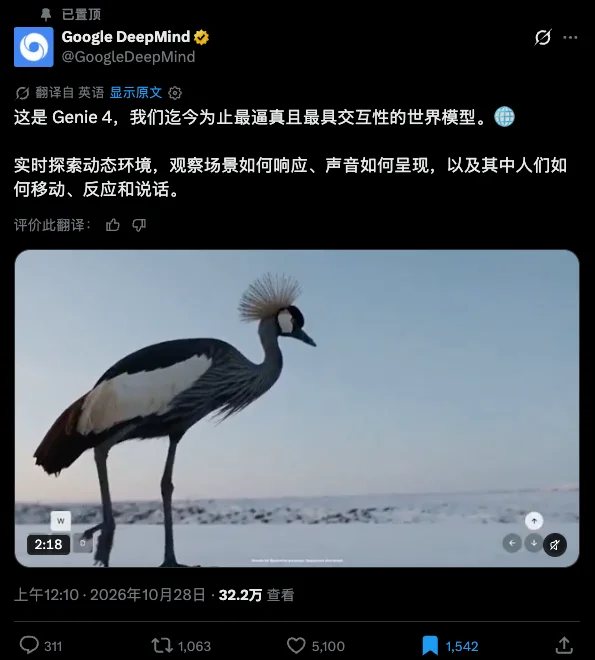
一年前的8月6号,Google的世界模型Genie 3发布,那天同时也是OpenAI久违的开源模型gpt-oss发布,那天早上6点发完gpt-oss后,躺在床上翻来覆去睡不着,脑子里全都是Genie 3的案例,最后干脆爬起来,又写了那一天的第二篇:Google重磅上线通用世界模型Genie 3 - 此即未来。
我真的很喜欢世界模型,这玩意,也是我过去几年最看好、最期待的AI技术方向之一。
因为作为一个将近20年的游戏玩家,以及这么多年的VR玩家,一个成熟的世界模型,在我心中,就像我们能控制的一场清明梦。
绚烂、多变、充满惊喜,一场可以永远不醒来的梦。
而现在,14个月过去了。
Google终于拿出了它的下一代世界模型,Genie 4。
这一次,真的又往前走了一大步。
所以这一篇,我也想跟大家好好聊聊Genie 4,聊聊它到底更新了什么,聊聊我心中和我认知的世界模型,还有世界模型,究竟会怎么改变游戏、互动还有影视。
先给大家看个官方演示。
一个第一人称视角,你骑在一头巨大的黑龙身上,抓紧缰绳,在群山和城堡之间高速穿梭,周围还有其他骑着巨龙的骑士,头顶是呼啸而过的天空,脚下是深不见底的山谷,你能听到巨龙拍打翅膀的轰鸣声,猛烈的高空风声,还有远处的火山和火焰声。
整个画面的真实感,以及骑龙飞行带来的那种速度感,真的已经超级棒了,这里注意,你会在画面的左下角看到WASD,右下角有个上下左右的箭头,如果是经常玩游戏的玩家肯定会非常熟悉,WASD对应的就是移动,右下角的箭头就是方向,跟游戏手柄或者是一些手游的双摇杆操作逻辑是一模一样的。而整个视频中你看到的绝大多数的变化,都是通过双摇杆直接实时控制的。
视频详情
Genie 4这种世界模型,与我们熟悉的Seedance、可灵之类的视频生成产品,有着非常大的区别。
AI视频生成,主要负责把一段内容生成出来,但是视频生成完以后,它就被固定了,你就只能沿着它已经确定的时间线往下看。
而世界模型,要解决的则是互动问题。
就像当你走进这个世界,并且开始改变它的时候,这个世界也会实时的响应你的互动。
你向左走,那世界要跟着变化;你推开一扇门,门后应该有合理的空间;你踢翻一把椅子,椅子应该倒下,然后你离开房间,过了一会儿再回来,椅子应该还在那里,除非有人把它偷了,但是谁没事会想偷椅子你说的对吧。
而这一切,都需要随着用户的操作,持续、实时地发生。
说得非常通俗一点,就是让AI从会拍视频,进化到会创造一个能够持续运行、并且能响应你所有操作和指令的世界。
这也是为什么我一直觉得,在我的心目中,世界模型的想象空间,要远远大于传统的AI视频。
而这次Genie 4,有几个特别明显的进步。
首先是画质、运动和物理交互。
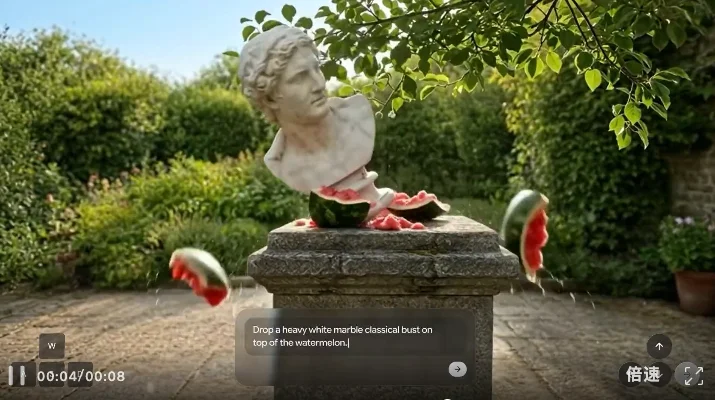
相比去年的Genie 3,这次官方展示的场景,已经有了更强的照片级真实感。
人物的动作更加自然,物体碰撞、空气动力学等复杂的物理现象,也有了更好的模拟能力。
从这两个Case中,应该可见一斑。

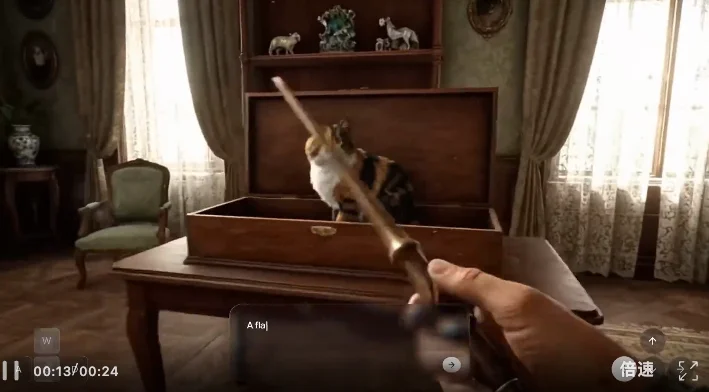
其次是世界的一致性和实时控制。
你可以通过键盘控制角色或镜头,也可以在世界运行过程中,直接用自然语言修改天气、加入新的物体、改变事件。
它会根据当前场景,继续生成接下来的变化,这一次因为整体模型的进步,效果变得非常的棒,延迟也很低。
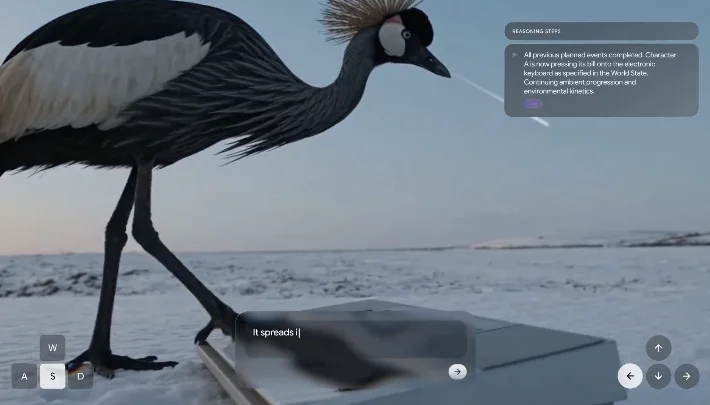
再然后,就是我特别喜欢的原生音频。
这一次,Genie 4终于可以在生成世界的同时,直接生成与世界同步的环境音、音乐性声音,以及人物之间的交互式对话。
这其实也是一个很大的跨越。
就像我们在玩比如《荒野大镖客2》这样的强调沉浸感的游戏的时候,为什么会觉得那个世界如此真实?
因为除了画面和游戏机制之外,还有大量精细设计的声音。比如马蹄踩在不同地面上的声音,酒馆里的人声,树林中的风声,以及远处的枪声,这些东西共同组成了我们对于一个世界的感知。
如果一个AI生成的世界有着无比逼真的画面,但没有任何声音,那种沉浸感其实很难真正建立起来。
而现在,Genie 4终于开始同时生成世界的视觉与听觉体验了。
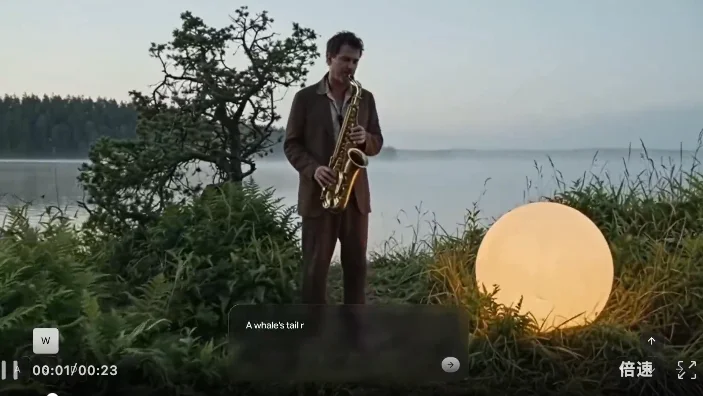
甚至这个世界里的人物,还可以实时说话,并对你或者周围发生的事件作出反应。
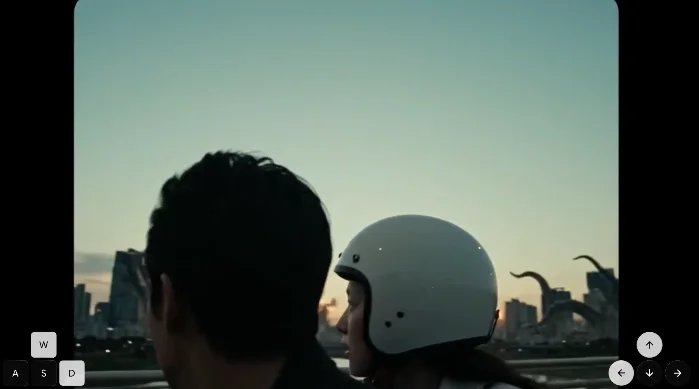
我觉得这一点,对于未来的游戏和VR互动,意义重大。
相信大家看完这些case以后,对Genie 4这个世界模型,会有一些感知了,当然,我也知道很多朋友这时候也会问,这个世界模型,跟李飞飞之前做的世界模型,有啥区别啊?
所以,正好说到这里,我也想顺便科普一下世界模型如今一个特别有意思的技术分野。
今天大家口中的世界模型,其实存在着两种很有代表性的技术路线。
一条是以Google Genie为代表的,视频生成路线。
它的思路,是根据已经发生的画面、用户当前的操作,以及模型对世界的理解,不断预测并生成接下来的画面。
你往前走,它就生成往前走以后看到的世界,你转过身,它就需要生成身后的场景。
这条路线最大的优势,就是动态生成能力,世界可以随着你的每一个动作而发生变化,就像真正的造物主一样。
但它有个特别头疼的问题。
世界的一致性。
因为整个世界是在持续生成的,所以模型必须记住之前生成过什么,如果你刚才看到的是一个人穿着白色的背带裤,转过身再转回来,背带裤突然变成了蓝色,那这个世界就穿帮了。
而且,生成式世界的每一次运行都要持续消耗推理算力,时间一长,成本和稳定性都是问题,所以现在你很少能见到公开演示中,能够连续运行10分钟以上的生成式世界。
第二条是3D路线,也就是大家常说的高斯泼溅路线,最典型的代表,就是李飞飞的World Labs。
World Labs去年11月正式上线了Marble,你给它一段文字、一张照片、一段视频,或者用方块搭一个粗略的布局,它就生成一个完整的3D世界,用高斯泼溅渲染出来,比如没渲染完的时候就是这样。
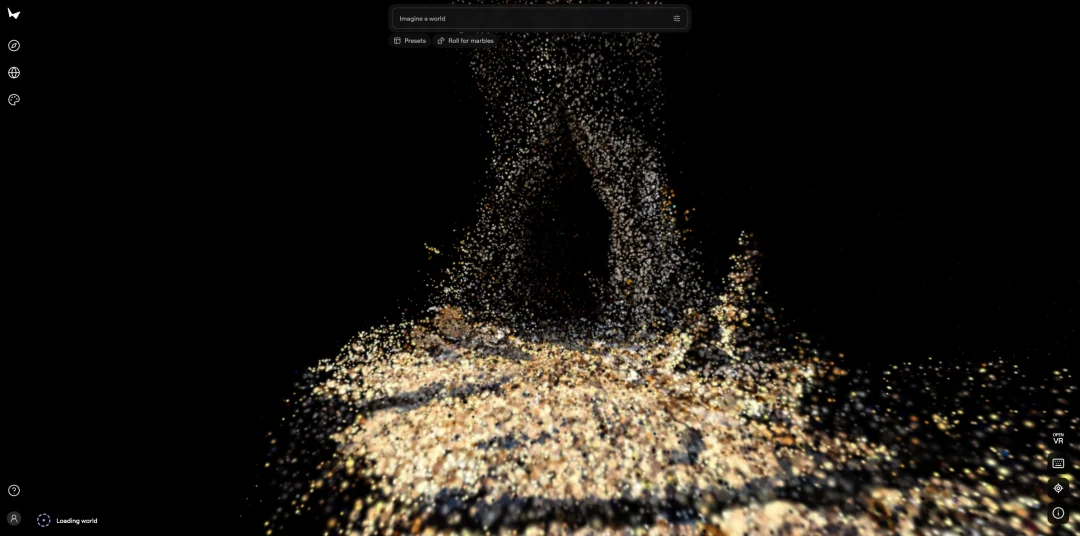
完整的长这样。
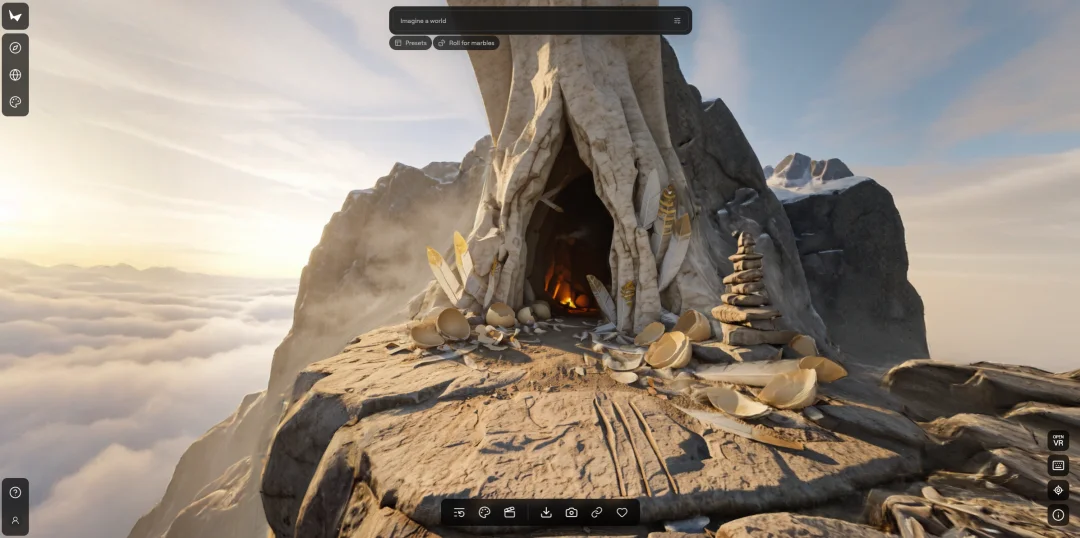
完整版大概两百万个高斯点,可以导出成高斯泼溅文件,也可以导出成普通的网格模型,能直接丢进Unity、虚幻、Blender里用,还能戴着VR设备进去逛。
这条路的长处,正好是视频路线的短处。因为你生成完的世界是实打实存在的,你回头一百次,它都还是那个样子。而且渲染便宜,一台头显就跑得动,还能导出,直接接进现在的游戏和影视管线。
它的短处,也正好是视频路线的长处,因为他们生成的世界是静态的,里面的所有角色都动不了,一些动画和特效都得导到引擎里再自己加。
所以这两条路,都各有各的问题。
不过现在,已经开始在合流了。
最典型的就是World Labs自己。今年9月1号,他们发了一个新模型叫Atlas,官方管它叫全能世界模型。
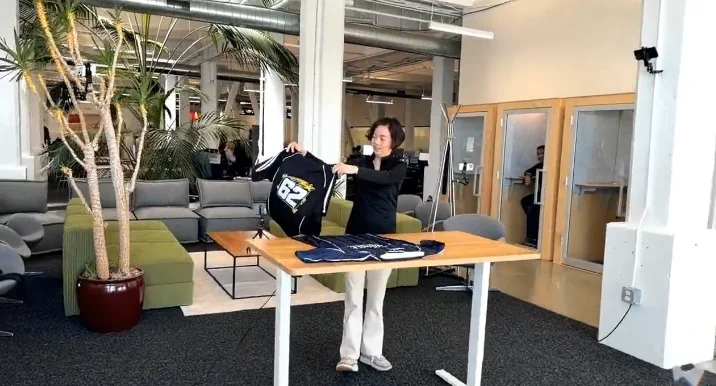
它最出圈的一个演示是,用三台架在三脚架上的普通手机拍一段画面,Atlas能把时间定住,从任意一个新角度重新渲染,就是类似《黑客帝国》里那种子弹时间。
要知道当年拍那个镜头,剧组是在演员周围架了一圈上百台相机,前几天Tim给Vogue做的子弹时间,也是用了70台iPhone 18 Pro。
Atlas的底层,是一个从零训练的多模态扩散Transformer,能直接生成最长1分钟的1440p视频,还能从输入的视频里把空间和时间一起建模出来,每一帧都有明确的摄像机位置与方向约束,所以非常的精准,同时还能输出点云和3D高斯泼溅,用的就是Marble那一套,他们也说,以后的新版Marble会由它来驱动。
而Google这次给出的,是另一种合流的办法。
视频路线除了记性差,还有一个更大的问题,就是即使强如Genie 4,在长因果的表现上,还是比较一般。
所以他们想了一个办法,就是在生成的过程中,塞进一个Gemini。
比如Gemini 3.8 Flash,Google叫它引导智能体,Genie 4实时生成世界的时候,它一直看着画面,把目标拆成一步一步,再一帧帧检查每一步是不是真的完成了,你中途插手,或者世界自己变了,它就当场改计划。
Google还展示了Gemini 4 Argon与Genie 4协同工作,模拟Apptronik的Apollo人形机器人下跳棋。
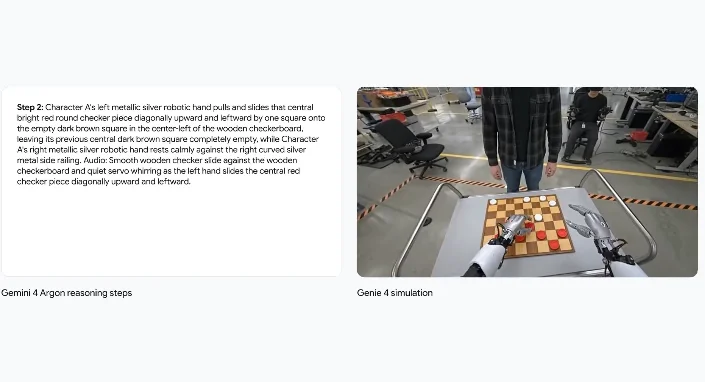
现在Google尝试的这套架构,相当于让Gemini在幕后持续观察、规划和引导,让Genie负责生成世界的视觉、声音以及动态变化。
一个负责理解目标、规划行为,另一个负责呈现这个世界,以及行动带来的结果,而新发生的事情,又会反过来影响下一步的规划。
我觉得,如果这套系统能够继续进步,最终带来的想象空间,真的会非常恐怖。
因为对游戏来说,特别是开放世界这块,你会发现,玩家对于自由的渴望,永远比开发者能够提前制作的内容更多。
哪怕今天最优秀的3A游戏,也很难彻底解决这个矛盾。
像《荒野大镖客2》,整个世界已经做得非常细致了,但你在游戏里能触发哪些事件、跟NPC产生哪些互动,海量内容仍然需要R星提前设计。
《博德之门3》这种以丰富选择闻名的游戏,也依然需要庞大的团队,提前设计各种剧情、任务和交互规则,导致最后工期紧张,甚至整个上城区直接没做出来。
现代大型3A游戏动辄开发数年,投入数亿美金,其中大量成本都花在场景、资产、动画和各种内容的制作上。
但世界模型,真的可能会慢慢改变这件事。
比如未来你在《上古卷轴》里探索,突然遇到一个NPC,他告诉你家里的亲人失踪了,你接了这个任务,决定帮他寻找。
接下来,游戏可以根据原本的世界观、人物关系和任务规则,为你生成新的线索、场景和事件。
你在过程中做出的每一次选择,又会改变接下来的故事,而这一切,并不需要开发者提前把所有可能发生的剧情全部制作出来。
当然,我始终觉得,纯粹随机生成的游戏内容,大概率是不值得被消费也并不好玩的。
《博德之门3》还有《塞尔达传说》之所以伟大,很大一部分原因就在于它们那套精妙的规则,以及不同规则组合以后产生的复杂互动。
所以,未来的游戏制作可能需要更加重视一件事。
那就是尽可能的去设计世界的规则,并让AI承担越来越多世界细节的生成工作。
规则才是王道,这也是为什么任天堂一直以来都是游戏之神的原因。
并且除了游戏之外,互动影游也是一个特别棒的场景。
影游其实跟游戏也类似,虽然成本低很多,但你几乎所有的分支,都需要提前拍摄。
选择越多,需要提前准备的内容就越多,所以今天的互动影游,实际上仍然是一套分支数量有限的故事系统。
但有了世界模型,那就真的不太一样了。
这是一种全新的可被用户消费的内容生产逻辑。
我们交付的不再只是一个已经完成的故事,未来,我们交付的,很有可能是一个能够不断发生故事的世界。
这实在是太有趣了。
玩家和观众,甚至可以逐渐变成故事的共同创作者。
这可能,会诞生一种真正介于游戏、电影和互动叙事之间的全新媒介。
这种兴奋的感觉,真的久违了。
我不知道距离真正的《头号玩家》,我们还需要多少年。
但我真的非常期待。
当有一天,我们终于可以亲手创造一个属于自己的世界,并且真正走进去的时候。
那种感觉,一定很爽。
文章来自于微信公众号 “数字生命卡兹克”,作者 “数字生命卡兹克”
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md