家庭不需要万能机器人。
新物种 Sinovum 设立了「视界线(Event Horizon)」对谈栏目。
视界线,是黑洞的边缘——一旦跨过,既有规则将不再适用,变化变得不可逆。
我们借用这个概念,关注那些已经越过“临界点”的技术与企业:方向开始收敛,选择正在锁定,新的规则正在形成。
我们关心的是:在巨大的不确定性面前,他们如何看见未来?又如何以一个个关键判断为支点,推动整个行业越过那道无形的边界?
故事,正在视界线上发生。而「新物种」将成为忠实的记录者,与你一同见证。
以下是该系列的第 20 篇。
-Intro-
2025年12月的一天,适逢邓程的29岁生日。
那一天,他去了理想汽车,在理想AI周会给理想创始人李想和理想的同事们做了一场长达一个半小时的分享。
他讲了一件听起来和汽车没那么直接相关的事:如果Physical AI最终要跑在一块端侧芯片上,能不能在训练模型之前,就提前设计好效率最高的模型呢?
邓程的汇报引起了大家的讨论,李想也提出了几个问题,双方围绕模型与芯片的协同优化,以及相关研究在物理AI场景中的应用展开了交流。汇报结束时,李想把当晚晚些时候会发布的第一台AI眼镜Livis送给了邓程。
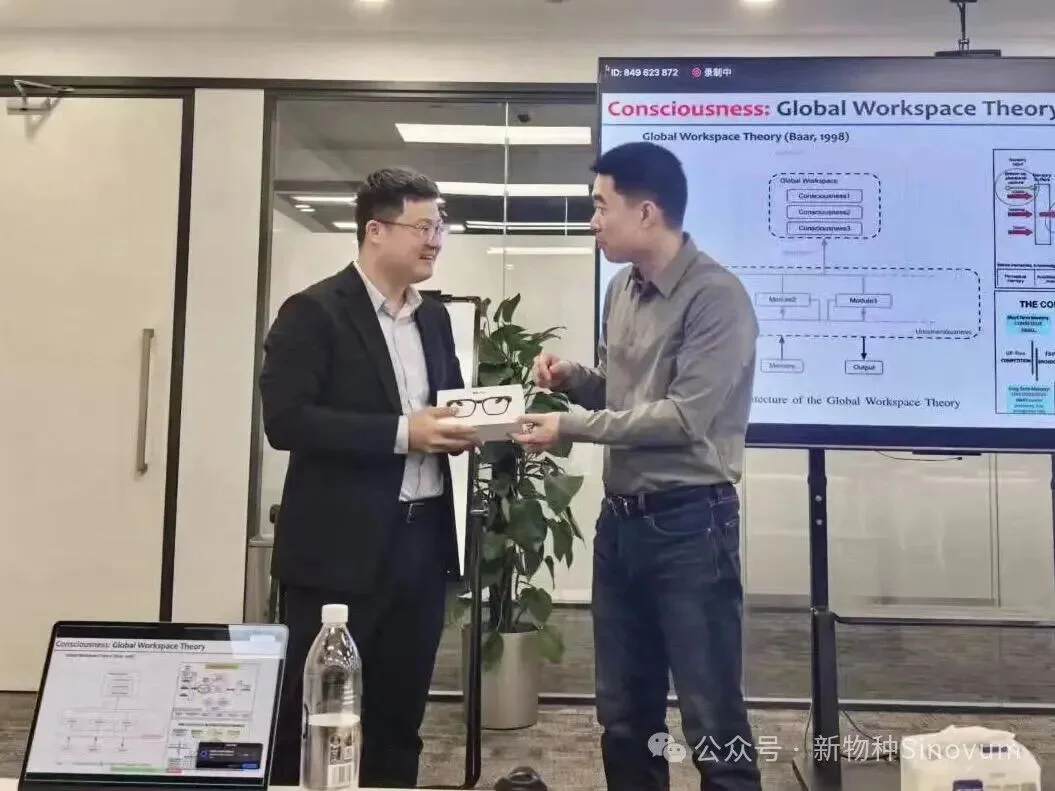 邓程收到第一台交付的Livis
对邓程而言,这场交流很像是一个转折点。交流中他感受到了李想的产品思维、理想汽车的AI布局,也让他思考当今科研的目的是什么。
过去几年,他在上海交通大学读博,后来又到了爱丁堡大学做Research Fellow,一直在从事大模型预训练、高效模型架构设计以及硬件感知协同设计的相关研究。
分享结束,邓程第一次认真问自己:如果技术和时机都已成熟,是不是可以把“天赋”带到产业中呢?
不久后,邓程和他的本科学长安鑫一起成立了班布(Banbu AI)。目前班布已获得超千万元天使轮融资。
他们想做的,不是一台替人炒菜、叠衣服的“万能机器人”,而是一个进入家庭之后,能够理解家庭环境、整理家庭信息、有分寸地陪伴和协助家庭成员的Digital Agent,当然,需要在一个Physical Body里面。
这个Agent最终可以进入不同的物理载体:移动终端、机器人、音箱,甚至未来家庭里的其他设备。在他的设想里,本体只是载体,班布真正想做的是一个家庭管家Agent,以及放在它背后高效运行的AgentOS。
看起来,这像是一次从“大模型”到“家庭AI”的巨大转向。但如果把邓程过去几年的研究放在一起,会发现这条路其实没有那么突然,他关注的一直是:AI究竟怎样感知真实世界,又怎样用更低的成本把事情做成。
01.
从更大的模型,走向更高效的AI
邓程接触硬件系统,其实要早于大语言模型。
本科就读湖南大学时,他有一门必修课叫数字电路,要自己焊板子、调示波器、写FPGA程序,再把代码烧录到硬件里。课程里有一道难度很高的附加题,邓程熬了几个通宵做了出来,全年级最终只有少数几个人完成。而这个项目让他深知嵌入式开发决定了软件系统结合物理世界的效率。
2019年,他保研至上海交通大学Acemap实验室,师从王新兵教授。读博期间,他经历了BERT和T5的出现、生成式语言模型的井喷,在这个过程中,他接触到了高质量的语料和大规模计算资源。
起初,他跟着张伟楠教授和王新兵教授做学术知识图谱。最开始是经典的数据挖掘工作,从论文中抽取关键词,把知识连接起来,再通过一篇论文找到相关论文。但传统方法的效率太低、数据标注代价太高,所以他通过引入Learning to Rank提出了人在回路(Human-In-the-Loop)的实体关系抽取框架,大大提高了地学知识发现和关系预测的效率。
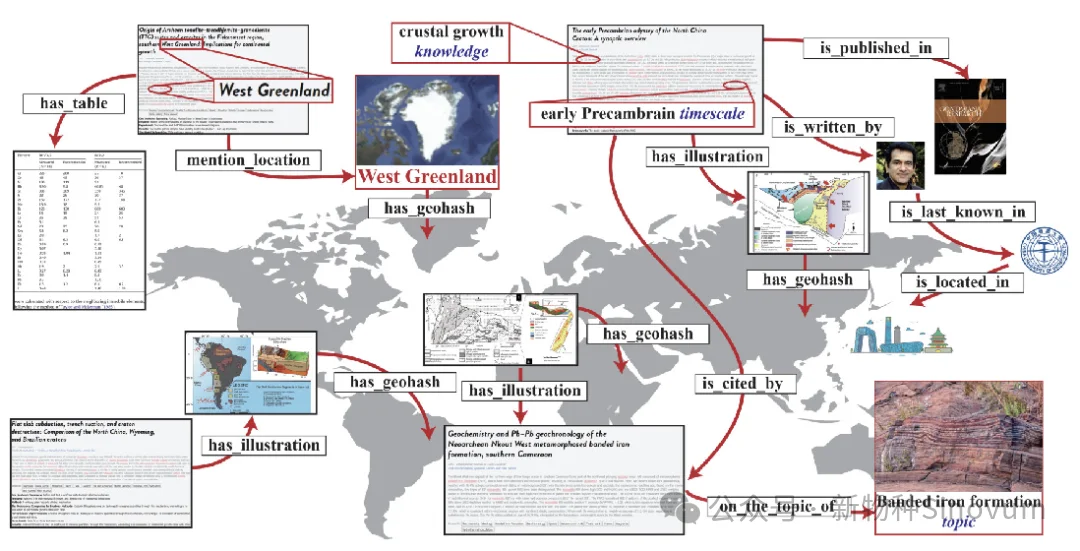
GAKG架构图
2022年初,OpenAI的InstructGPT刚刚出现,邓程判断比起做传统意义上的数据挖掘模型,或许大语言模型的scaling更能代表下个技术拐点,于是转向探索预训练。
也是在这一阶段,他在老师们的支持下,开始探索大语言模型的预训练。
同年10月,就在ChatGPT发布前约30天,邓程参与到了一个地学大数据项目。这个项目希望把全世界的地学文献共享起来,通过模型理解地学知识和地球演化。在林洲汉教授和何俊贤教授的指导下,推出了地球科学领域首个大语言模型“K2”,填补了通用大模型在地学垂直领域落地的空白。
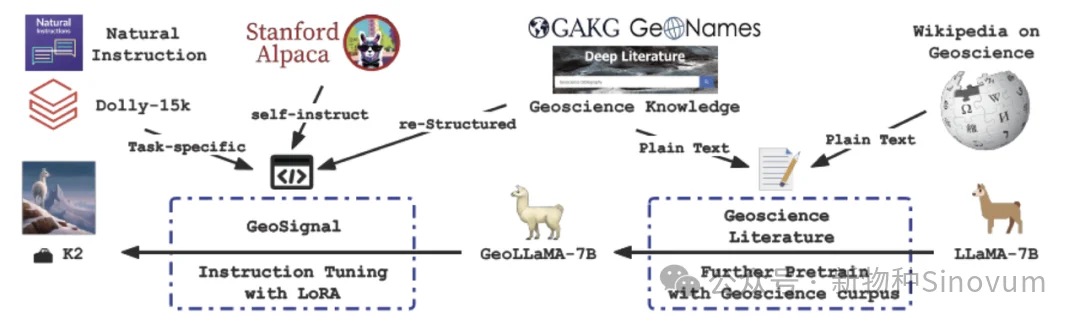
K2模型的训练过程
自此,邓程开始做垂类大模型:先是地球科学大模型“K2”,再是30B参数规模的地球科学学术大模型GeoGalactica,2024年又和设计学院合作做了设计学语言模型。从数据构造到训练效率,再到大规模算力上的训练,从几百张N卡到几千张国产信创的加速器,他一路训到博士毕业。
这段经历逐渐塑造了邓程的一种技术惯性:他关心的从来不只是“模型有多强”,更在意模型获得能力的成本是多少。
这在他后面的工作“DS Agent”里表现得尤其明显。
博后阶段,他前往英国加入汪军教授团队也是在这一阶段,他开始把研究视线从单纯的模型预训练,进一步延伸到Agent、端侧计算,以一个更加全面的视野探索模型如何更高效地完成任务。
做预训练出身的邓程,很早就注意到一个问题:模型每获得一点新知识,往往意味着重新训练。但很多时候,需要增加的知识其实已经存在于模型之外。与其重新训练模型,不如让模型学会调用已有的知识。
在汪军教授的引导下,“DS Agent”采用的正是这套思路:把已有的数据科学案例和代码整理成案例库,让模型在执行任务时进行检索和调用,而不是每次都从零生成。
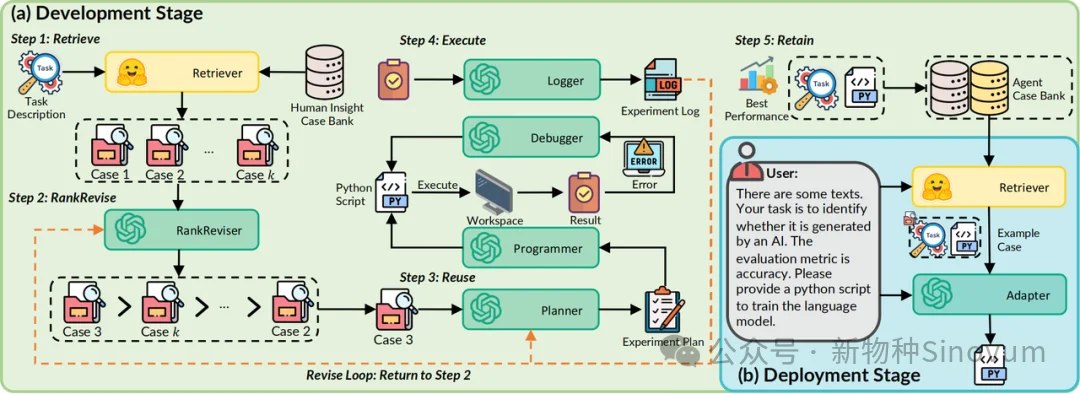
DS Agent图解
今天看来,这套逻辑很容易让人联想到Skill、Memory等机制,模型不必把所有东西都写进参数,也可以通过外部知识获得新的能力。但在2024年,这首先还是一个非常具体的工程问题:减少模型在重复劳动上的Token消耗。
在GPT-3.5时代,如果直接调用GPT-3.5完成一段代码,一次任务大约需要0.06美元,通过“DS Agent”的方法,在部署阶段成本降到了0.0045美元,下降约92%;到了GPT-4时期,单次任务成本约1.6美元,用“DS Agent”方法,在部署阶段则可以降到0.1美元。
随着Agent逐渐成为主流技术形态,这个问题被进一步放大。
传统大模型回答一次问题,通常只需要生成一次结果;Agent为了完成一个任务,却可能不断搜索、调用工具、执行代码、检查结果,再重新规划下一步。循环次数越多,Token消耗就越快增长。这个也正是最近Physical Agent Harness遇到的问题,尽管模型调用硬件接口可以带来更好的效果,但是使用的Token和模型推理带来的延迟,也随之陡增。
于是,从训练效率到Agent效率,最后落到Token效率,这条线逐渐清晰起来。“一个Token到底值多少钱”变成了一个更大的问题。
“一块昂贵的芯片,如果始终没有被充分利用,它的价格就不能直接等同于实际产生的计算价值;同样的模型,在不同的部署软件和硬件环境下运行,实际效率也可能完全不同。这是一笔要算好的账。”他向「新物种Sinovum」解释。
而当这些模型开始从云端走向真实设备,另一个问题就出现了:如果AI要真正进入现实世界,它能不能不用一直依赖云端呢?
这个问题,也把邓程从模型研究带向了端侧。
02.
AI走向物理世界,模型之外还需要什么?
2024年,邓程已经开始意识到,模型效率的问题,迟早会从云端走向真实世界。但真正让他把这个问题想清楚的,是和理想汽车长达一年的合作。
2025年5月,邓程回国参加一个交流,落地当天,收到理想汽车语言基座和MindVLA基座负责人的邮件,对方关注到了他的工作“PLM: Efficient Peripheral Language Models Hardware-Co-Designed for Ubiquitous Computing”,想邀请他给理想内部做一次线上分享。
邓程主导开发的PLM通过软硬件协同设计,在模型架构和边缘系统约束之间联合优化,采用稀疏激活和多头潜在注意力机制,以最少的激活参数超越同类模型,并成功部署于手机、树莓派等设备。同时这也是一个从头预训练的模型,包括数据准备、模型架构搜索、训练和评测。
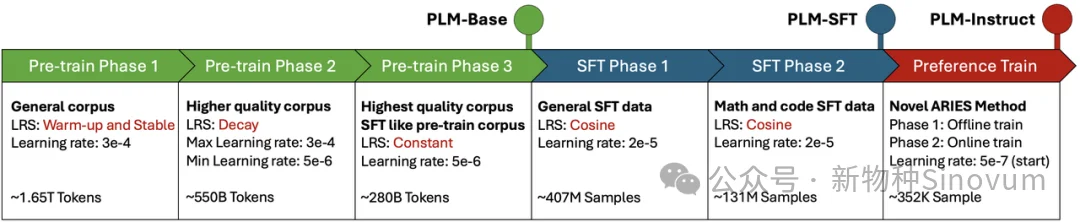
PLM训练管线
对于正在推进自研芯片马赫M100和AI模型研发的理想汽车而言,模型效率同样是一个重要课题:如何从底层架构出发,让模型设计充分考虑芯片的计算能力和资源约束,实现模型与芯片的协同优化?
在汪军教授和通用决策智能研究所的支持下,邓程以特约研究员身份参与了与理想汽车的合作研究,合作围绕三个方向展开:如何设计出最大化利用端侧计算资源的语言模型架构;如何找到视觉-语言-动作模型(VLA)最高效的架构;如何在有限的数据资源下,让具身模型具备更好的长程能力和泛化能力。
过去,车企或硬件厂商设计语言模型,通常需要大量算法工程师反复试错:先拍一个架构,再调超参数,然后用MuP(最大更新参数化)等方法做规模扩展,从0.3B、0.7B、1.5B一路训练到3B、7B、13B。究竟多少层合适、什么结构更适合,都需要靠一次次训练验证。
邓程自己也经历过这个过程。此前训练“PLM”时,从立项到沙箱实验,再到最终完成,前后花了大半年,因此他希望把这种反复试错变成一套可以提前计算的方法。
于是,他们做了“Hardware-Co-Design Scaling Law(硬件协同设计缩放定律)”。
简单来说,给定一个芯片和一个延迟要求,就能直接预测什么样的模型架构最适合,而非先把模型全部训练出来再看结果。他们用多项式拟合语言模型的损失缩放定律。语言模型的损失遵循缩放定律,因此可以通过拟合,预测不同规模下最终训练出来的损失。
另一边,邓程把自己在系统领域学到的知识“Roofline Model(屋顶线模型)”也联系起来。屋顶线模型描述的是硬件真正能跑多快:瓶颈究竟是输入输出(IO)、存储还是计算单元。但芯片标称的屋顶线不等于真实运行状态,电压、温度、功耗都会影响实际性能。
他们进一步推导了Transformer端到端推理延迟的完整数学表达,并针对车载场景做了关键扩展:首次系统建模了KV缓存、MoE路由、注意力机制等大模型特有负载对车载SoC内存子系统的影响。这个延迟模型效率极高,20分钟内就可以评估5万多种架构配置。两者结合做多目标优化,寻找模型能力、硬件性能和延迟之间的帕累托最优解。
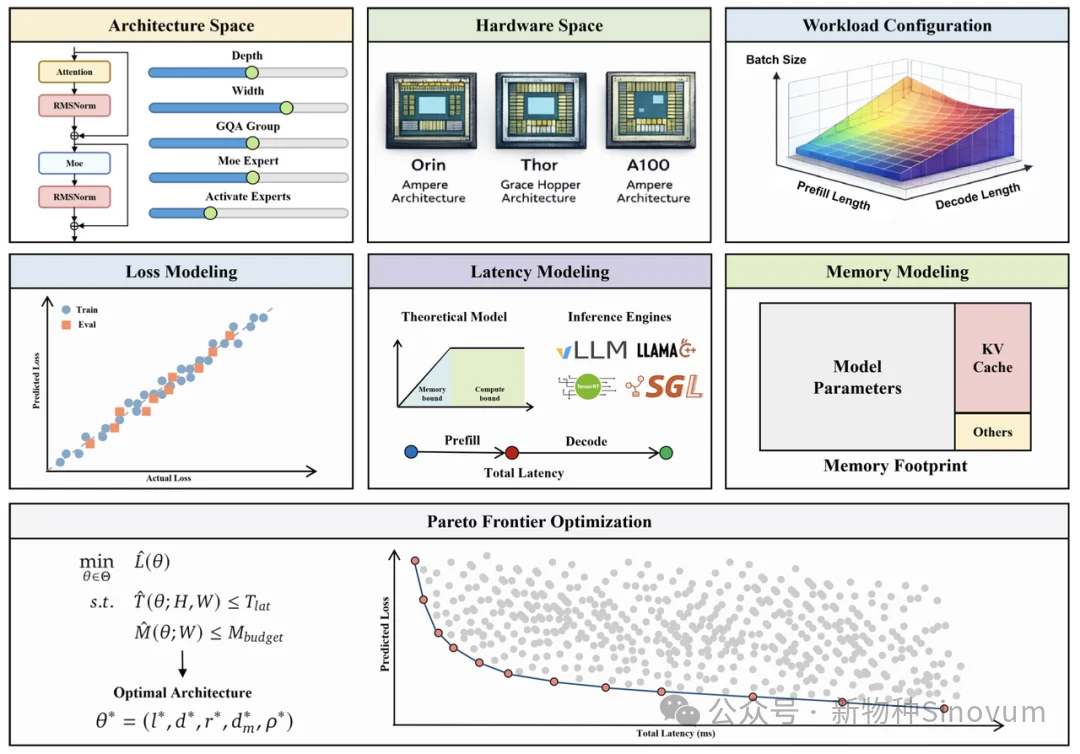
PLAS概览
为了验证这套框架,团队训了170个不同架构的Transformer模型,最终结果在Jetson Orin上,协同设计架构比Qwen2.5-0.5B困惑度降低了19.42%,架构选型周期从几个月缩到一周。
这意味着,过去“先定模型、再找硬件”的路径被颠倒:先给定硬件和需求,再决定模型应该长什么样。邓程给这个工作起了个很有意思的名字:“Dancing in Fetters(戴着镣铐跳舞)”。
在随后的大半年的合作过程中,理想汽车与合作研究团队交付了5篇学术论文,其中两篇已经被NeurIPS和CoRL录用。
到2025年11月底,这项工作基本成型。邓程开始认真考虑创业,也恰好是在这段时间。
他和本科同学安鑫聊过往后的打算。他意识到,自己积累的训练效率、Token效率和部署经验,或许不只是论文里的研究问题,也可以成为一家公司真正的技术底座。但他还缺一些答案:这些技术应该落在什么场景上?物理AI有没有可能在端侧实现?有什么办法才能让AI服务于人?
家庭恰恰是这两个问题的交汇点:人们的隐私和每天都会回的家。于是,他们把目光投向了家庭。
03.
不想造「什么都会」的家庭机器人
邓程决定创业,深受他的本科学长安鑫的影响。
大学时,管理学院的安鑫参加创业大赛,找班主任推荐技术拍档,班主任给他推荐了信息院的邓程,经过磨合,他们通过运动社交拿了全国三等奖。二人的默契自此建立。
安鑫在华为、阿里从事过消费电子行业相关的市场营销、用户增长、产品经理岗位,后来又自己做过toB的agent开发公司。当他2025年底再次找到邓程,后者的条件很简单:要做就做硬科技,能真正服务于寻常百姓的东西。
他们有一个很朴素的原则:公司做的东西必须是自己会买的。“半夜起床,朦胧之中,看见一个人形的铁疙瘩站在那亮着充电的绿光,想想都可怕”,邓程直言道。他觉得很多家庭机器人创业者追求的“终局”,一个无所不能的万能工人,实际上并不匹配真实需求。
真实家庭更需要管家,一个唐顿庄园里面的Mr. Carson。管家和工人之间的区别在于,管家知道什么事情该自己处理、什么事情该留给主人。
邓程自己最常遇到的困扰,是飞书、腾讯会议、Google Calendar、Outlook之间来回切换,却没有人能把所有日程统一整理好。他写过一个脚本,把不同平台的日程截图扔进一个文件夹自动处理,然后通过一个简单的页面告诉他每天要做的事情是什么。家庭AI需要的正是这个层面的能力:帮人把事情安排好,而不是替人做所有事。
他把班布称为“家庭飞书”。今天谁回来早谁做饭,谁接孩子谁照顾老人,家庭里多数冲突并不来自不爱彼此,而是事情没安排好。AI可以管理事务,但管理关系的部分必须留给人。
但一个只存在于手机里的Agent也有明显边界:它能读日历、做提醒,却不知道钥匙落在哪个房间,也看不到老人迟迟没有走出卧室究竟发生了什么。
因此,班布想做的并不是单一模型,而是一套把多模态感知、AI Agent和Robotics连起来的系统。
传感器负责感知,AI Agent负责思考和规划,Robotics负责把计划变成真实行动。三者之间不断交互:机器先观察环境,再决定下一步行动,获得新的信息之后重新判断,而不是收到一句指令之后机械执行到底。
邓程向「新物种Sinovum」展示过一个demo:通过语音让系统“找一瓶雪碧”。它不需要提前拿到一张完整的区域地图,就开始了开放域搜索。进入一个房间之后,它先观察有没有目标;没有,就重新判断该往哪里走,再进入下一个空间搜索。每获得一次新的视觉信息,Agent都会重新规划下一步。
“这不是一个模型在干,是一套系统在干。未来肯定一群人会涌入这个方法的赛道,但是班布关注的是里面的各种系统软件的co-design和人与机器的交互。”邓程说。
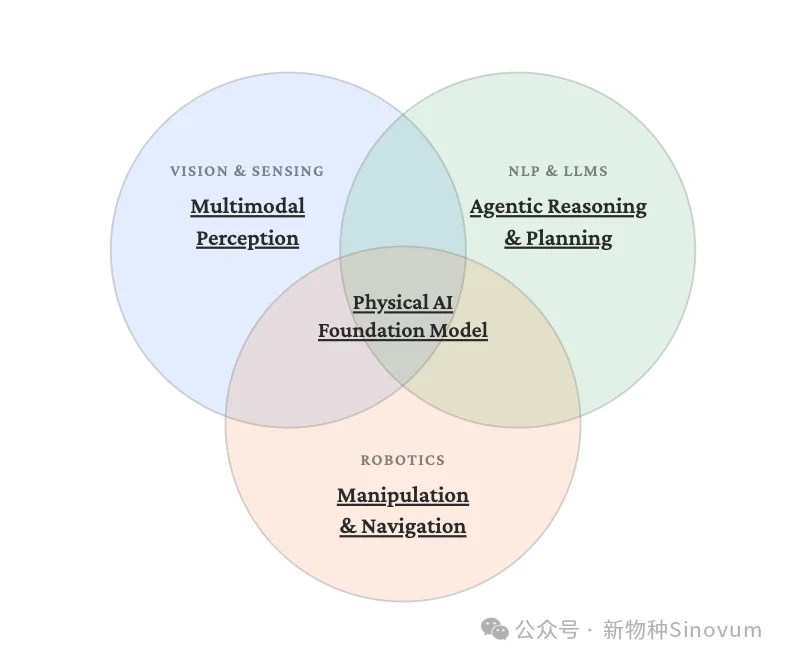
邓程描述班布处于的交集位置
邓程喜欢用Windows解释班布想扮演的位置。
Windows并不要求电脑必须由微软自己生产,它可以运行在不同厂商的硬件上;与此同时,微软后来又做了Surface,用自己的硬件验证Windows完整的使用体验。
班布的想法有些类似。他们做的Physical Agent系统并不绑定某一种本体,可以进入班布自己的移动设备,也可以进入第三方机器人、机器狗甚至其他家庭终端。目前,班布其实已经用自己的“Surface”,通过一台小车,跑通Physical Agent的全流程:感知、规划、调用记忆、移动和交互。
这个想法也来自那场在理想汽车的汇报。汇报结束时,邓程收到了第一台Livis,他戴上后试了同声传译,反应快得几乎感觉不到延迟。那个“快”让他意识到,AI进入物理世界之后,与硬件的交互本身就是产品的一部分。
跨本体的技术判断也源于对于“家庭管家”的定位。
“千万别代替我做饭,因为我喜欢做饭,做饭就像科研,你永远可以期待普通的食材能做出好多好吃的。” 邓程说,“或许他就帮我整理下家庭日程信息,给我在不同城市的爸妈一个随时了解我的媒介,以及永远记得我在乎的人和事,在该出现的时候出现就好了。”
“今晚吃什么”不应该由AI决定,因为这种选择本身就是生活的一部分。AI可以提醒你“酱油快没了”,也可以帮你下单采购,但再往前一步,人与人之间那点属于生活的东西,就可能消失了。
邓程曾用一个比喻描述自己的想象:手机是“街机”,班布想做的是“家机”,即一个知道什么时候该出现,也知道什么时候该沉默的AI。那些真正属于人的决定,不要碰。
在他们共同的想象里,硬件最终长成什么样,是由用户需求和Agent定义的。总有一天,“家庭管家”会自己采购食材、清洗备菜、打扫厨房,而把晚餐的选择和做菜的乐趣留给人类。AI进入家庭,承担琐碎的信息处理和家务执行,让人类回归到家庭生活和家庭关系本身。
“这大概就是Physical AI进入真实世界最需要做的事。我们的技术面向智能空间,首先聚焦家庭,也可以延伸到养老院、社区、实验室和工厂。这些空间的共同需求,是让AI理解人的意图和空间环境,并在此基础上完成交互、推理和执行。”邓程解释。
*文中图片由受访者提供
文章来自于"新物种Sinovum",作者 "Oriana"。
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md