数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?
在多教师在线策略蒸馏(MOPD)中,按领域选择教师只是第一步。不同教师的领域专长、回答风格和推理习惯可能相差很大,但它们的监督最终作用于学生的同一套共享参数。各自有效的指导在联合训练中可能相互干扰,导致一科进步、另一科退步。
这一挑战在真实业务中同样存在。商品理解、素材质检、风控合规等任务的能力合版,也需要协调不同业务专家的指导,让统一模型在吸收业务专长的同时保持通用多模态能力。
针对这一挑战,京东零售 - 视觉多模态与 AIGC 团队联合南京大学提出 Road MOPD,让多位教师共同评价学生的同一份回答,并通过跨教师反馈协调学习过程。具体而言,Road MOPD 增强教师共同支持的学习信号、减弱存在分歧的信号,再在参数更新前削减冲突分量,在减少学习干扰的同时保留目标任务的学习力度。
- 论文链接:https://arxiv.org/abs/2610.13521
- GitHub 地址:https://github.com/jokersio-tsy/RoadMOPD
- huggingface地址:https://huggingface.co/papers/2610.13521
实验表明,在 Qwen3-4B 上,相较 Vanilla MOPD,Road MOPD 在数学+医学、代码+医学两组高冲突设置中均实现双域共同提升,医学均分最高提高 8.78 个百分点。收益也延伸到冲突较低的数学+代码组合,两个领域分别提高 1.61 和 1.83 个百分点。
老师差异大 按领域各教各的还不够
在线策略蒸馏(OPD)让学生先生成回答,教师再沿着实际生成的内容逐 token 提供反馈。传统多教师 OPD 按领域独立监督,其他教师不参与对当前回答的联合评议。
已有研究在数学、代码等领域组合上展示了联合学习的潜力。但这样的收益,能否延伸到其他领域组合?图 1 将常规多教师训练(Vanilla MOPD)与对应的单领域 OPD 作了对照。
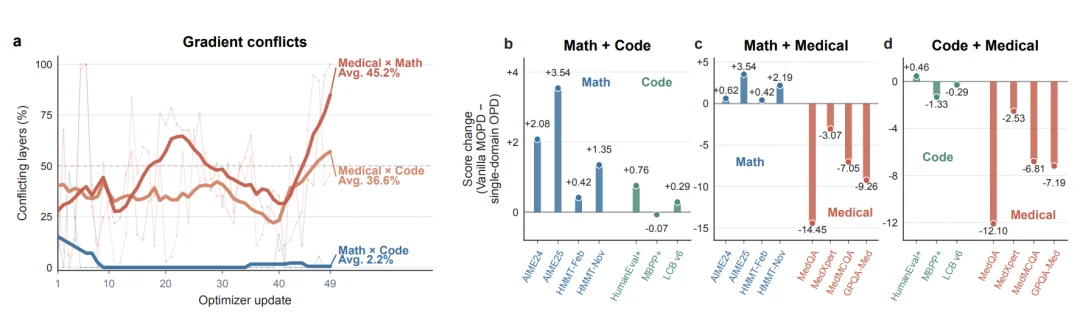
图 1|领域间的梯度冲突,以及常规多教师训练相对单领域训练的成绩变化。
先看数学+代码:图 1 左侧的梯度冲突层占比均值仅为 2.2%,右侧各项基准成绩也大多保持或提升。右侧以单领域 OPD 为零线,高于零表示联合训练带来收益,低于零则表示退步。
然而,换成数学+医学、代码+医学,情况发生了变化:冲突层占比均值分别升至 45.2% 和 36.6%,训练后期更为突出;同时,两组组合中的四项医学基准全部低于单领域 OPD。数学与代码上的联合学习收益,并没有自然延伸到这些组合。
这组反差暴露了传统 MOPD 在教师差异较大时的合版难题:领域路由分开了监督来源,却没有协调它们对共享参数的影响。因此,数学与代码上的收益不能直接推及其他组合,还需要针对联合训练中的更新冲突,减少某个领域的能力退化。
Road MOPD 据此引入跨教师协同守护:保留领域专家的主要监督职责,同时请其他老师评价同一段回答,用跨教师反馈减弱分歧信号、约束冲突更新,减少能力整合中的相互干扰。
让其他老师也看同一份回答
Road MOPD 保留领域专家的主要监督职责,同时请辅助教师评价相同的学生回答、相同的上下文。例如,数学教师指导解题时,医学教师提供额外反馈,帮助判断这次修正是否兼容其他教师的偏好。
辅助教师扮演跨领域评议者。它提供的是兼容性线索,数学答案的专业监督仍由数学教师负责。方法还引入学生初始化时的冻结副本,作为所有教师表达修正方向的共同参考。
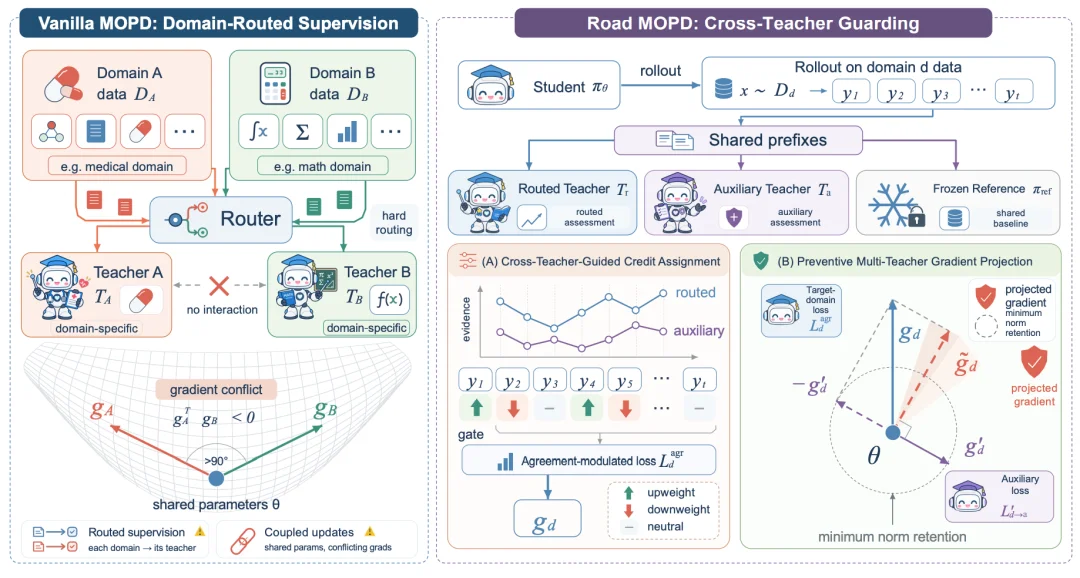
图 2|Road MOPD 总览:先调整 token 级监督,再协调共享参数的更新方向。
第一步 把教师共识落实到每个 token
一段回答里,有些修正得到两位教师共同支持,有些却存在分歧。Road MOPD 据此调节主教师的相对奖励:共识强的位置适当增强,意见相反的位置适当减弱。
具体而言,方法比较两位教师相对冻结参考模型的 token 概率。如果都倾向提高,或都倾向降低某个 token 的概率,修正方向就一致;一位提高、另一位降低,则存在分歧。一致性信号经平滑、限幅后变成调节系数,避免监督强度变化过大。证据接近零时,方法回到接近标准 OPD 的监督。
这让教师绝对概率不同、但修正方向相同的情况也能被识别。调节作用于主教师的相对奖励信号,并非把整项损失简单乘上一个权重。
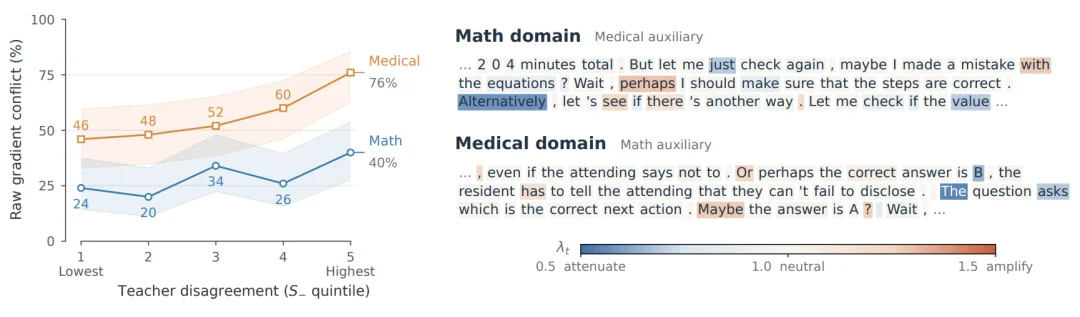
图 3|教师分歧与原始梯度冲突的关联,以及真实回答片段上的监督调节。蓝色为减弱,橙色为增强,颜色不表示答案对错。
这种分歧有实验依据。固定学生模型后,研究者将样本批次按教师分歧从低到高分成五组,医学领域的梯度冲突率从 46% 升至 76%。这说明,文本层面的意见差异能够提供更新冲突的线索。
第二步 减少冲突,也保留学习力度
逐 token 协调之后,监督仍要汇聚成参数更新。Road MOPD 进一步引入预防性梯度投影:用调整后的监督计算目标梯度,用辅助教师对同一份回答的标准 OPD 监督计算辅助梯度。
随后,方法按参数张量检查两个梯度的内积。方向兼容就保留目标梯度;出现冲突时,移除其中一部分不兼容分量。辅助梯度只提供约束方向,不会作为另一项独立更新直接加到学生身上。
关键在于 “同一份回答”。常见的 PCGrad 协调不同任务各自在自身数据上形成的梯度;Road MOPD 检查其他教师对当前回答的反馈,提前约束当前更新。两者观察的是不同的兼容性关系。
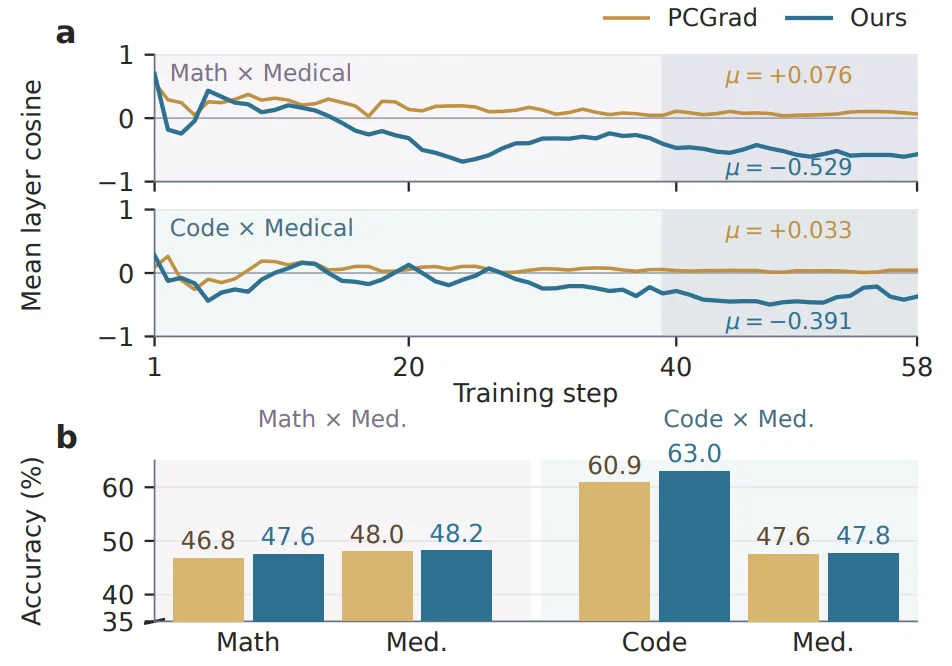
图 4|同轨迹投影与 PCGrad 的控制比较。上方为不同梯度配对方式的余弦均值;下方为领域均分,纵轴带断轴标记。两者保留相同的信用分配和范数保留机制。
投影也不能一味求强。当两种方向几乎相反,完全投影可能把当前领域的学习信号一起削弱。因此,方法设置目标梯度的范数保留下限,在这一约束内自适应选择投影强度。消融中,改为完全投影后,两组高冲突设置的综合分分别下降 0.83 和 0.44 分。
如果辅助教师不止一位,方法先汇总教师一致性,再在同一个范数保留下限内依次投影,让更多专家参与协调。
高冲突组合先受益 再扩展到更多组合
实验采用 Qwen3-4B 和 Qwen3-1.7B,均关闭 thinking 模式,覆盖数学、代码、医学的 11 项基准,并与 Vanilla MOPD、ExOPD、Open-MOPD、CaMOPD 等方法比较。
先看 4B 学生。在数学+医学联合训练中,相较 Vanilla MOPD,数学均分从 45.97 升至 47.60,提高 1.63 个百分点;医学从 39.45 升至 48.23,提高 8.78 个百分点。两域综合分从 42.71 升至 47.92。
代码+医学组合也实现共同提升:代码均分从 60.53 升至 63.02,提高 2.49 个百分点;医学从 40.75 升至 47.75,提高 7.00 个百分点。两域综合分从 50.64 升至 55.38。这两组设置中,Road MOPD 的两个领域均分均领先所比较的多领域方法。
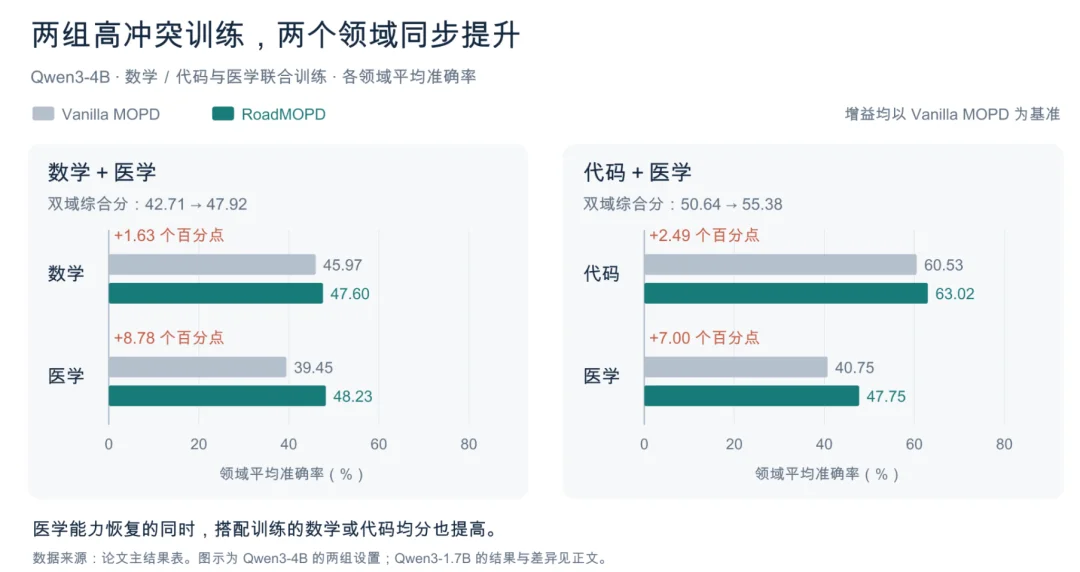
图 5|4B 学生在两组高冲突训练中实现双域共同提升。标注为相对 Vanilla MOPD 的绝对百分点增益,横轴从零开始。数据来自论文主结果表。
规模缩至 1.7B 后,代码+医学组合仍共同受益,较 Vanilla MOPD 分别提高 2.15 和 5.58 个百分点。数学+医学则存在取舍:数学均分从 28.36 降至 27.21,医学从 31.18 升至 36.89,综合分从 29.77 升至 32.05。
两种学生规模、两组高冲突组合共四组实验中,Road MOPD 均取得最高双域综合分,领先各组最强综合基线 0.72—2.89 分。1.7B 学生的数学、代码均分仍略低于 ExOPD,但按领域等权衡量时,整体表现更好。
缓解高冲突组合中的退化之后,研究者进一步检验了较为兼容的组合。4B 学生联合学习数学+代码时,两域均分较 Vanilla MOPD 分别提高 1.61 和 1.83 个百分点,综合分达到 55.40,说明收益也能延伸到低冲突场景。
扩展到数学、代码、医学三领域后,4B 学生的三个领域均分较 Vanilla MOPD 分别提高 0.31、1.68、7.42 个百分点,均领先所比较的多领域方法。综合分达到 52.89,比 Vanilla MOPD 提高 3.13 分,比次优的 CaMOPD 提高 1.18 分。
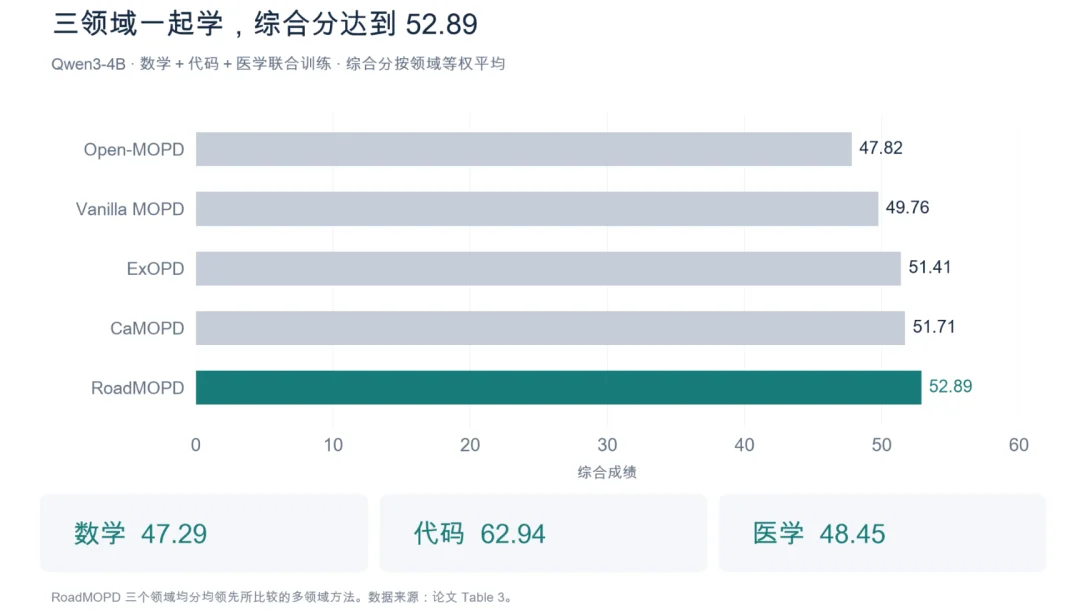
图 6|三领域联合训练结果。综合分为三个领域均分的等权平均,底部为 Road MOPD 的各领域成绩。数据来自论文三领域结果表。
评测说明:领域内先对基准取平均,综合分再按领域等权平均。医学结果来自文本问答基准,详细评测口径见论文。
缓解合版冲突 让不同专家的能力更好整合
Road MOPD 聚焦风格与领域差异较大的教师合版冲突:各自有效的指导,在共同训练一个学生时,也可能因更新同一套参数而相互干扰。方法保留领域专家的主要监督职责,同时让其他教师评价学生的同一份回答,用教师共识增强共同支持的修正、减弱分歧信号,再在参数更新前削减冲突分量,并保留当前任务的学习力度。跨教师协调由此贯穿监督与更新两个环节,帮助学生在吸收一位专家能力时减少对其他领域的干扰。
在 Qwen3-4B 上,相较 Vanilla MOPD,两组高冲突组合均实现双域共同提升,医学均分最高提高 8.78 个百分点。进一步实验表明,收益也能延伸到较为兼容的数学+代码组合;扩展到数学、代码、医学三领域后,三个领域均分同样提升,综合分达到 52.89。
这些结果表明,跨教师反馈为缓解 “学会一科、退步一科” 提供了有效路径,也为将不同专家的能力整合进同一个学生模型提供了方法支撑。
作者团队
本研究由南京大学 LAMDA 实验室与京东零售视觉多模态与 AIGC 团队联合完成,Shi-Yu Tian 与 Yong Liu 为共同第一作者。
南京大学 LAMDA 实验室由中国科学院院士周志华领导,依托计算机软件新技术全国重点实验室,长期深耕机器学习与数据挖掘领域,围绕集成学习、半监督学习、多示例与多标记学习等方向,持续开展基础理论、算法方法与应用研究。
京东零售视觉多模态与 AIGC 团队立足零售业务的一线需求,聚焦多模态商品理解、可控视觉生成与虚拟试穿,研发了电商多模态理解模型 OxygenVLM、面向多品类虚拟试穿的 Oxygen-TryOn 等模型,致力于把技术做扎实,让技术用得上,让好商品更出彩,让用户挑选更轻松。
文章来自于"机器之心",作者 "Shi-Yu Tian与Yong Liu"。