超智能这场竞赛的胜负手不在后训练,而在谁先跑通 RSI 预训练。
负责人表示:预训练和后训练不是一个量级的事:算力、经验、工程,每一样都高出一个数量级。但很不幸,它也是最重要的事,是我们对智能进行加工的第一性基础。正因如此,RSI 必须落到预训练上,智能制造才开始复利:没跑通的一方只能眼看着代差一代代拉大。
一间教室,和一家 40 亿美元的公司
过去一年,「RSI」(Recursive Self-Improvement,递归自我改进)几乎成了大模型圈最热的词:让 AI 自己提出改进、自己执行、自己评估,再在结果之上继续改进,循环往复,越改越强。但如果追问一句:有谁把 RSI 用到了从零开始的前沿预训练上,并且公开了出来?据我们所知,答案只有两个。
- 一个在美国。Recursive 是一家明星创业公司,创始团队来自 Google、Meta 和 OpenAI,《纽约时报》称其为一项「40 亿美元级」的项目。两周前,他们发布了从零训练的模型 Flint。
- 另一个在上海的一间教室里。门牌号是 801,也是这个模型的名字。
我们是唯一公开全部技术细节的一家。
今天,上海创智学院与新序智能联合发布首份完整公开的预训练级 RSI 技术报告、base 模型(801-30B)、高质量 SFT 数据。
不只是一次试水:用时不到三个月,这间教室交出的模型,站进了同尺寸开源基座的第一梯队。
- 技术报告:https://github.com/GAIR-NLP/801-30B/blob/main/report.pdf
- 模型与数据:https://github.com/GAIR-NLP/801-30B
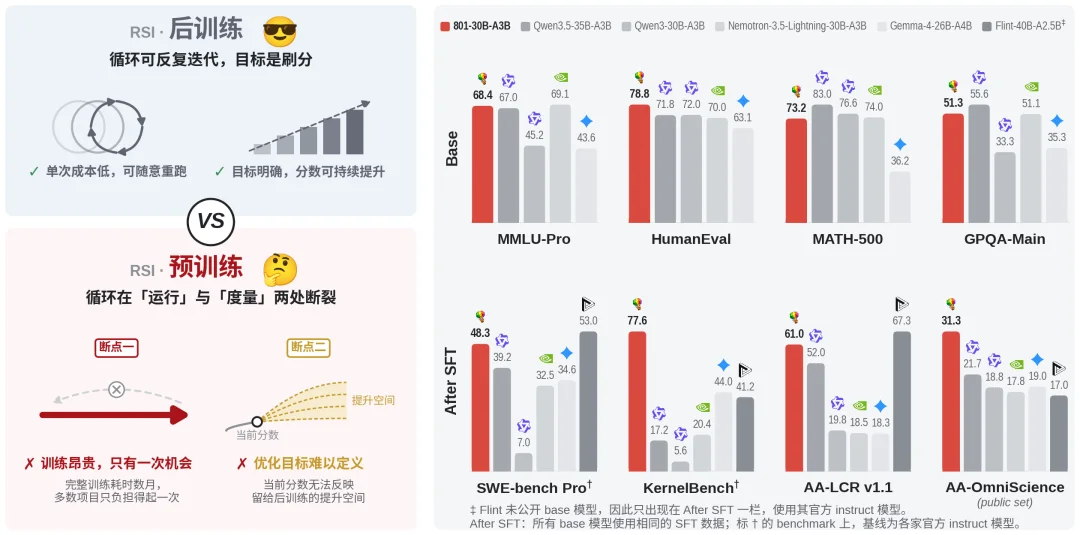
801(红色)与开源模型对比:上排为 base 模型评测,下排为 SFT 后评测(标 † 的评测中,对比模型为厂商发布的完整后训练版本)
为什么要用 RSI 做预训练?
为什么这件事为什么值得做?答案是:RSI 的终点不在后训练,而在预训练。
预训练决定一切能力的上限
一个大模型的知识和推理能力,绝大部分在预训练阶段形成。后训练做的是把这些能力「激发」出来,很难凭空创造出预训练没有给的东西。预训练因此是整条 AI 能力链的源头:之后所有的 agent、应用和产品,都建立在它之上。打个比方:后训练是装修,预训练是盖房子的地基和主体结构。装修再好,也改变不了房子能盖几层。
只有进入预训练,RSI 才真正「递归」
RSI 最根本的想象,是 AI 能够改进制造下一代 AI 的过程,而更强的下一代 AI 又能继续改进再下一代。这个闭环一旦转起来,进步会复利式地加速。但如果 RSI 只停留在后训练,它改进的只是「给一个现成的模型装修」;制造模型最根本的那道工序,仍然完全依赖人。闭环并没有真正闭合。
只有当 RSI 进入预训练,AI 才第一次参与「制造 AI」本身。这是递归自我改进从「装修」走向「造房子」的一步,也是这条路上最关键、最难的一步。
它会改变基座模型的生产方式
今天,训练一个前沿基座是全世界最稀缺的能力之一:需要大规模的顶尖团队、多年积累却从不公开的踩坑经验、几个月的时间和海量算力。全球能做到的机构屈指可数。RSI 进入预训练,意味着这套高度依赖少数人才、靠人力堆出来的工艺,开始变成由 AI 驱动、可积累、可复制的流程。801 本身就是证据:一支新组建的团队,三个月从零训练出第一梯队的基座。
经验第一次可以复利,而不是随人流失
预训练最宝贵的资产,是「哪些路走不通、为什么走不通」。过去,这些经验存在少数人的脑子里,人一走就没了,这也是前沿实验室最深的护城河。我们把每一次尝试、每一次失败和失败的原因都沉淀进一套共享的「记忆」,让下一轮直接站在上一轮的肩膀上。预训练的 know-how,第一次可以复利增长。
对算力受限的一方尤其关键
在只有一次机会的预训练里,每一个 GPU 小时都不能浪费。让每一次训练、每一次失败都转化为可积累的经验,本质上是在提高单位算力的智能产出。对算力受限的一方来说,这不只是一条技术路线,而是一道必答题。
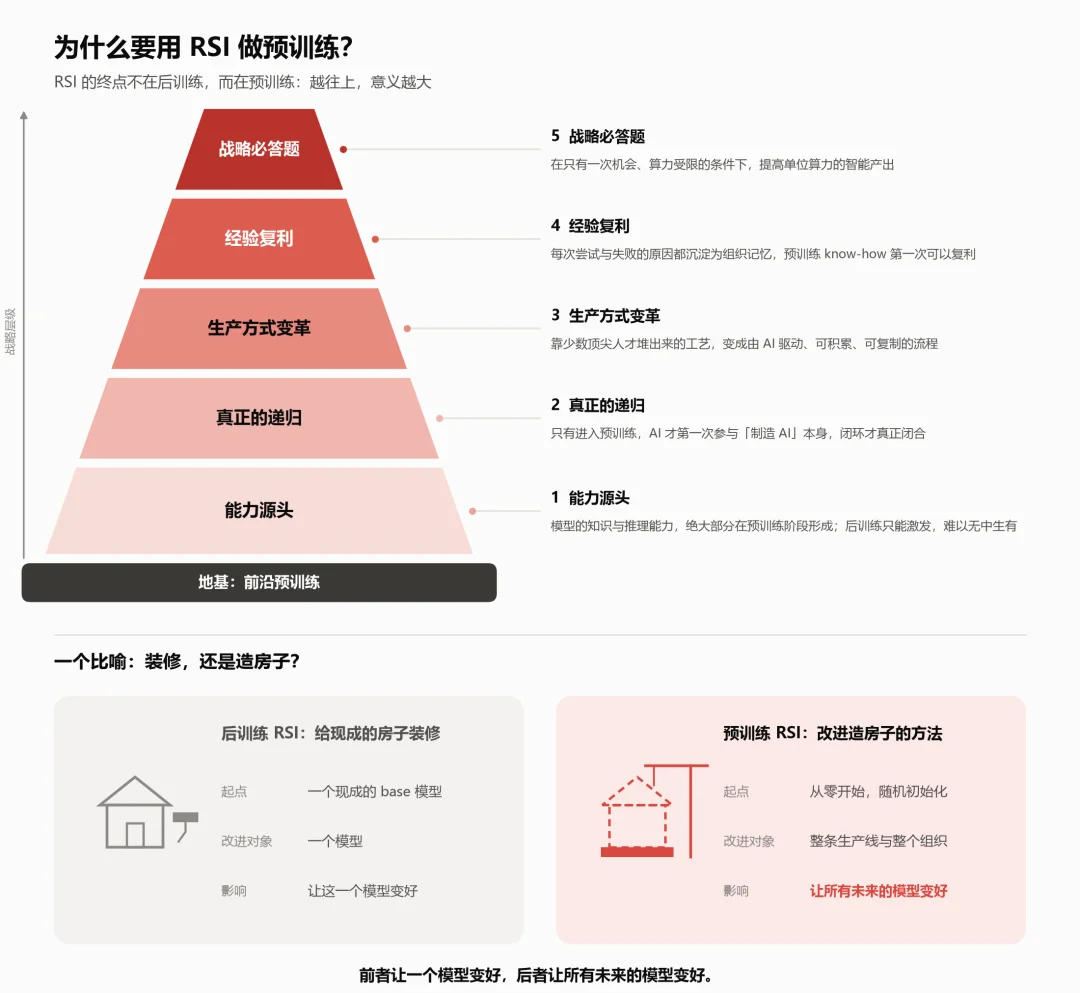
RSI 的终点不在后训练,而在预训练:五层意义自下而上;后训练 RSI 是装修,预训练 RSI 是改进造房子的方法
这么重要的事,为什么全球只有两家公开在做?
RSI 并不缺少尝试。但现有的公开工作,几乎都集中在离「制造模型」较远的环节:优化 agent 框架、编写 GPU 算子、自动化后训练,或者用小模型模拟几分钟到几小时的预训练代理实验。真正从零开始、完整规模的前沿预训练,公开做 RSI 的只有两家:
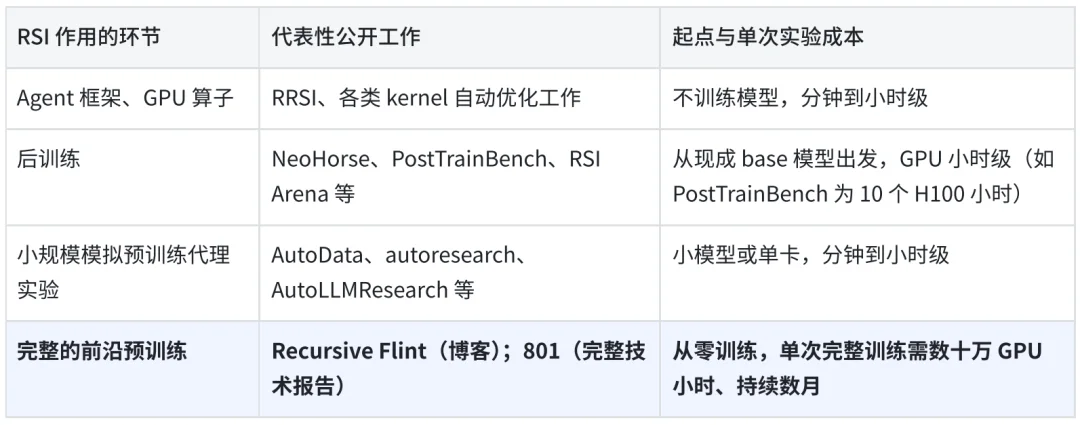
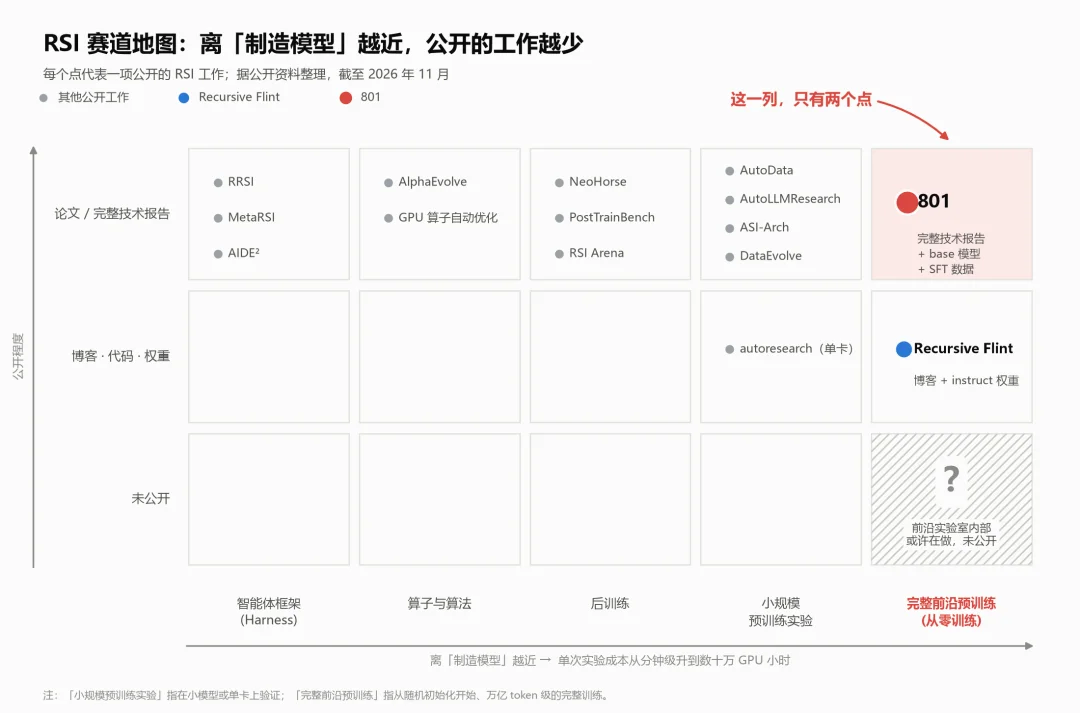
RSI 赛道地图:离「制造模型」越近,公开的工作越少;完整前沿预训练这一列只有两个点
难度,不在一个量级
为什么几乎没人公开做?因为预训练 RSI 不是「更难的后训练 RSI」,而是另一件事。
- 贵:后训练做一轮 RSI 实验,通常只需几个到几十个 GPU 小时;而一次完整的预训练需要数十万 GPU 小时,持续好几个月。两者之间差了四到五个数量级。
- 只有一次机会:后训练可以反复试几十上百次;完整的预训练,几乎所有团队都只跑得起一次。这也是为什么公开技术报告标题为:「No Second Run」。
- 没有标准答案:后训练有明确的分数可以优化;预训练的真正目标,是给后训练留下多少潜力,这没法从任何单一分数上读出来。
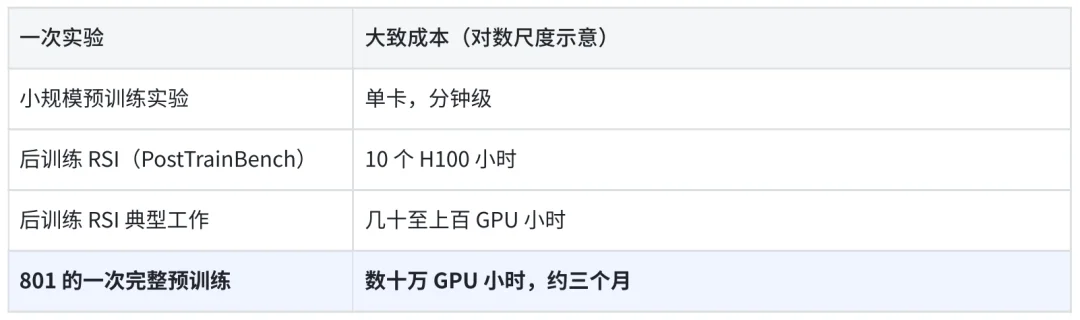
后训练 RSI 像在厨房里试菜:一道不好吃,重新做一道。
预训练 RSI 像芯片流片:一次就是几个月和巨额投入,没有第二次机会。
难的不只是算力,更是整个生产方式
预训练开始之前,数据要先从零造出来:原始网页、文档和代码仓库,经过 6 条数据管线、30 多个加工阶段,最终形成 1,053 个数据子集。训练过程中,训练基础设施迭代了 130 多个版本,超参数涉及 106 个字段。这些证据分散在数据、基础设施、训练和评测四个团队手里,而最难的问题,往往恰好落在团队与团队之间。
所以,预训练 RSI 要改进的不是一个模型,而是整条生产线,和运转这条生产线的整个组织。
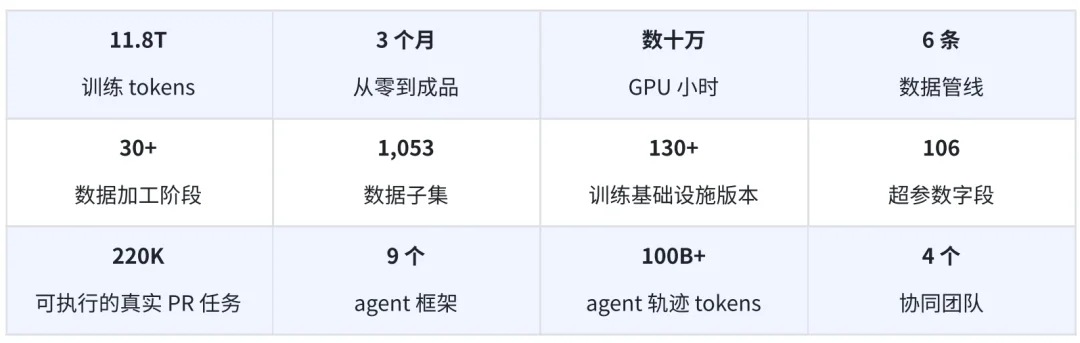
我们怎么做到的:把断开的大循环,拆成能闭合的小循环
经典的 RSI 是一个大循环:提出改进、执行、评估、更新。到了预训练,「执行」要几个月且无法重来,「评估」没有可靠的分数,这个大循环闭合不了。
我们的做法是:不去强行闭合整条大循环,而是把预训练拆成三类可以快速闭合的小循环,再用一套共享的记忆把它们串起来。
- 调试循环:从训练指标和模型输出里的异常信号出发,一路追到基础设施代码、训练配置或某个数据源,修复后再验证。
- 潜力循环:不只看模型今天考多少分,而是用轻量微调等方法测量它还有多少后训练潜力,以此判断训练是否仍在进步、配方是否需要调整。
- 经验量化循环:把数据清洗、网站发现、爬取覆盖这些过去「凭感觉」的决策,变成有明确指标、agent 可以反复迭代的流程。
- 生产记忆:每一次尝试、每一次失败和失败的原因都被记录下来。后来的每一个提议,都从「之前已经排除了什么」出发,而不是从零开始。
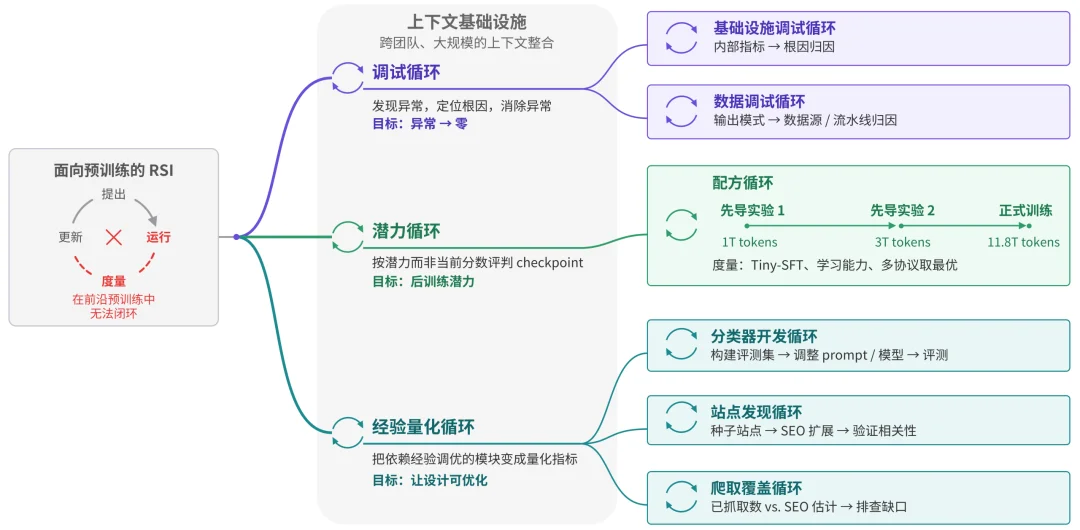
经典 RSI 的大循环在前沿预训练中无法闭合(左);我们将其拆分为三类、六个可闭合的小循环,并共享一套组织记忆(右)
破案一:一个藏在第 15 层的负载均衡问题
在一次试训中,所有汇总指标看起来都很正常,但 agent 在逐层扫描时发现:模型第 15 层和第 18 层的专家负载失衡指标在悄悄飙升,而汇总数据把它完全掩盖了。agent 在 130 多个代码版本和 106 个超参数字段之间交叉比对,最终把问题锁定在负载均衡惩罚项的一处实现改动,以及它与特定参数组优化器状态之间的相互作用。这个问题横跨了基础设施和训练两个团队,单看任何一边都找不到原因。
破案二:模型为什么会「背」出一个 API key?
输入一个词「deepseek」,模型吐出一串形似 API 密钥的字符,然后无限重复同一段代理配置;问它晚饭吃什么,它却开始做「Does this sentence make sense?」的选择题。agent 顺着这些怪异的输出提取模式,在 1,053 个数据子集中做大规模匹配,再追溯到具体的数据管线和加工环节:一处是代码语料中没清洗干净的配置文件,一处是开源问答数据里过滤不足的合成数据,还有一处是多样性不足的合成数据提示词。
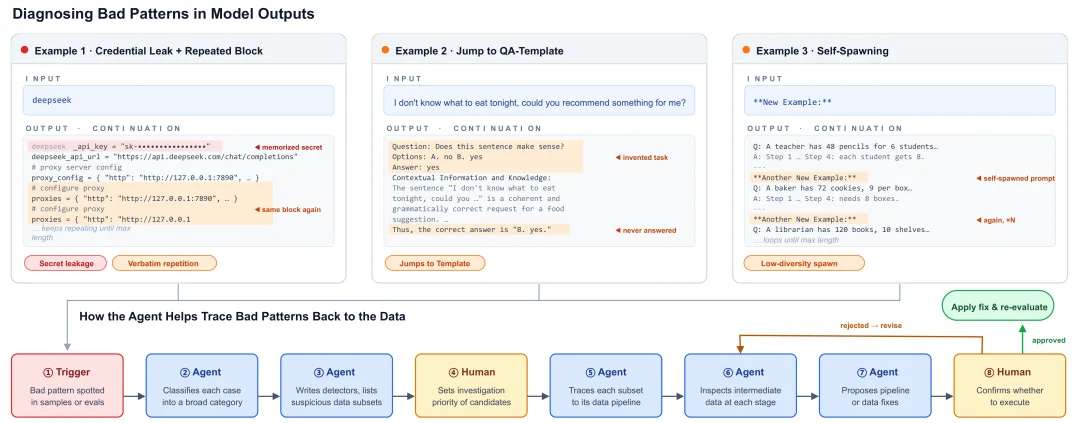
三类异常输出模式,以及 agent 将其追溯到具体数据管线环节的过程
这样跨团队的疑难问题,我们在大约一个月内解决了 5 个;按我们以往的经验,没有这套基础设施,每一个都可能耗费数月。
这些修复与数据、配方上的改进一起带进了正式训练。在相同的 1T tokens 训练量下,22 项基准的平均分从初版试训的 47.78,到修正版试训的 51.96,再到正式训练的 56.83。
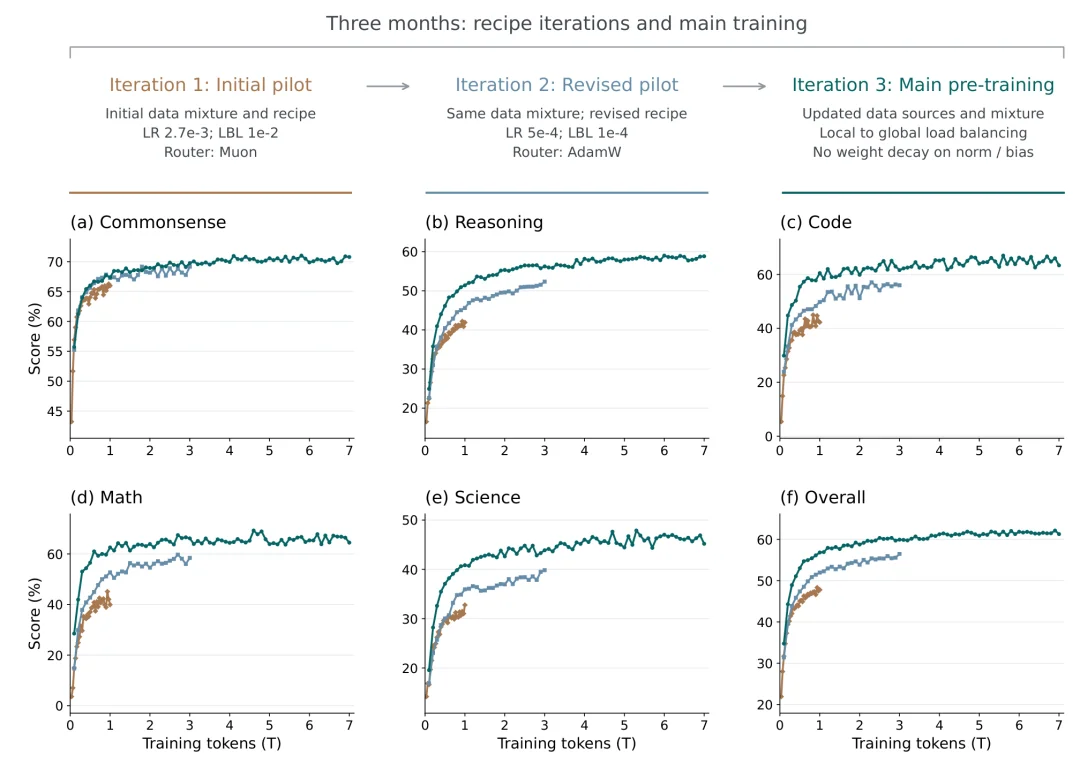
两次试训与正式训练:每一轮迭代都在上一轮的经验上变得更好
不是试水,是一个第一梯队的基座
很多新方法的第一次尝试,都停留在概念验证:在小模型上跑通,证明「可以做」。801 不一样。它是一个完整训练、直接对标业界最强开源基座的模型,而且成绩站得住。我们分三层比较,条件从最公平到对我们最不利:(1) base 对 base (2) 同一份 SFT 数据 (3) 再到只做轻量 SFT 的 801 对比完整后训练的模型。
第一层:base 对 base,跻身第一梯队
在 13 项基础能力评测上,801 的 base 模型平均分 73.13,与 NVIDIA 最新发布的 Nemotron-3.5-Lightning-30B-A3B(73.07)持平,领先 Qwen3-30B-A3B(66.16)近 7 分,仅次于参数更多的 Qwen3.5-35B-A3B。
第二层:同一份 SFT 数据,差距被拉开
当每个 base 模型都用完全相同的数据微调后再比较,801 的 13 项平均分达到 81.34,领先 Nemotron-3.5(79.88)约 1.5 分、领先 Qwen3(78.27)约 3 分,依然只落后于参数更多的 Qwen3.5。在长上下文和知识类评测上,801在AA-LCR v1.1(61.0)和 AA-Omniscience(31.3)上均位列第一。这说明 801 的后训练潜力是扎实的。
第三层:只做轻量 SFT,对上完整后训练的模型
这一层对我们最不利:801 只做了 6B tokens 的轻量 SFT,没有任何强化学习,数据量只有各家厂商后训练的几十分之一甚至几百分之一;而对手都是经过完整后训练流程的正式发布版本。即便如此,在 SWE-bench Verified、SWE-bench Pro、CyberGym 和 KernelBench 四项 agent 评测上,801 的平均分为 58.4,高于本次对比中的 K2-36B-A4B(45.3)、Qwen3.6-35B-A3B(44.6)和 Gemma-4-26B-A4B(36.1)。
和 Flint 正面交手
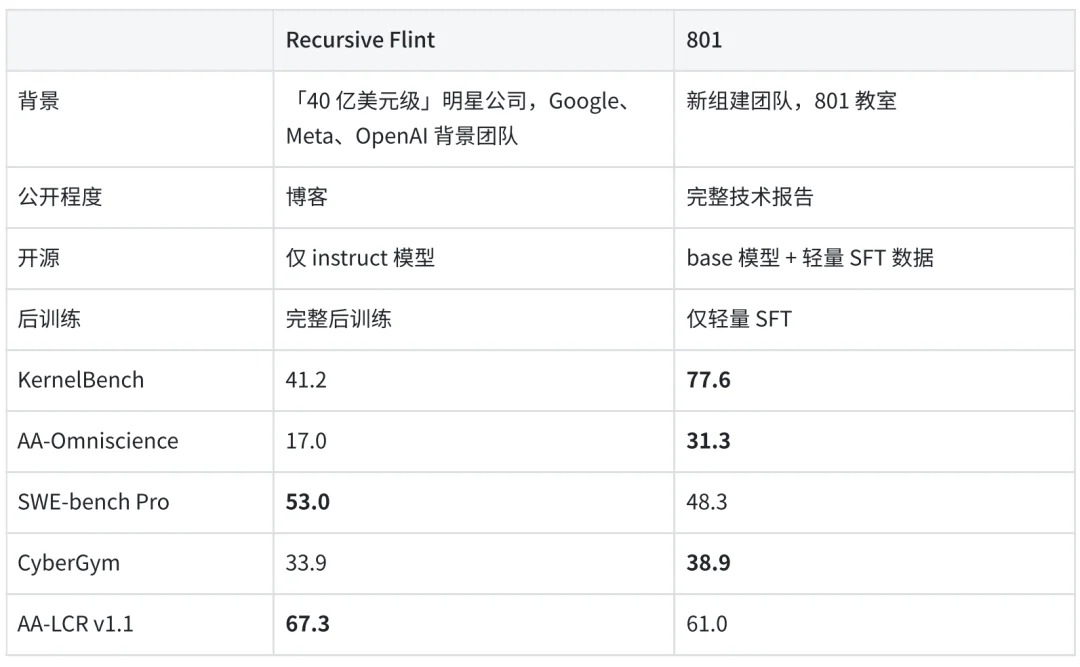
只做了轻量 SFT 的 801,在 KernelBench 和 AA-Omniscience 上大幅领先 Flint 的完整后训练版本,在另外两项上仍有差距。考虑到双方在资源和后训练投入上的悬殊,这个结果本身就说明了很多。
一个新团队、三个月、只做了轻量 SFT 的 base 模型,已经能和厂商经过完整后训练的模型正面交手。经过完整后训练之后它能走多远,是我们下一阶段要回答的问题。
我们发布了什么,以及该怎么比较
这次发布的核心是预训练本身,因此我们开源的是 base 模型,同时开源用于测量后训练潜力的轻量 SFT 数据,以及完整的技术报告。完整后训练的版本将在下一阶段发布。
Q:为什么只发 base 模型,不发 chat 模型?
A:这次的重点是预训练。base 模型才是预训练的成果;完整后训练的版本会在下一阶段发布。
Q:轻量 SFT 是做什么用的?
A:它是一把「尺子」,用来测量 base 模型还有多少后训练潜力,而不是一个成品 chat 模型。我们把这份数据开源,社区可以用它来评估任何 base 模型。
Q:拿 801 和别家的 chat 模型直接比,公平吗?
A:不完全公平,这相当于拿刚封顶的毛坯房和精装修的成品房比较。我们建议 base 对 base,或在同一份 SFT 数据下对比;与完整后训练模型的比较,只作为潜力的参考。
后训练 RSI 的起点,是预训练的终点
所有后训练 RSI 都有一个前提:先有一个足够强的 base 模型。而这,恰恰是预训练要产出的东西。
把 RSI 带进预训练,意味着 AI 开始改进制造 AI 的工序本身。这不是又一次刷榜,而是基座模型生产方式的改变。当这道工序可以自我改进,每一代基座都会成为下一代的起点。801,是这个闭环在前沿预训练上转动的第一圈。
「预训练只有一次机会。这时候要改进的,不再是一个模型,而是整个组织。」
—— 刘鹏飞
这条路需要更多的算力、更多的人才和更多的同行者。欢迎大家下载模型和数据,复现、比较、拍砖;并欢迎算力与产业伙伴和我们一起,把这个闭环转得更快。
文章来自于"机器之心",作者 "机器之心"。
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0