这几天,机器学习顶会 ICLR 2027 的首轮评审意见陆续公开。
对论文作者来说,这通常是一个颇为紧张的时刻。几个月甚至一两年的研究工作,终于要接受同行检验。审稿人会仔细检查方法、实验和理论推导,指出研究中真正存在的问题。
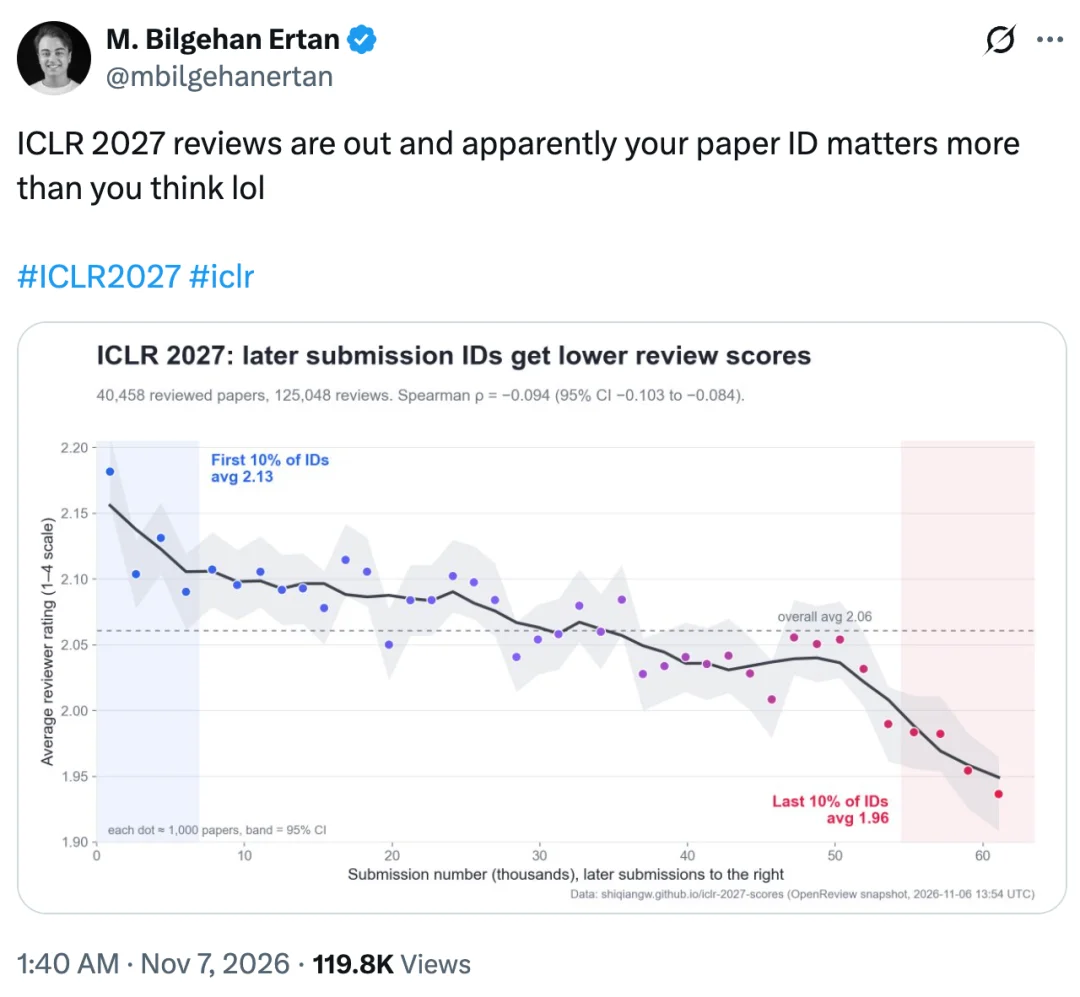
但今年,一些研究者打开 OpenReview 后,看到的评审意见却让人有些哭笑不得。
ICLR 2027 的同行评审,一时间成了 AI 圈的一场大型吐槽现场。
有人让作者解释标准差
有人把 AI 提示词直接贴了上来
先来看加州大学伯克利分校的 Hanchen Li。
他发帖称,自己收到了一份 ICLR 评审意见,对方要求他们解释什么是「standard deviation」(标准差)。
他还开玩笑说,这下仿佛又回到了高中课堂。
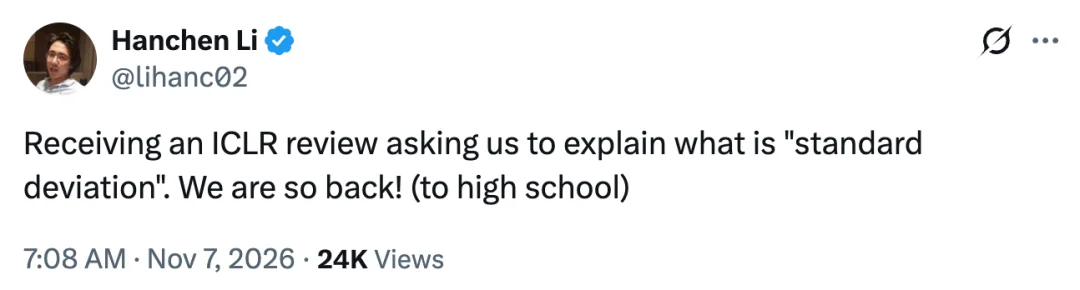
原帖没有展示完整的论文和评审上下文,无法判断审稿人究竟是希望作者补充统计定义,还是对论文中的具体用法存在疑问。
但这条帖子还是迅速引发了讨论。
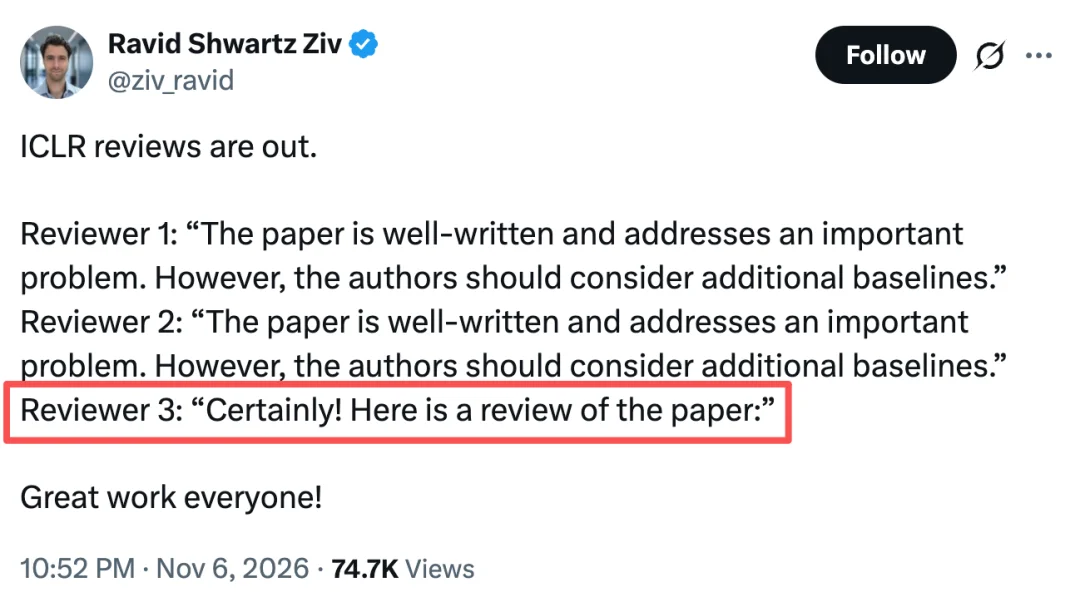
另一位研究者 Ravid Shwartz Ziv 展示的情况,则更加有喜剧效果。他贴出了三位审稿人的意见。
第一位写道:「The paper is well-written and addresses an important problem. However, the authors should consider additional baselines.」第二位几乎原封不动地重复了这句话。
到了第三位,画风突然变了:「Certainly! Here is a review of the paper」。后面才开始进入正式评审内容。这下连 AI 生成文本常见的对话开场白都没有清理干净。
两份评语像是从同一个模板里复制出来,第三份则留下了更明显的 AI 生成痕迹。更让作者无奈的是,这些意见最终都进入了正式的同行评审流程。
还有一位研究者 Konstantin Grotov 遇到的问题,则涉及 AI 辅助写作。他表示,自己提交 ICLR 的论文收到了一条主要针对 AI 使用情况的评审意见。
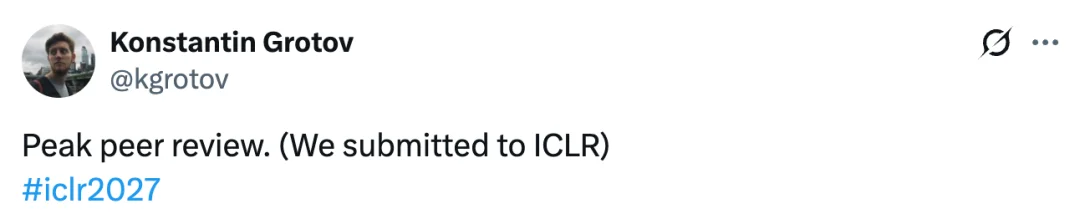
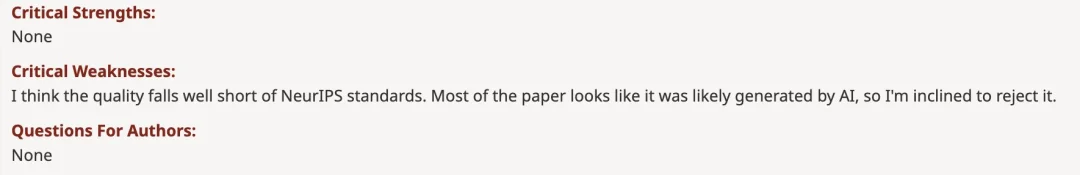
问题在于,论文已经按照要求披露了 AI 辅助写作。
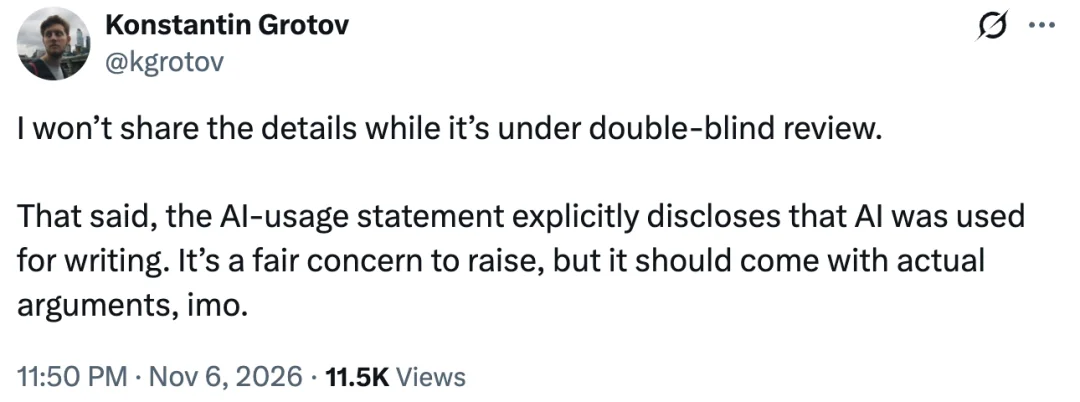
Grotov 随后解释,审稿人当然可以对 AI 使用提出质疑,但应该拿出具体的技术论据,说明这种使用如何影响了论文的质量、研究结果或可信度。仅仅因为论文使用了 AI,就把它当成拒稿理由,显然不够充分。
接下来的一个案例更为微妙。
研究者 Artur Chakhvadze 分享了一份评审意见,其中审稿人坦承自己并不具备充分的专业背景,无法很好地评估这篇论文。
Chakhvadze 对此反而表示认可:至少这位审稿人诚实地承认了自己的能力边界。他还吐槽,自己见过不少评审连论文所属领域的基础知识都没有弄明白,却依然给出 3/4 的高信心评分。
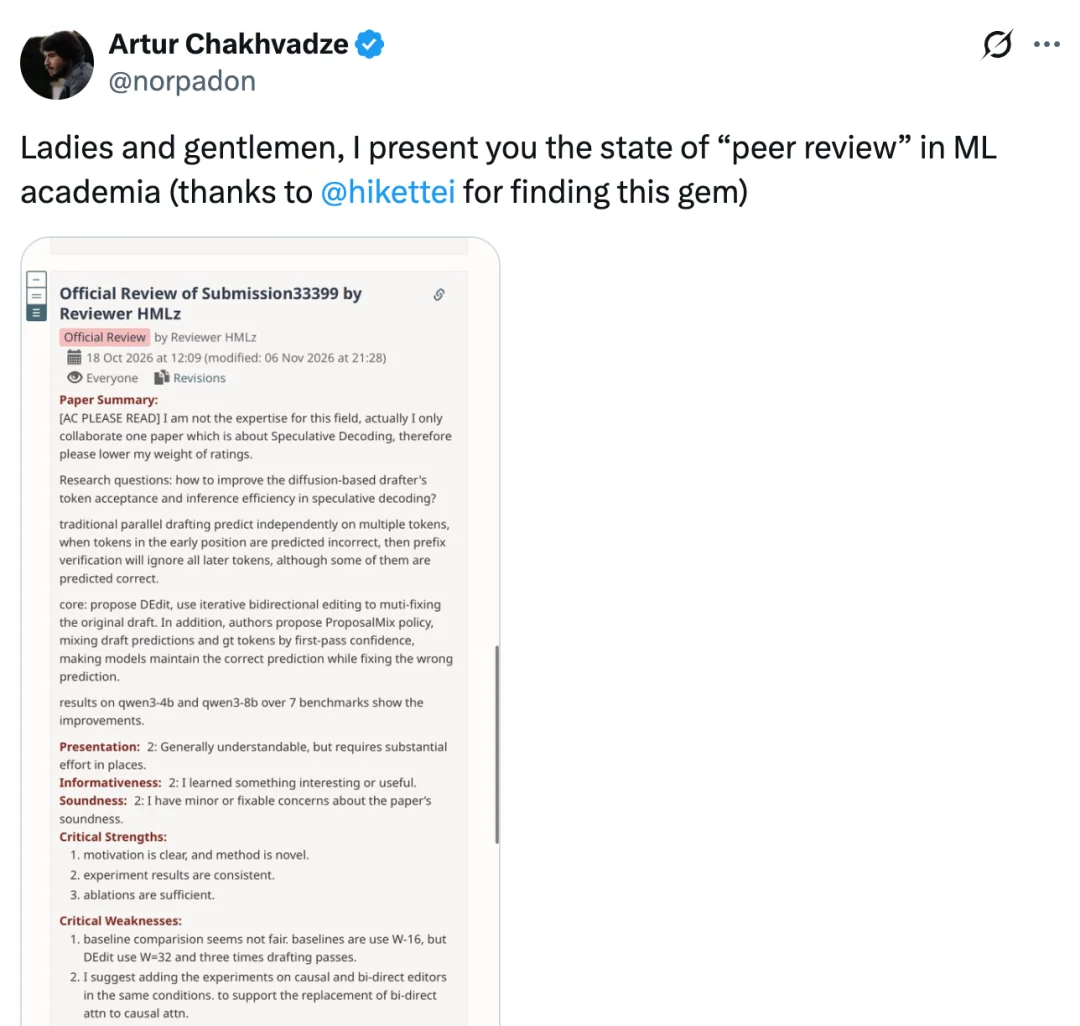
这条帖子引发了不同意见。有人认为,审稿人主动说明自己不熟悉研究方向,已经比装懂、胡乱编造评审意见负责任得多。也有人追问:既然专业背景不匹配,为什么这篇论文一开始就会分配给他?Chakhvadze 随后也补充了一句:审稿人本人未必有错,真正值得质疑的是分配和管理评审的流程。
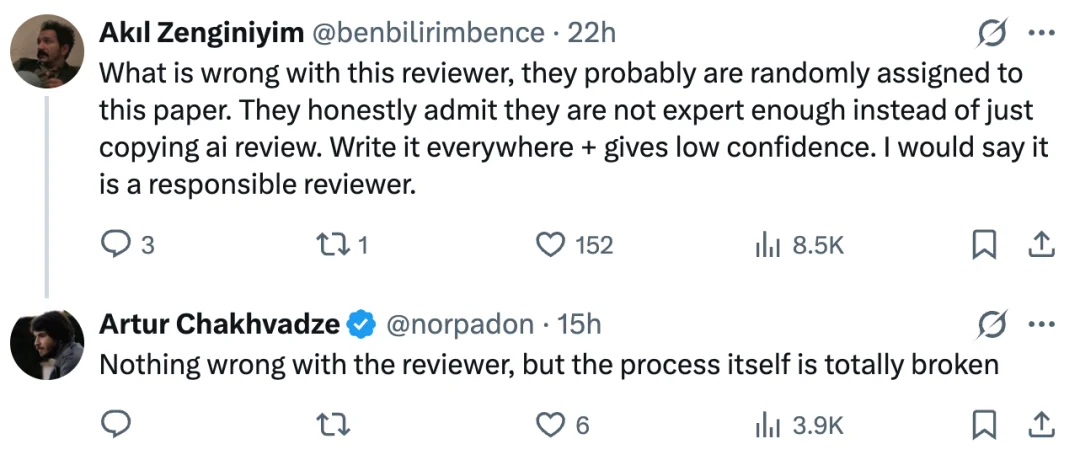
几条帖子看下来,其实是不同类型的问题:有人没有充分理解论文,有人可能依赖 AI 生成评语,还有人被分配到了自己并不熟悉的研究方向。这些最后都落到了同一个问题上:作者拿到的评审意见,到底能不能真正帮助学术判断?
AI 擅长找毛病
却未必知道什么毛病值得拒稿
这次讨论中,有一条观点尤其值得注意。
来自德克萨斯大学奥斯汀分校的 Jiaxin Pei 指出,自己在 2026 年最头疼的审稿问题,是 AI 审稿人似乎分不清论文的「局限性」和真正影响论文成立的「关键问题」。
他认为,大语言模型可以轻易找出一篇论文上百个局限性,即使是历史上最优秀的论文也不例外。但这并不意味着这些论文就不应该被接收。
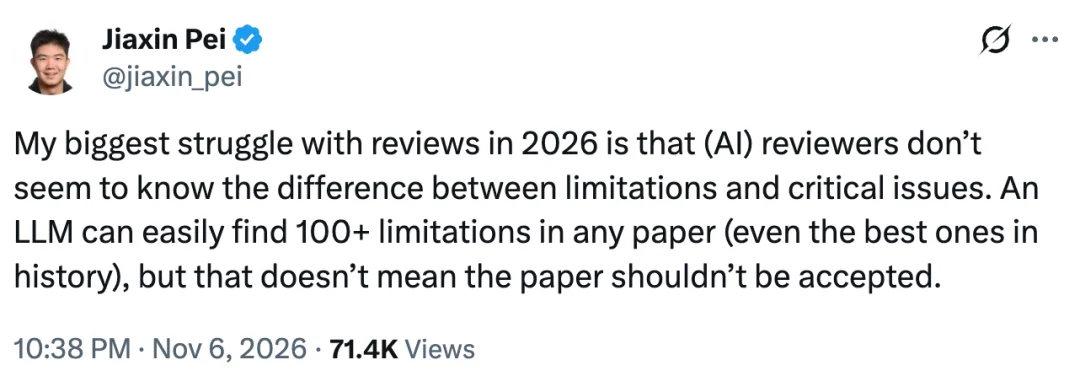
这句话点出了 AI 参与同行评审时一个很重要的短板。一篇科研论文几乎不可能做到面面俱到。实验规模可能有限,某些场景没有覆盖,方法可能依赖特定假设,理论分析也可能存在适用范围。这些都是正常的研究局限。
真正决定论文是否成立的,是这些局限有没有动摇它的核心贡献。
审稿人当然可以要求增加更多数据集、模型规模和对照实验。但如果现有实验已经足以支撑论文的核心结论,额外实验就未必构成拒稿理由。反过来,如果论文最关键的实验设计存在漏洞,或者理论推导中有无法修复的错误,即使其他部分写得再漂亮,也可能无法成立。
这里需要的是判断问题重要性的能力。大模型却很容易把这两件事混在一起。它可以不断列出潜在问题,却未必能判断哪个问题真正影响研究结论。于是,评审意见可能越来越长,要求补充的实验越来越多,真正决定论文质量的核心问题反而被淹没。
Jiaxin Pei 的这条帖子引发了不少研究者共鸣。
有人指出,这种问题正在渗透到同行评审机制本身。如今,每场 AI 学术会议上,似乎都会出现一批审稿人:他们一边给论文打出较低的评分,一边又要求作者补充一些无关紧要、或者只是对现有实验做小幅增补的新实验。
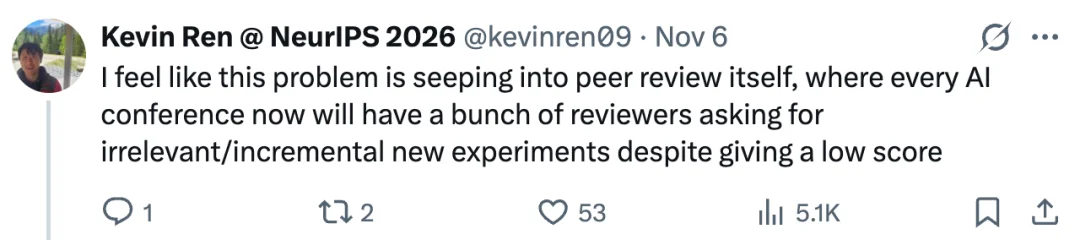
还有人提出一个很直接的判断标准:如果修复这个问题,论文的核心结论会发生变化吗?如果答案是否定的,它可能只是一个普通的局限性,而不是足以否定整篇论文的关键缺陷。这恰恰是同行评审最需要的能力:知道什么值得关注,也知道什么可以接受。
结语
如果把这些案例放在一起看,就会发现,ICLR 这次的争议并非单纯的审稿人水平问题。
更大的背景是,AI 正在同时改变学术研究的生产端和评价端。
同行评审本身是一项高度依赖专业知识和时间投入的工作。论文数量增长的速度,未必能被专业审稿人的数量追上。ICLR 2027 项目主席团队此前就专门解释过这个问题。9 月 2 日,ICLR 2027 项目主席团队发布了一篇官方文章,分析了 AI 时代同行评审面临的新压力。
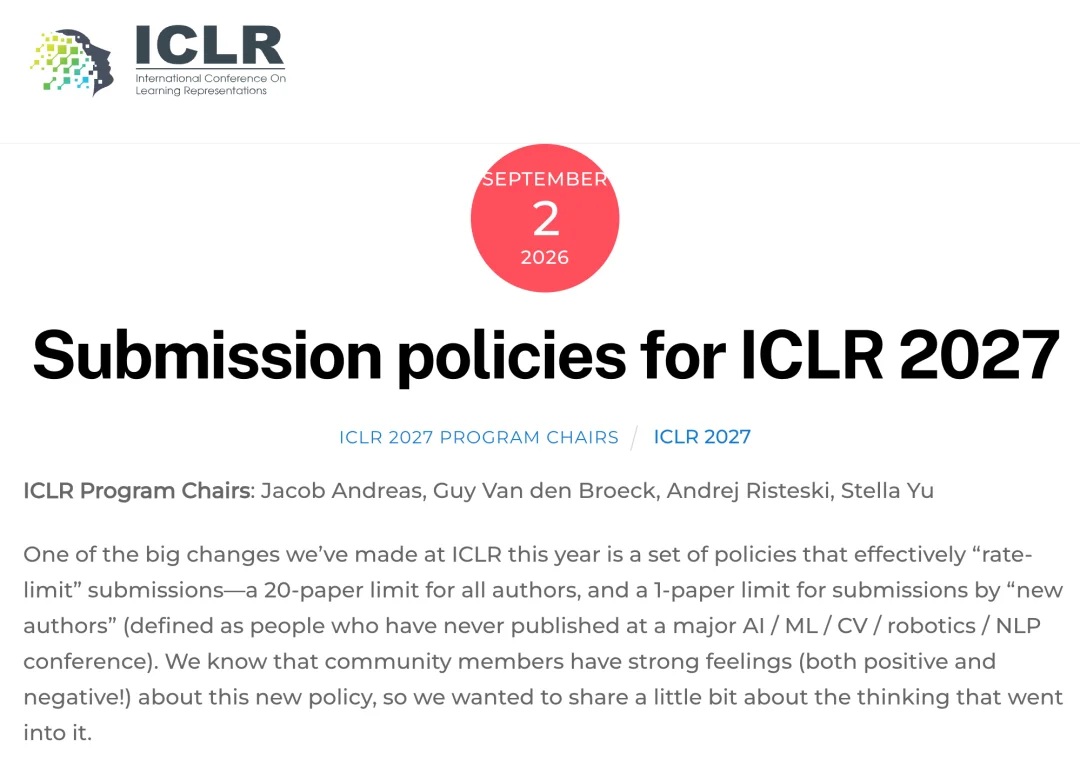
https://blog.iclr.cc/2026/09/02/submission-policies-for-iclr-2027/
主席团队指出,机器学习领域近年来增长迅速,新进入者的数量远远超过资深研究者,具备专业评审能力的人手可能跟不上投稿增长。生成式 AI 又进一步降低了论文生产门槛,即使是不熟悉某个研究领域的人,也可以借助 AI 生成一份外观上像研究论文的稿件。与此同时,审稿人将评审工作交给 AI,也成为需要解决的新问题。
为缓解评审资源紧张,ICLR 2027 推出了一系列措施,包括限制投稿数量、强化互惠审稿制度等。
审稿义务也进一步收紧:署名出现在 3 篇及以上投稿中的作者,必须至少完成 6 篇论文的审稿工作。此外,每篇投稿至少需要有一位具备规定资格的作者注册成为审稿人,并承诺评审至少 3 篇论文。如果所有作者都不具备相应资格,则可以豁免这项要求。
在 AI 使用方面,ICLR 没有完全禁止审稿人使用大模型,而是允许有限度、负责任地使用 AI 辅助撰写评审意见和元评审。但这有明确的前提:审稿人必须披露 AI 使用情况。如果使用大模型生成或修改评审意见的任何部分,还必须提交自己最初独立撰写的论文评估,以及与大模型的全部交互记录。多轮对话也必须提供各轮输入内容。
ICLR 还明确规定,如果 AI 生成的评审包含虚假信息、幻觉或失实陈述,或者评审本身质量低下,审稿人可能因未履行互惠审稿义务而受到纪律处分。处罚可能包括将其作为作者参与的全部投稿直接拒稿,或者限制其未来参加会议投稿。
当然,目前公开的只是 ICLR 首轮评审意见。作者与审稿人的公开讨论将持续到 11 月 18 日,最终录用决定预计在 12 月 16 日公布。作者仍然有机会针对错误评审提出质疑,审稿人也可以根据新的信息修改自己的评分。
参考链接:
https://x.com/mbilgehanertan/status/2118760558854070637
https://x.com/jiaxin_pei/status/2118714662892327158
https://x.com/norpadon/status/2118896999709684071
https://x.com/lihanc02/status/2118843054975336646
https://x.com/kgrotov/status/2118695897890804071
https://x.com/ziv_ravid/status/2118718086920413494
文章来自于微信公众号 “机器之心”,作者 “机器之心”
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0