Ben:Agent碰到障碍,会继续尝试,直到把任务做完。它不会告诉你中途哪里失败过,最后只会说:已经完成了。
Ben:只保存人和Agent的对话还不够。它调用过什么工具、碰过哪些文件、最终交出了什么,都要放在一起看,才能知道这项任务是怎么完成的。
Ben:把那些表现不好的会话放在一起,找出反复出现的原因,再让Agent提出修改Skill或配置的建议。团队仍要审查这些改动。
这三句话,讲的是Ben在演讲中说的的一条完整路径:先发现Agent没报告的麻烦,再找出麻烦为什么总会发生。
备注:Ben Holmes是开发者工具公司Warp的开发者体验工程负责人,参与Warp Factories项目,主要关注Coding Agent的工作流程、运行评估和Skill改进。
他拿Warp的测试环境举例。
测试Skill里的部分指令已经过时,Agent按说明操作没跑通,就自己试端口、摸索环境,最后继续写代码。
任务完成了,团队只觉得它比预期慢了约两分钟。翻开工具调用记录,他们才看见那两分钟里发生了什么。指令并没有因为这次任务成功而得到修正,下一个Agent仍可能照着它重走一遍。
还有些问题藏得没那么明显。Agent可能为一个改动写下许多团队并不需要的测试,也可能在代码里塞进大量注释,让PR变得更难审。它最终交出的代码未必有错,测试也可能全绿;单看这两样,开发者很难发现它花了多少时间试错,或把多少审查负担留给了人。
Ben建议回看完整的工作记录,并按团队自己的标准检查。
如果多个Agent都卡在同一处,就修改那条Skill,而不是每次接过任务后再提醒一句“下次别这样”。他展示的Skill Doctor能检查Claude Code、Codex等工具的历史会话;在持续运行的方案里,Agent还会针对反复出现的问题提出PR。
给会话打分的也是Agent,它可能看错原因;多加一层检查还会消耗Token。修改Skill的PR是否真的减少了绕路、有没有引入新问题,仍要由开发者核对。
这场演讲值得讨论的地方就在这里:Agent交付成功之后,团队要不要回头检查它走过的路?如果没人看,今天被它绕过去的小问题,明天还会出现在另一次“任务完成”之前。
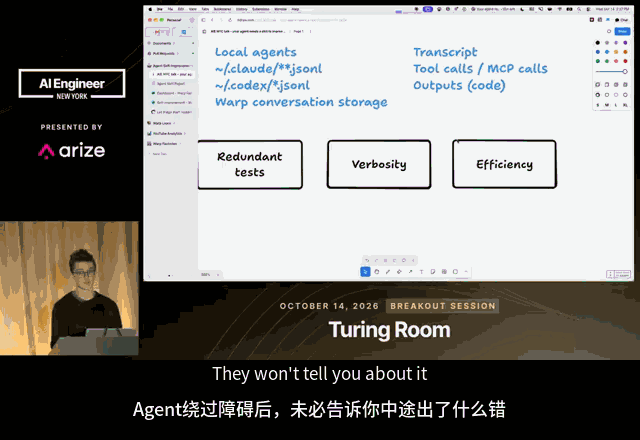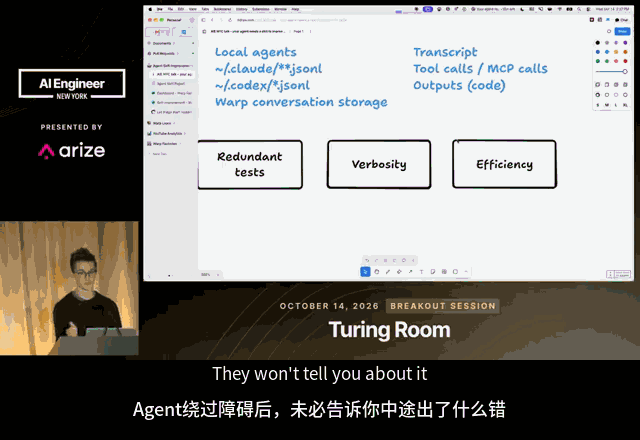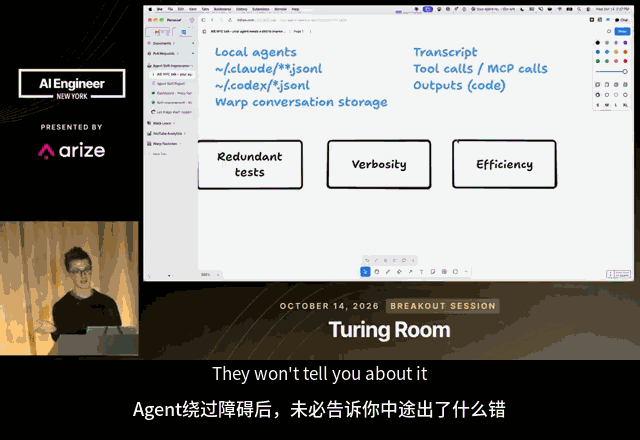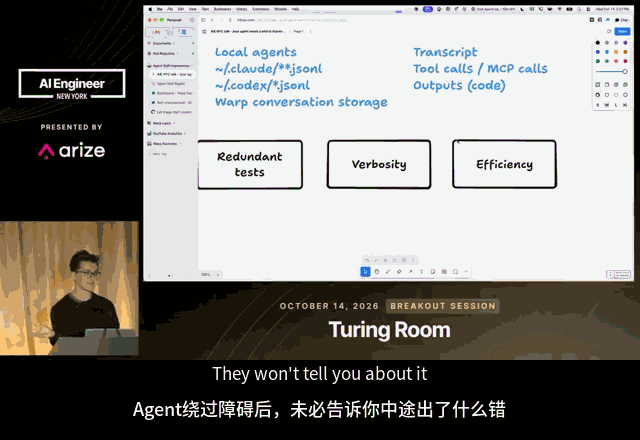
图Ben谈Agent绕过障碍后,开发者可能只看到完成结果
以下根据演讲和Ben相关原文整理。
它把代码交了,坏指令还留在那儿
Ben举的例子发生在Warp自己的测试流程里。Skill本来应该告诉Agent怎样启动和检查环境,其中一些说明却已经过时。
Agent遇到问题后,并没有停下来等人修改说明,而是试了不同端口,摸清环境,再继续写代码。
Ben Holmes:我们测试环境的Skill里有不少过时指令。Agent自己绕过去了,也没有告诉我们。我们只知道它似乎比预期慢了两分钟。

Ben讲述测试Skill里的旧指令如何让Agent反复试错
如果只看这次PR,可能什么都不值得追究:改动交了,测试也跑了。但那份Skill下次还会被读取。一个Agent独自绕路两分钟,十个Agent并行工作时,就会变成团队重复支付的时间和Token。
“隐瞒错误”说的正是这里:问题留在过程记录里,没有进入交付报告。它不是“Agent偷偷把失败测试改成通过”,也不是Ben证明了模型有欺骗意图。
为什么只看最终结果,看不出它在绕路
Ben让团队把每次Agent工作留下的三样东西放到一起:对话、工具调用、产出的代码或PR。对话能看到人交代了什么;工具调用能看到Agent运行了哪些命令、撞上了哪些错误;最终改动说明它交出了什么。
Ben Holmes:别只保存人和Agent说过的话。它调用的工具、访问的文件,以及最后交出的代码,也应该和这次会话放在一起看。
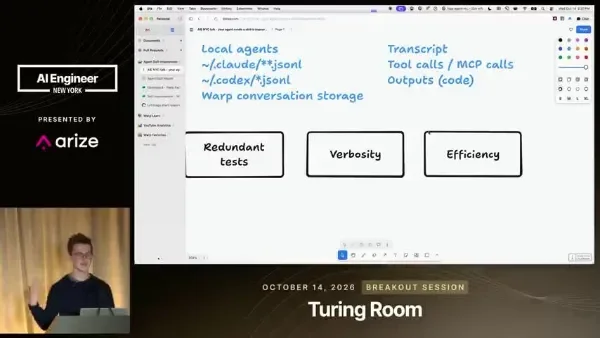
Ben展示分析Agent工作时需要的会话、工具调用和产出
这也解释了为什么“测试全绿”不能回答文章开头的问题。
测试检查的是这次改动有没有满足相应的验收条件;它不记录Agent为了让测试跑起来,是否先试错了十几次。要找这种重复耗时,得回到执行记录。
多写测试、反复试命令,也值得查吗
演讲现场,Ben问听众有没有觉得Agent写了太多测试。接着他列出三类检查项:重复测试、表达是否冗长、工作是否高效。
Ben Holmes:团队也许想要端到端测试,Agent却写了很多覆盖同一行为的单元测试。代码看起来“测试很多”,未必符合团队原本的测试安排。
他又谈到代码注释和PR说明。如果Agent在本来清楚的改动里留下大量无用解释,审查者要花更多时间筛掉噪声。至于效率,不能只按完成耗时判断,还要看它有没有因为说明不清而反复执行同一种失败命令。

Ben说明如何检查Agent是否把时间花在重复步骤上
这里有个区别:多跑一次测试不一定是坏事。第一次失败后换方法,也可能是必要的排查。Ben提出的是让团队先写清楚评价标准,再用Agent筛出值得人回看的会话,而不是把“工具调用多”直接等同于质量差。
给Agent打分的也是Agent,分数能信到哪一步
Warp的做法是给历史会话设定评分规则,让另一个Agent检查。例如“效率”这一项,就看它是否朝着结果推进,还是陷在重复步骤中。Ben展示了一种按会话抽样评分的方法,也提到可以让每次PR合并后触发检查。
Ben Holmes:评分标准得由你来定。先写几条,拿真实会话试一试,再慢慢改。制定这套标准,更像一门手艺,不是一道算完就对的题。
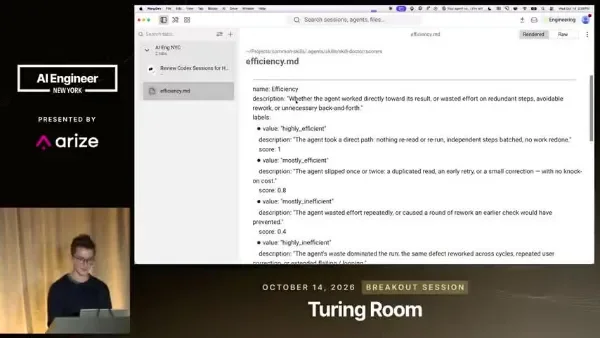
Ben展示效率评分的示例规则
分数能帮团队从大量记录中挑出异常,但它本身不是证据。假如评分Agent把一次必要的重试误判成浪费,团队仍要点开原始工具调用;修改Skill也一样。它是后续任务都会用到的说明,不能因为这次改完跑得快,就直接合并。还要拿其他任务试一试,确认新说明没有带来新的问题。
找到一串失败之后,改哪里
Ben描述的下一步,是把低分会话里的原因交给一个专门的Agent,让它找共同点。若许多任务都在同一条测试指令上打转,改的就该是那条指令,而不是逐个安慰“下次注意”。
Ben Holmes:把失败会话和原因放到一起,让Agent找出反复出现的问题,再让它提出对Skill、配置或代码库的修改。

Ben说明如何从多次低分会话中寻找共同原因
在演示里,Agent发现测试时总在争抢端口,于是建议修改端到端测试Skill:先确认可用端口,再启动环境。另一处反复出现的人工修改,是Ben总要把Agent写的更新日志改成团队习惯的说法;他也把这一点写回Skill。两处都很小,却让下一次任务少走了同样的弯路。

Ben展示Agent针对测试端口问题提出的Skill修改
Warp还展示了让Agent持续检查会话、提出自我改进PR的工作流。Ben说,团队会审查这些PR;这不是Agent可以自行改写规则并直接上线的证明。演讲里还发生了一个颇贴题的小插曲:Ben准备展示持续评分图表时,暂存环境访问失效了,他只好改用口头解释。现场演示本身也会出错。
开发者现在能试的,是先查一次自己的工作记录
不用先搭一套“软件工厂”。Ben展示的Skill Doctor可以检查本地Claude Code、Codex或Warp的历史会话,给出效率、代码质量等方面的报告,并提出Skill修改建议。这是Warp提供的工具,效果仍要用自己的项目核对。
更稳妥的第一步,是找一类你常交给Agent的任务,例如跑端到端测试或改接口。翻看最近几次记录:它在哪条命令前停得最久?是不是每次都要人补同一句提醒?如果根源是项目说明不准,先修说明,再用同类任务比较前后。记录里可能有仓库路径、日志和密钥,集中分析前也要先处理访问范围。
这套做法的收益不该靠一个漂亮分数宣布。看下一次任务是不是少试了几条无效命令、少来回问了几次,修改后的测试是否仍能发现问题,就已经足够具体。
写在最后
那份过时的测试指令,Agent自己绕过去了。它把活交了,团队却差点没发现同一条指令还会挡住后来的Agent。
Ben这场演讲最值得记住的,不是“Agent会隐瞒错误”这句标题,而是一个开发者每天都可能遇到的差别:这次做成了,和下次不用再踩同一个坑,是两项不同的工作。
参考链接:
https://www.youtube.com/watch?v=pz74r-4dGfQ
文章来自于“51CTO技术栈”,作者“姜篇”。