最贵的模型,不该承包最简单的工作。
当云端模型厂走在“斩杀线”边缘,端侧公司,正在悄悄摘下低垂的果实。
万格智元是其中一家。这是一家由清华、北大、中科院等00后学生创办的算力基础设施公司。过去一年,AI 经历了几波热潮,万格团队始终在打磨一套“端侧底层”:不造芯片、不做模型,只做模型和硬件之间的推理系统——让算力摆脱GPU,让小内存装下大模型。
这家公司势头很猛。一个月拿下头部大客户千万级订单,三个月完成交付和回款,客户覆盖头部PC和NAS厂商;半年时间,迅速完成三轮累计近亿元融资,最新一轮融资零一创投、CCV、松禾资本与上市公司彩讯科技参与,老股东五源资本、峰瑞资本继续追加投资,公司成立一年即实现盈利。
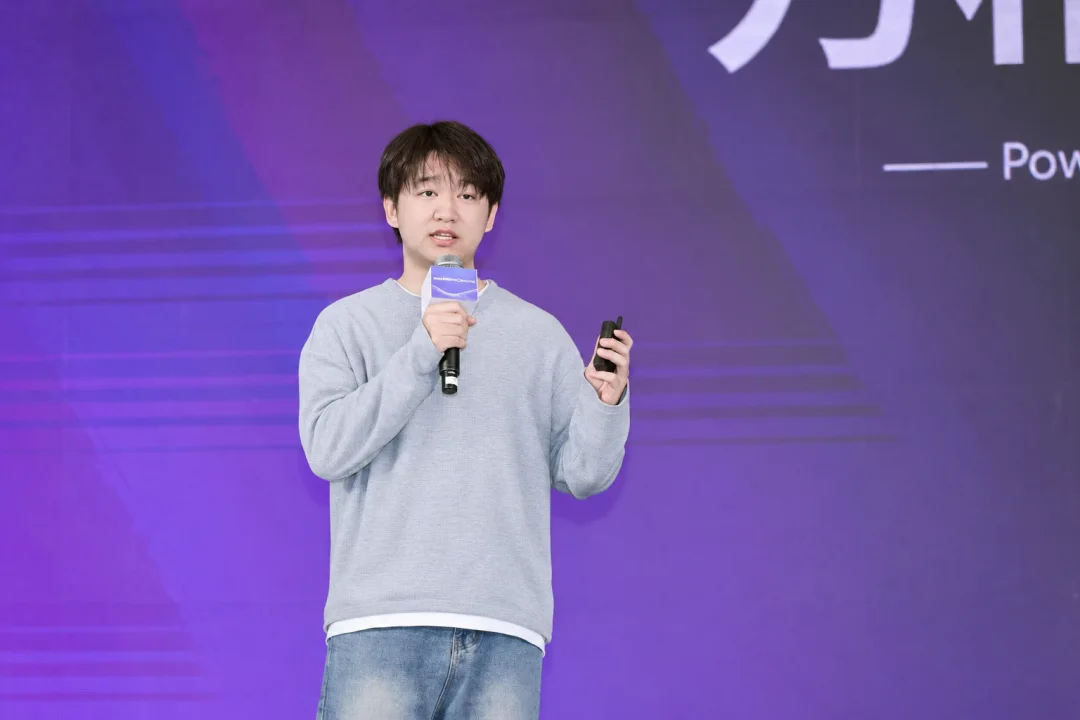
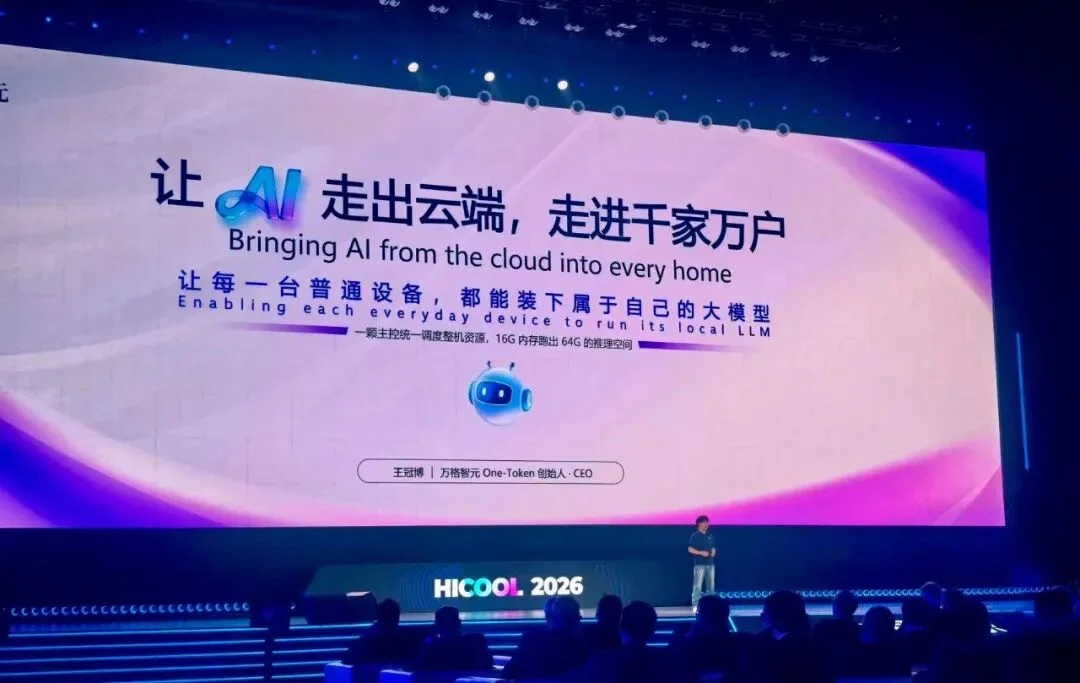
万格智元CEO王冠博
现在,他们杀入C端市场,推出两款AI产品:Token WiFi 和视频生成工作站Vilot。
“Token WiFi ”号称要做“Token界的WiFi”,打消用户的Token焦虑,把Token从“按量计费的流量”变成“像WiFi一样的本地供给”。
视频生成工作站 Vilot,直接把视频生成成本击穿:“Minimax H3模型下,10秒视频生成的成本,估算只要不到两毛钱”,万格智元CEO王冠博的原话是,“不拿缩水模型凑数。目标是把这类设备的门槛从十万元级拉到千元级”。
一家toB公司,为何要在此刻杀入C端?“Token界的WiFi”硬件最快什么时候推出、怎么定价?视频生成工作站Vilot,真能解决视频生成的抽卡弊病吗?要把视频生成成本打到地板,万格的“杀手锏”是什么?带着这些问题,我们和万格CEO王冠博聊了聊。
下面是十字路口与万格智元CEO王冠博的完整对话实录。
快问快答
🚥 十字路口
先用几个快问快答让大家快速认识你,请问你的年龄?
👦🏻 王冠博
00年,26岁
🚥 十字路口
毕业院校?
👦🏻 王冠博
清华大学计算机系
🚥 十字路口
一句话介绍现在的公司和产品?
👦🏻 王冠博
万格智元成立于2025年9月。
我们希望去定义下一代Token网络,让 generate token 和 reasoning token 实现自由生产,最终实现全民算力普惠。
我们要把昂贵的云端Agent和视频生成,做成个人能负担的产品。
目前我们的产品有“端侧Token工厂Token WiFi ”和“视频短剧生产站Vilot”。
🚥 十字路口
融资情况?
👦🏻 王冠博
半年时间融了三轮,累计融资额近亿元。
🚥 十字路口
收入和利润?
👦🏻 王冠博
目前订单在千万元量级。
🚥 十字路口
团队规模?
👦🏻 王冠博
40-50人。
🚥 十字路口
创业前在做什么?
👦🏻 王冠博
我一直做端侧系统方面的research,之前在Kimi、阿里、微软等公司做infra。
做“Token界的WiFi”
🚥 十字路口
你们提出“Token界的WiFi”,可以怎么理解?用户为什么需要这样一个Token WiFi ?
👦🏻 王冠博
“Token界的WiFi”是一个类比。
WiFi改变了人们使用网络的方式:从时刻关注流量和费用,转向更自由、更持续的连接。我们希望Token的使用也能发生类似变化。
从物理层面看,WiFi打通了网络连接用户的“最后一公里”;从经济层面看,WiFi则改变了人们对网络使用成本的感知。它满足了大家无限量且免费使用互联网的需求。
现在的Token仍然是“按量计费”,相当于还处在移动互联网的3G时代。我们希望打造“Token界的WiFi”,满足大家“无限量且免费”使用Token的需求。
以前流量贵的时候,人上网是算着用的,看视频要挑清晰度;连上 WiFi 之后,才敢随便刷、随便下、随便试新东西。今天用 AI 也一样,很多人会盯着额度,多跑几轮 Agent、多试几个版本,心里就开始打算盘。
云端那笔钱的性质是租金:用户付的不只是电费和芯片费,还有机房、运维和中间商的差价。WiFi 不一样,你自己买了一台设备,一次性成本出去了,归属权在你,所以可以一直用。
很多新应用也不是被设计出来的,而是大家用得起之后,一点点试出来的。
便宜的意义不只是省下原来那张账单,它真正改变的是“敢不敢试”。
我们希望让用户从租用智能,走向拥有智能。
🚥 十字路口
简单介绍一下你们这款AI产品“Token界的WiFi”。它能给用户带来的最直观收益是什么?
👦🏻 王冠博
我们一直认为,Token就是新一代的网络基建,未来流量和Token是一体化的。
我们产品叫 TokenWiFi,它的形态是一台常驻设备:模型跑在设备上,电脑、手机和兼容的应用可以直接连过来用。
我们希望改变现在使用AI的范式,未来连上网之后,所有 AI 应用都能跑,就如同现在的APP一样。
我们的设计不改变用户已有的工具——你原来用什么写东西、做什么任务,还用它,我们只在下面把模型运行和成本接住。
对个人来说,最直观的收益有两条:
一部分日常任务不再按次扣云端额度,可以本地无限量,改变过去token计费模式;
二是数据存在本地,不会上云,安全隐私与边界更清楚。
它会是一个超出很多人想象的价格。目前,发货正在准备中。
🚥 十字路口
技术上,你们有什么“杀手锏”?性能最强能飙到什么程度?
👦🏻 王冠博
万格智元的核心优势,不仅在于降低硬件成本,更在于通过底层技术创新,重新定义端侧 AI 的算力效率。
传统 AI 推理高度依赖 GPU,算力成本高、硬件资源消耗大,同时对 DRAM 内存容量也有较强依赖。万格智元通过两项核心技术突破解决了这两个问题:
第一,去 GPU 化的端侧推理架构: 通过自研算力调度与推理技术,让普通低成本 SoC 芯片也能释放接近高端 GPU 的推理能力,实现以低成本硬件获得类似 GPU 集群的算力服务。
第二,多级存储协同技术: 摆脱对大容量 DRAM 的依赖,通过多级存储协同,让小内存设备也能承载更大规模的模型,缓解端侧 AI 的内存瓶颈。
以目前的测试数据为例,万格智元在一款几十TOPS 约 300多美元的芯片上,跑35B模型,实现了 Prefill 速度约 3,000 tokens/s、Decode 速度约50-70 tokens/s,在目标推理任务上达到约 3,500 美元 NVIDIA RTX 消费级 GPU 的性能水平,相当于用几百美金芯片干出来了3500美金GPU效果。
这意味着,在性能相近的情况下,硬件采购成本可以降低约 88.6%,实现约 8.75 倍的硬件成本优势。
从长期来看,万格智元判断,未来行业真正需要的,不是更贵的 GPU 和更大的内存,而是能够通过软件与系统架构创新,实现算力和存储资源高效扩展的基础设施。
万格智元正是围绕这一方向,构建面向 AI Scaling 时代的新型端侧算力基础设施。
🚥 十字路口
AI终端正在爆发期。万格真正想做的是什么?
👦🏻 王冠博
万格智元想做的事情,是重新定义 AI 时代 Token 的生产和供给方式,让用户身边的电脑、手机等终端都成为 AI 的生产端,构建低成本、分布式的推理网络。
当前,AI产业面临的核心瓶颈是算力和内存:云端推理高度依赖昂贵的 GPU,端侧 AI 又受限于算力和内存,导致 Token 生产成本高、普及门槛高。
万格通过两项“核心技术突破”解决这一问题:一是去 GPU 化,让普通 SoC 芯片通过多设备算力协同,实现接近 GPU 集群的推理服务能力;二是去大内存化,通过多级存储协同,让小内存设备也能运行大模型,降低对 DRAM 的依赖。
我们认为,未来端侧将进入 SoC 时代,AI 也将进入大规模 Scaling 时代。
万格希望通过连接和释放海量分散的终端算力与存储资源,以更低成本、更高效率生产 Token,让 AI 能力像 WiFi 一样触手可及。
🚥 十字路口
为什么命名“万格智元”?
👦🏻 王冠博
万格智元是公司名,名字取自“万物格致,启迪开元”。
“格致”就是格物致知,追求事物的本质:模型在芯片上到底怎么算,数据存在哪,时间花在了哪里。
“智元”也有来历。当时我们很喜欢用“智元”来理解 Token:它承载的是智能,不只是文字里的一个片段,这个意思就留在了公司名字里。
我们一直认为,用户记产品就好。技术的价值,就是让用户以尽可能低的门槛获得所需的能力。
我们目前打造的“Token WiFi ”和“视频生成工作站Vilot”,一个服务日常AI Agent使用,一个服务视频创作。
两款产品虽然应用场景不同,但底层依托的都是我们长期打磨的推理系统。
不拿缩水模型凑数,Vilot要把视频成本击穿
🚥 十字路口
介绍一下你们的视频生成工作站——Vilot?
👦🏻 王冠博
Vilot是一款面向短剧、漫剧及其他高频视频创作场景的本地视频生成工作站。
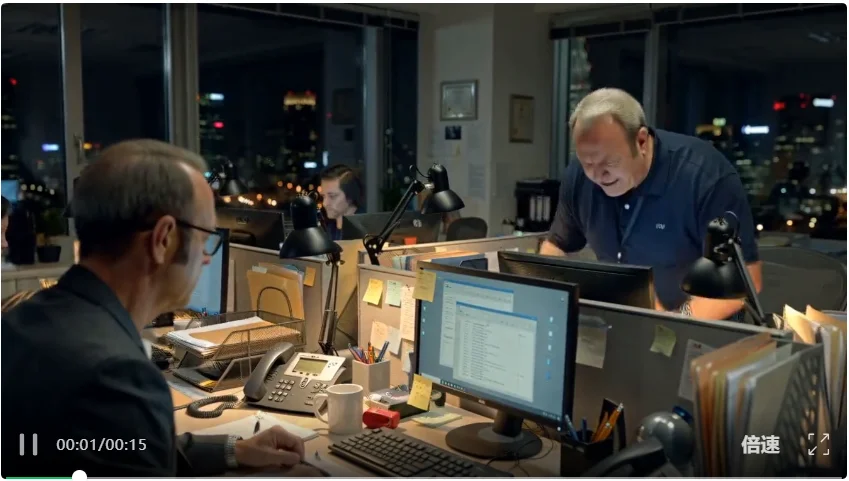
Minimax H3 模型下 Vilot 视频生成(15s)
简单来说,它是一台放在创作者身边的视频生成设备,让创作者能够以更低的成本持续生成视频,拥有更大的创作自由度。
我们的目标,是把这类设备的使用门槛从过去的十万元级降低到千元级。
和TokenWiFi一样,Vilot背后的逻辑,也是让用户能够以更低的成本持续生产Token。不同的是,我们将这种能力从语言模型进一步延伸到多模态,让视频创作者也能享受到本地推理带来的成本优势。
视频生成有一个很突出的特点,就是需要不断试错。同一个镜头可能要生成十几个版本,再筛选、剪辑、修改。按次付费的模式会使创作者对每一次尝试都更加谨慎,甚至提前放弃一些创意。
这是非常消耗心力的。我们常说,便宜和免费,是完全两件事。
端侧本地部署改变的就是这个环节。我们要做的是,从按量计费,走向一个纯粹的买断的生产力工具。
现在,用户基于我们的本地推理技术,单张 RTX 4090及以下,就能跑完整的Minimax H3视频生成模型。
🚥 十字路口
对一个视频创作者来说,Vilot 能帮他实现怎样的效果提升?
👦🏻 王冠博
最典型的用法是:睡前排任务,醒来挑片子。
因为做这个赛道,我们也调研了很多在 AI 短剧里做得很不错的 KOL,一个现实情况是,AI 视频赛道作为为数不多蓬勃发展的 AI 应用赛道,真正在里面赚到钱的创作者少之又少。简单来说,生成实在太贵了,而且非常抽卡。
现在,有了 Vilot后,创作者白天写脚本、做分镜,晚上把要反复生成的镜头和提示词排进队列,机器跑一夜。第二天早上收几十条新视频,挑能用的进剪辑,不满意的重新排。
剪辑软件、脚本工具都不用换,Vilot 工作站只接手最费钱、也最磨耐心的那一段。
用户的反馈上,有人说有种“种菜收菜”的乐趣。按高频创作者原来的用量算,一天能省下五六百块;有用户跟我们说,“一个月回本,之后都是净赚”。这是生成量大的创作者的账,量小的创作者回本慢一些。
更大的改变在创作方式上。
以前每生成一次都在花钱,创作者会不自觉地将就;现在一个镜头可以出十版,同一个点子可以试三种运镜。
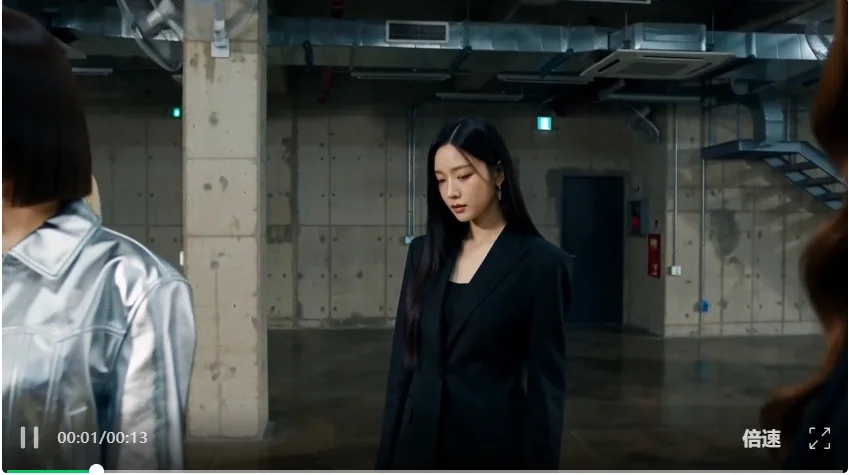
Minimax H3 模型下 Vilot 视频生成(13s)
🚥 十字路口
Vilot 是怎么把视频生成的成本击穿的?
👦🏻 王冠博
我们没有拿缩水的模型凑数,而是优化完整模型运行时的计算、存储和硬件调度,让它在更经济的设备上获得可用的性能。
以我们内部采用的测试口径为例。过去运行某类完整视频模型,可能需要四张A100显卡,或者调用云端模型,生成10秒视频的估算成本约为5元;经过适配后,在单张RTX 4090上完成相应任务,10秒视频估算成本可以降至约两毛。
底层原理具有一定共通性:无论语言模型还是视频生成模型,都涉及算子执行、内存调度和芯片适配。
我们长期投入的是模型与硬件之间这一层,因此新模型出现后,可以在已有系统上做针对性适配,而不必每次都从头建立一套运行体系。
🚥 十字路口
内测阶段,Vilot 的反馈怎么样?
👦🏻 王冠博
内测反馈非常好,有不少人追着问什么时候能买。我们最近开始启动推广。
视频工作站Vilot 的典型用户有两类:
一类是做短剧生成 pipeline 的团队。自己搭流程、调云端 API,看到本地效果后,第一反应是想把生成这一段交给我们,工作站或者更有性价比的 API 都行;
另一类是个人创作者、AI 博主和小工作室,每天生成量大,对单次成本最敏感。
需求是真实存在的。我们了解到,同类的漫剧工作站一体机一个月已经卖出去几千台,同样的生成效果,我们需要的算力要少得多,成本大幅降低,生成速度提升数倍。
斩杀线是“地狱”,也可以是低垂的果实
🚥 十字路口
你们什么时候开始bet端侧?当时行业的热度是什么?
👦🏻 王冠博
是在2025 年初,比公司注册还早大半年。
那时候端侧一点都不热。很多人认为,云端模型的能力都还没有充分释放,端侧还想替云端分担负载,听起来有些不切实际。说到端侧,大家想到的多是“隐私”“小模型”,默认它是笨一点的备选。
我敢下注,是因为我一直在这条线上。
本科那会儿还没有“大模型”这个词,我做的是边缘计算、边缘智能;后来去 Kimi 做 Infra,把模型和系统两头接上,也接触了各家模型和硬件团队,对推理需求怎么往上涨,有很直接的体感。这就是我的确定性信号。
基于这个体感,我们做了两个预判:
第一,“Token越便宜,Token就越贵”,也就是杰文斯悖论。今年是龙虾、agent 引爆token,下一个可能是 multiagent、personal agent、AI App 等等,云端算力迟早不够用;
第二,Token 一旦爆炸,最先爆的一定是内存。
顺着推下去:端侧要接住 Agent,就得跑大模型,因为 Agent 靠的是泛化能力,小模型给不了;模型变大的速度一定快过硬件产能,光靠堆内存解决不了,只能让多级存储一起参与推理。
这几步在当时都不是共识。
今年“龙虾”这类 Agent 爆火以后,4B、7B 的端侧模型就很少有人提了,27/35B 成了默认的起点。
🚥 十字路口
过去几个月,外界有哪些令你兴奋的事增强了当初的判断?
👦🏻 王冠博
最兴奋的有两件事:Kimi K3 的爆发,以及前段时间我们第一次在本地跑出能直接用的视频。
先说模型。
过去一年,模型能力密度提升得非常快。过去需要数百B参数模型才能完成的任务,如今可能只需要几十B参数规模的模型就能实现。开源生态的发展,也让更多高能力模型不再局限于少数厂商手中。
这背后有一个非常重要的变化:用户真正需要的,并不是参数规模最大、价格最高的模型,而是一个能够把事情办成的模型。
我一直在思考一个问题:一个模型究竟需要达到什么能力水平,才能真正成为普通用户愿意持续使用的生产力工具?
只要越过这条实用性的“斩杀线”,即使端侧模型的能力比云端最前沿模型慢一代,也完全可能满足大量日常任务的需求。到了这个阶段,用户考虑的就不再只是模型有多强,而是它是否足够便宜、方便、稳定。
所以我常说,“斩杀线”对云端模型厂商可能是挑战,但对端侧而言,却可能是低垂的果实。
视频是另一种兴奋。本地 Agent 还需要教育用户,视频的效果却一眼就看得懂。那是我第一次看到端侧在真实的生产场景里能平替云端,有点 aha moment。
🚥 十字路口
用户体感上,你们这套推理引擎性能如何?
👦🏻 王冠博
用户最直接的感受是,过去需要GPU、大内存才能运行的大模型,现在不需要GPU也能跑得动、响应快,而且不牺牲模型原始精度。
这两组数字可以说明。
第一,我们在约 3-5GB 内存占用下跑 35B 模型,在对应测试里保持了推理速度和模型原始精度。
35B 差不多是端侧干正经活的起点,常规部署光放权重就要十几到几十 GB 内存;压到 3-5GB 左右,一台普通配置的设备也能一边跑模型,一边干别的。
第二,Prefill达到3000 tokens/s。
Prefill 是模型读你给它的材料的阶段,按这个速度,两万 token 的资料七秒左右就能读完、开始回答。很多人只看模型往外蹦字有多快,其实前面这段等待更影响体验。
🚥 十字路口
聊聊你们的团队情况?
👦🏻 王冠博
我们是一支很年轻的团队,00 后为主。但我们做底层的时间,比公司的年龄长得多。
我本科就开始做边缘计算、端侧系统;后来在 Kimi、阿里做 Infra,把模型训练、推理和系统接到一起;中间还做过一段具身方向的创业。前面那段让我懂模型怎么跑,后面那段让我开始理解商业的逻辑。
我们团队的核心能力在模型、系统、算子和芯片适配上,相关积累已经有四五年。
我们很多同事都在所谓的“大机构/大厂”待过,祛魅之后,反而更清楚自己要什么。我在大厂做 Infra,看到的是再大的公司,资源也会先投给共识:更大的集群,更大的模型,能写进下个季度目标的项目。我们 CMO 此前做投资,看到的是另一面:钱跟着热点走,共识形成的巨快。两边看下来,我们的结论几乎一样:大厂擅长把共识做大,却很少愿意为一个非共识押上几年。端侧推理就是这样一个非共识,那就我们自己来押。
后来,有些公司先是跟我们对接业务、深入合作,合作做下来,陆续有人选择跳过来加入,其中不乏行业老炮。我印象最深的,某天半夜三点半,突然在某书上收到了一个私信,来自某大厂的技术骨干,篇幅很长也非常真诚,希望有机会可以一起创业,我刚好也没睡,一聊发现在端侧非常共频,隔天我就飞到他那里,他后来直接裸辞加入了我们。
我们内部有句三字箴言叫“肝、敢、干”:愿意投入,敢下判断,干到底。
我不太喜欢“小天才”那种讲法,很多 PR 稿会先造一个神。人和人的水平当然有差异,但没有大到一个是神、一个不行。我觉得更关键的是,你能不能提前看到一件事,而它又恰好是你擅长的。
00 后学生团队,一个月拿下千万级订单
🚥 十字路口
万格为什么从 To B 转到做 To C ?
👦🏻 王冠博
其实不是转型。C 端从一开始就是目标,B 端是我们选的起点。
我们始终认为,端侧AI最终应该服务于每一个普通用户,让更多人能够以合理的成本获得持续可用的智能能力。
但对于一家初创公司来说,直接进入消费硬件市场并不容易。用户需求是否真实、供应链能否建立、现金流能否支撑持续研发,这些都是必须面对的问题。
B 端业务恰好帮助我们逐步验证了这三个方面。大客户有明确的设备、预算和验收标准,技术行不行很快就知道;合作打开了供应链,更多 ODM 看到了我们,愿意一起做产品;交付、回款,又带来了现金流和背书。
TokenWiFi 这个想法,就是在 B 端交付里冒出来的。
我们发现,很多人买很贵的 AI PC、AI NAS,本质上是为里面那份 AI 能力,付了一整台设备的钱。当时我们就想,能不能把这份能力单独拿出来,让用户已有的设备直接连上。
🚥 十字路口
目前的营收情况是怎样的?
👦🏻 王冠博
公司成立一年即实现盈利。
我们是一支 00 后学生团队,创业初期没有现成的大客户资源,主要依靠技术能力打开市场。
一个月拿下头部大客户的千万级订单,三个月完成交付和回款,此后半年持续获得新订单。
客户覆盖头部 PC 厂商和 NAS 厂商,采购的是从模型部署、推理优化到硬件适配的一整套解决方案。
目前,我们已经与多家上市公司达成战略合作。
🚥 十字路口
你提到,生态比性能更重要。现在万格有哪些生态伙伴?
👦🏻 王冠博
我们一直认为,性能是产品进入市场的基础,生态是推动技术持续落地和规模化发展的关键。
单一性能指标反映的是某一时点、某一场景下的技术表现,而生态体现的是企业能否持续适配不同芯片平台、跟进模型迭代,并真正进入客户的产品体系。
目前,万格智元已经形成了覆盖上下游的生态链条:
上游,与头部芯片厂商建立适配合作,积累跨平台的底层技术能力;中游,持续跟进主流模型迭代,保持对新模型的快速适配能力;下游,与头部 PC、NAS 等硬件厂商深度合作,推动技术进入真实产品和用户场景。
这套生态的价值在于,它不是一次性的技术合作,而是能够伴随客户的硬件迭代、模型升级和应用场景拓展,持续提供推理优化与适配服务。
🚥 十字路口
最新一轮融资什么时候close的?
👦🏻 王冠博
今年我们连续完成了三轮融资,本轮资方有头部基金,也有相关上市公司的产业资本,累计金额近亿元。
投资人来看我们的时候,看到的是一门已经有订单、有回款的生意,不只是一份商业计划书。
产业方里,也有一些先在业务上合作、后来成为股东的伙伴。
对一家要做消费硬件的公司来说,这类资本的价值不只在钱,硬件、供应链、渠道,每一环都需要有人一起扛。融资是加速器,但它替代不了需求验证,也替代不了客户验收。
成立一年以来,我们逐渐感受到,端侧从不温不火,到现在逐渐浮出水面的过程,看到自己的判断在一点一点地变成现实。
慢就是快,道心不能乱
🚥 十字路口
你提到“ AI创业过程中, 越来越感觉到慢就是快”。哪些事是你们选择慢做、反而走得更快的?
👦🏻 王冠博
最典型的一件事:我们没走量化、蒸馏的捷径,花了两年做模型下面那一层。
很多团队的端侧优化做在模型参数上,量化、蒸馏,见效快,但和具体模型强绑定,来一个新模型就得重新量化、重新蒸馏一遍。
我们选了更慢的路,把功夫下在模型架构和芯片算子生态上,很长时间拿不出能炫的东西。
后来就快了。千问 3.6、Kimi K3、DeepSeek V4 出来,我们很快就能支持。今年短剧和视频生成火起来,我们做了一次迁移,发现几乎天然适配,两周就做出了端侧视频生成第一梯队的效果。
外面看到的是两周,看不到的是前面两年。
我有一个很深的感触:创业像修仙,要道心不乱。
做技术需要保持定力,不能因为某个新方向突然火了,就急着推翻过去的积累。
每次出现新技术、新概念,我们都会先问自己:它是真的改变了我们要解决的问题,还是只是换了一种说法?
🚥 十字路口
过去一年里,AI 经历了几波热潮,你们怎么判断什么该坚持、什么该放弃?
👦🏻 王冠博
坚持的是推理系统这条主线,做自己擅长的事情和用户需要的事情。
我们在五道口原点社区,身边具身、Agent、模型的热潮一波接一波,总有人劝我们去做一个更容易讲故事、更容易获得关注的产品。我们没换。
产品上,我们明确不做下一个 Codex 或 WorkBuddy。用户已经把工具用顺了,没必要为了用我们的推理能力,重新搭一遍工作流。我们站在这些工具后面,把复杂性留在产品里,把选择权留给用户。
初创公司的生存之道,藏在用户的身后,不在用户眼前。
长期来看,模型层、基建层大概率会趋同,价值高点在应用,就像今天最赚钱的是字节,不是运营商。衡量 AI 有没有泡沫,就看价值在应用端还是基建端,现阶段讲基建故事的太多了。
我们做底层,目标是让应用长出来。
但值得一提的,热点换了几轮,我们一直在磨自己这套技术;潮水退下去,留下来的真需求,端侧 for Agent、端侧 for 具身、端侧 for RSI,都和我们有千丝万缕的联系,有的已经拿我们当底座。
这也让我越来越觉得,AI创业特别需要“慎独”。
当外部风向不断变化时,你必须清楚自己为什么选择这条路,以及哪些事情值得长期坚持。
文章来自于"十字路口Crossing",作者 "壹小姐"。
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0