近日,Milvus 3.0 正式接入英特尔 SVS Vamana 内存图索引。
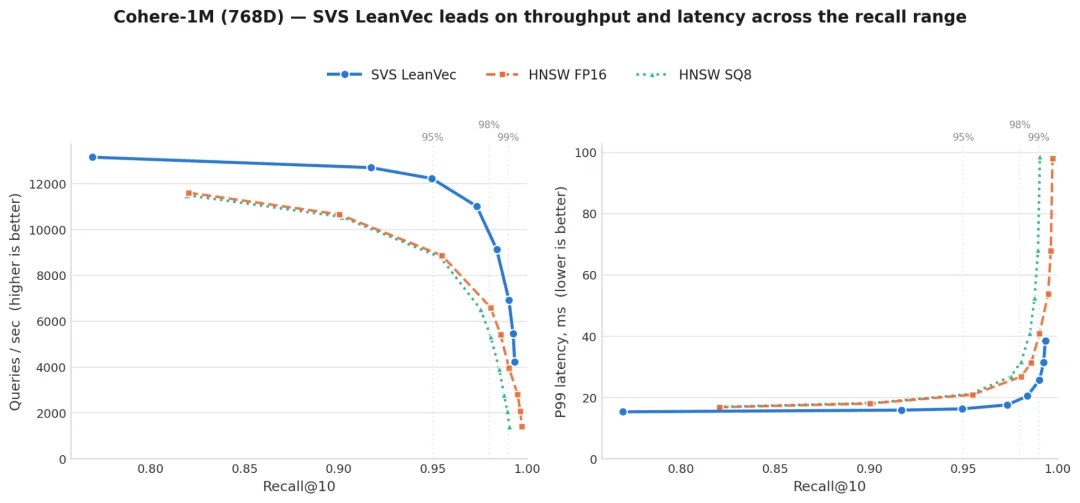
作为基于 Vamana 近邻图实现的检索索引,SVS Vamana 原生支持 LeanVec 向量降维与量化。启用 LeanVec 时,它的召回 - 性能曲线全面优于 HNSW SQ8、HNSW FP16,同一召回率条件下吞吐量更高、延迟更低。
对于正在用 HNSW并且计划做切换的团队来说,这套方案同时兼顾高召回与低内存成本两大优势。
以下是关于 SVS Vamana 的介绍与测评结果。
01
在HNSW上提升召回,为什么会导致代价陡增
RAG、图像检索、推荐这类业务,往往对延迟上限以及Top K召回率都有着很高的要求,HNSW 也因此成为行业主流选择。
但相应的,我们为此需要付出的代价则是:向量本体 + 图邻接信息全部驻留内存,数据量扩容、副本加多,资源开销跟着线性上涨。
因此,在实际部署中,通常有两种方式来平衡精度和内存。
一种是 SQ8 标量量化,每维压缩到 8 bit。Milvus 里 FAISS 系列的 HNSW_SQ 就是这个路线,向量存储体积可以降到原始 float32 的 1/4。多数情况下,HNSW SQ8 可以用较低内存稳定跑出约 95% 召回。
另一种是 FP16,每维 16 bit,量化误差更小,更容易实现高召回,但向量存储开销是 SQ8 的两倍。
而要想基于SQ8实现更高召回,只能放大检索遍历范围。检索时扫描更多邻接节点,才有机会找回漏检向量,代价是大量额外距离计算和内存随机访问。因此,在召回率要求较高时,这些额外开销可能让吞吐量明显下降,尾延迟也随之上升。
有时候,召回率从 95% 提高到 99%,看似只增加了四个百分点,系统付出的成本却可能远不止这些。
基于以上问题,SVS LeanVec 的优化在于:它通过量化与降维结合,减少了搜索过程中反复读取和计算的向量数据,同时通过重排序补回压缩损失的精度。
02
LeanVec 如何兼顾压缩和精度
SVS Vamana 使用的 Vamana 图,和 DiskANN 采用的近邻图结构同源。不过,SVS Vamana 图经过剪枝,可以使得搜索能够通过几次长距离跳跃“跳”向查询目标,使查询能够较快地接近目标向量。
在此基础上,LeanVec 则负责降低沿图搜索的开销。它为每个向量保存主向量与辅助向量两种表示,分别用于搜索和重排序。
用于搜索的主向量先经过线性投影降维(二分之一、四分之一、六分之一,或者任何你配置的值),再进行LVQ量化。图的构建和遍历都基于这一表示,大部分距离计算不再需要处理完整维度的向量。
重排序用的辅助向量,则在量化后保留完整维度。检索环节拿到候选集之后,系统使用它对候选结果重新计算距离,减少降维对最终结果的影响。
检索时,以 OpenAI 1536 维向量数据集举例:主向量会降到 256 维、4bit 量化,图遍历全程在这个更小的空间里执行;只有最后一小批候选,才会调用 1536 维、8bit 的辅助向量重排。
相比之下,HNSW SQ8 虽然也压缩了每个维度,但每访问一个节点,仍要读取并计算完整维度的向量。LeanVec 进一步减少了遍历阶段的数据量,因此在高维数据上更容易体现收益。
03
召回从 95% 到 99%,查询性能差多少
我们在四组数据集与规模组合下,将 SVS LeanVec(采用 LeanVec4x8 存储:主向量 4 bit、辅助向量 8 bit,分别测试开启 / 关闭 OOD、多组检索窗口大小)与 Milvus 中基于 Faiss 的 HNSW_SQ 索引(包含 FP16 和 SQ8 标量量化两种存储模式)做对比:
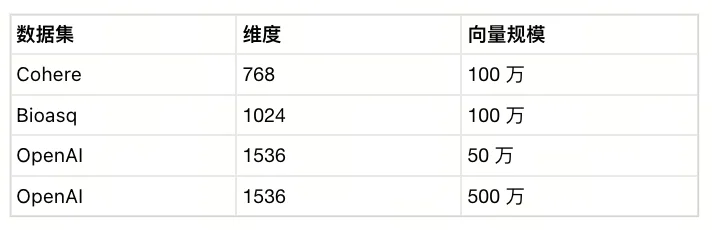
针对每一份数据集,我们遍历各索引的检索参数,采集不同召回率下的指标,绘制完整召回率 - QPS 曲线,分别在 k=10、k=100 两种返回条数下测试。固定并发为 100 个客户端线程,观测索引加载耗时、每秒查询数(QPS)以及 P99 延迟。
注:投影的训练方式也会影响性能。LeanVec 默认采用 OOD(分布外)模式,为底库向量和查询向量分别学习投影;ID(分布内)模式则使用共享投影,索引构建更快。
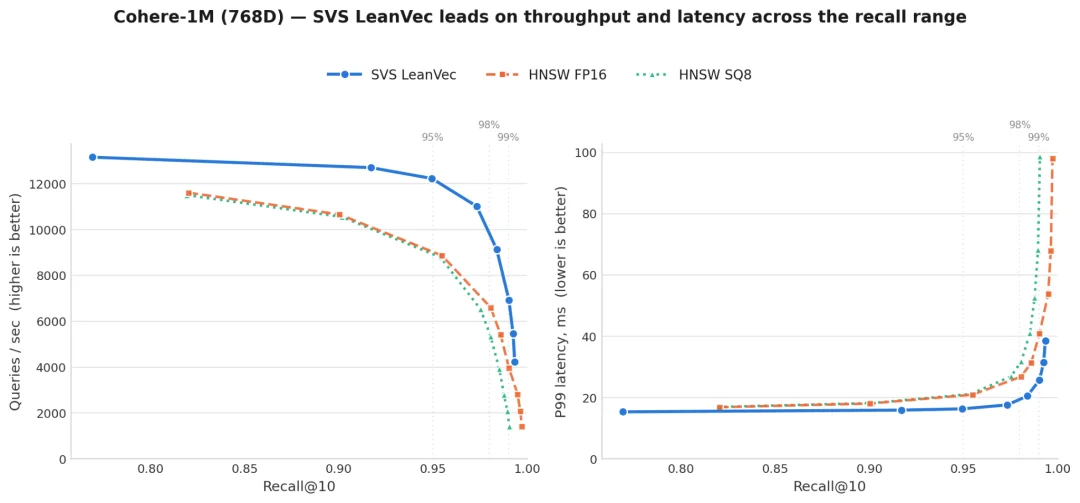
先看 95% 召回率:
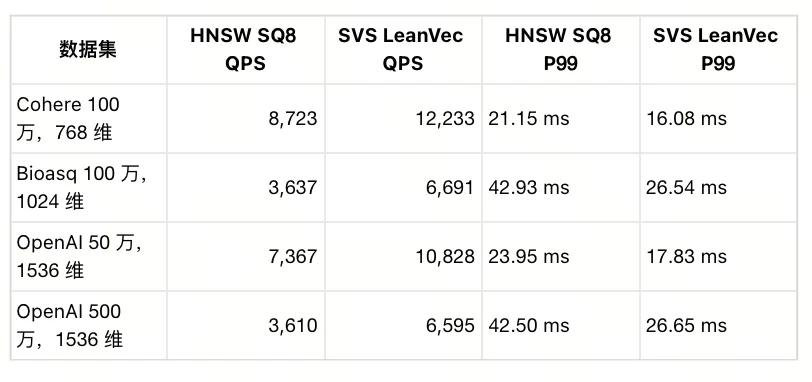
四组数据中,SVS LeanVec 在每个数据集上都胜过了 HNSW FP16之外,SVS LeanVec 的吞吐量达到 HNSW SQ8 的1.40~1.84 倍,P99 延迟降低24%~38%。在此基础上,更高维度和更大规模的数据集(Bioasq 1024D、OpenAI 5M)上收益最大。
继续提高召回率到99%,HNSW SQ8 需要明显增加搜索开销,SVS的优势也会越来越明显。在Cohere 100 万数据集中,这种对比差异非常典型:
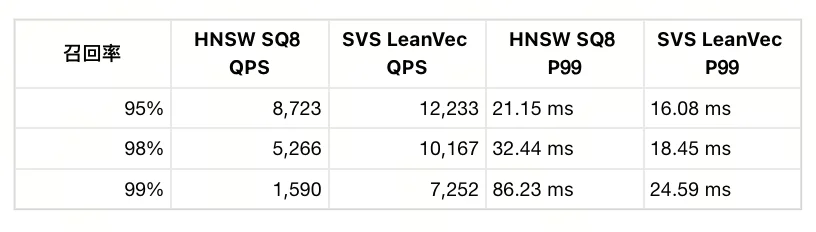
达到 99% 召回率时,HNSW SQ8 的吞吐量只剩 95% 时的约五分之一,P99 延迟超过原来的四倍。SVS LeanVec 的性能也有下降,但仍保持了 7,252 QPS,约为 HNSW SQ8 的4.6 倍。
同样的结论也适用于参与本次测试的更多其他数据集,并且在数据总量越大、维度更高的数据集种,表现会更为明显。可以看到,在本文使用的搜索设置下,HNSW SQ8 的吞吐量在接近召回率范围上限时急剧下降,在 OpenAI-500K、OpenAI-5M 和 Bioasq 数据集上甚至低于最高目标值。
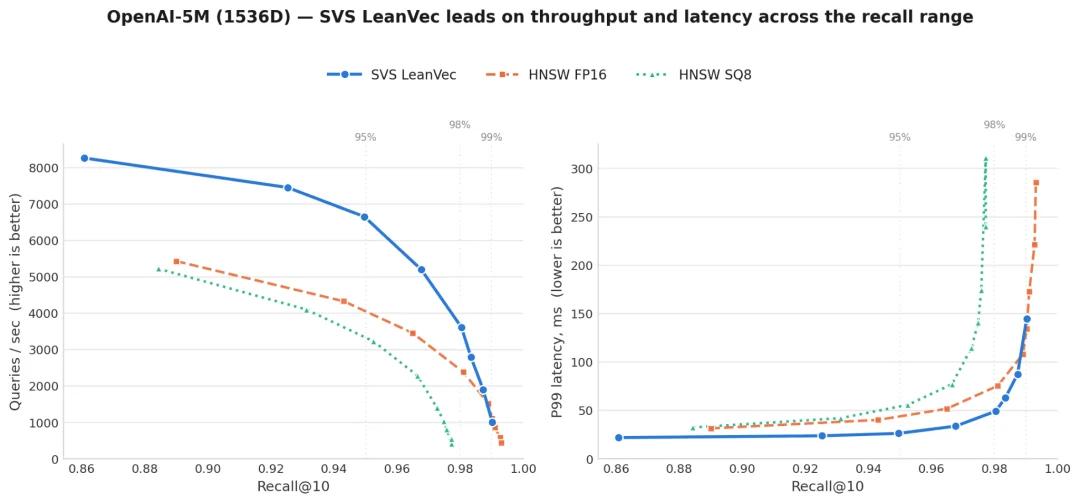
改用 FP16 后,HNSW 的高召回率表现有所改善,但多数测试结果仍落后于 SVS LeanVec。
总的来说,99% 召回率下,Cohere 100 万的 QPS 分别为 4,873 和 7,252,SVS 高出约 49%;OpenAI 50 万则分别为 3,868 和 4,523,SVS 的 P99 延迟也更低。只有OpenAI 500 万是一个例外。在 99% 召回率下,HNSW FP16 达到 1,186 QPS、114.28 ms P99,SVS LeanVec 为 1,011 QPS、131.44 ms P99。
此外,还值得一提的是Bioasq 数据集,本次配置下,包括 HNSW FP16 在内,没有索引达到 99% 召回率;在能够达到的范围内,而SVS LeanVec 的吞吐量仍然领先。
要注意,这里的性能优势,是 Vamana 图结构、LeanVec 两级压缩、后置重排以及底层实现共同作用的结果,不是单一优化点带来的收益。
04
查询更快之外,还能省多少内存
速度只是性能的一面,另一面是维持该性能所需付出的资源成本。正如前文所说,内存是向量检索里最主要的开销项。我们可以先简单理解单向量内存占用(向量维度为 d):HNSW FP16 约占用 2・d 字节,HNSW SQ8 约为 d 字节,LeanVec4x8 约为 d/4 + d 字节。
由此不难看出,SVS 的内存占用会远低于 FP16,和 SQ8 接近。
除此之外,所有图索引都要存储每个节点的邻接列表(大约为:出度 × 4 字节 / 节点,Vamana 的度数,或是 HNSW 的 2・M),这部分开销和向量维度无关,在低维场景下影响更明显,高维、M 取值不大时占比会下降。
下面是实测数据:索引加载完成、对外提供查询时的常驻内存(Milvus vector_index 指标,不含 QueryNode 进程整体内存):
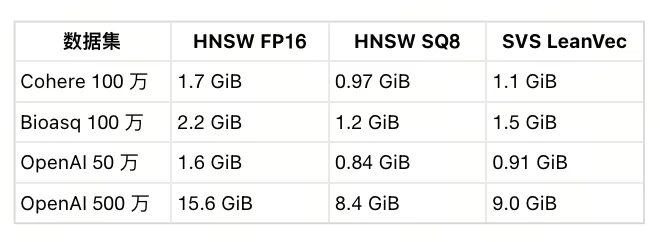
测试环境说明:SVS 配置为LeanVec4x8;Cohere、OpenAI 降维至 256 维,Bioasq 降维至 512 维。
补充说明:索引载入 QueryNode 的过程中,瞬时内存会高于稳态常驻值。但三类索引的这部分额外开销比例相近,因此对比结论不变:SVS LeanVec 的加载峰值内存始终低于 HNSW FP16,延续了稳态下的内存优势。
最终,在全部数据集上,SVS LeanVec 的内存占用接近 SQ8,只有 FP16 的57%~68%。同时在各个召回率水平上,吞吐量都能持平甚至优于 FP16,并且和内存最低的 HNSW SQ8 处于同一量级(差距仅 10%–20%)。这意味着,在多数测试场景中,它用更少内存获得了更高吞吐量。
用吞吐量除以索引内存,就能直观看到这份内存资源带来的价值:每 GiB 索引内存可承载的 QPS,数值越高代表资源越划算。下面是 99% 召回率下的结果,高召回场景里内存与性能的差距会被进一步放大:
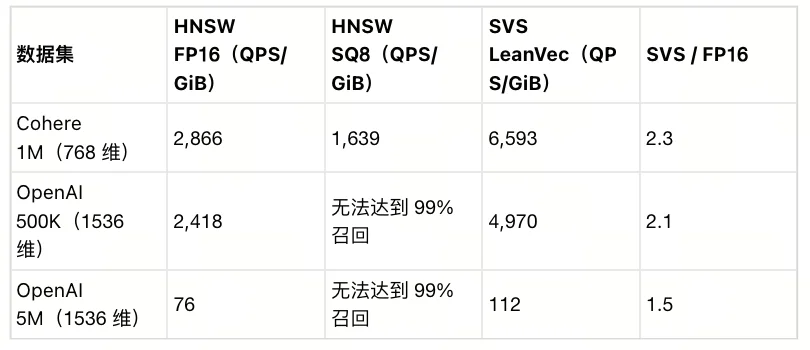
计算方式:QPS/GiB =(并发 100、99% 召回下的 QPS)÷ 索引常驻内存(GiB)。本表不含 Bioasq,该数据集下所有索引都无法达到 99% 召回;两组 OpenAI 数据集上,SQ8 均无法抵达 99% 召回。
可以看到,99% 召回率下,SVS LeanVec 每 GiB 内存的吞吐量是 HNSW FP16 的 1.5–2.3 倍。即使在 FP16 查询更快的 OpenAI 500 万数据上,SVS 也只需要 9.0 GiB 索引内存,而 FP16 需要 15.6 GiB。
内存、性价比之外,建索引耗时也需要一并考虑。关闭 OOD、使用 ID 模式时,SVS LeanVec 在四组数据上的构建与加载总时间比 HNSW FP16 缩短了22%~39%。启用 OOD 后,Cohere 和两组 OpenAI 数据的耗时与 FP16 接近,Bioasq 则从 791 秒增加到 1,532 秒。
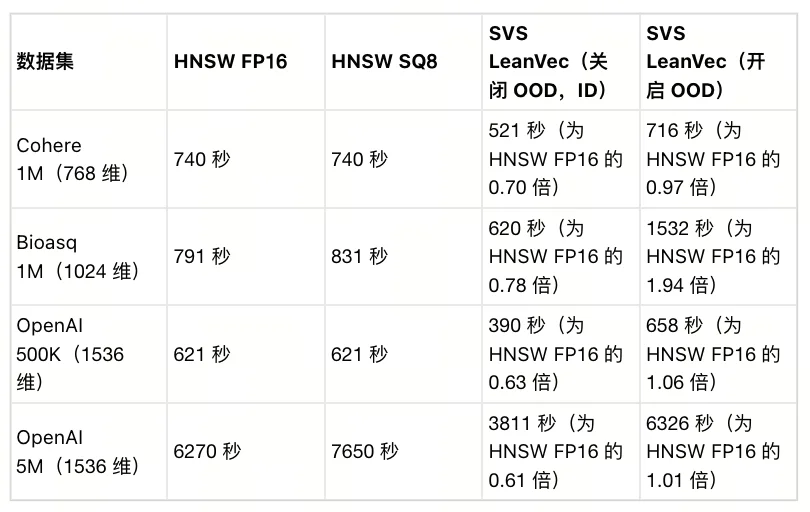
因此,召回率目标在 95% 左右、又比较重视构建速度时,可以先尝试 ID;更在意高召回率下的查询吞吐量时,再比较 OOD 带来的收益是否值得额外构建时间。
05
如何在 Milvus 中使用 SVS Vamana
要使用SVS Vamana ,可以通过 Milvus 的 FAISS 接口配置:index_type 设为 FAISS,再用 faiss_index_name 指定 Vamana 图和向量存储方式。目前需要 Milvus、PyMilvus 3.0.0 或更高版本,并在源码构建时启用 SVS;默认构建不包含这一支持。
make USE_SVS=ON
假设已经创建 collection,并定义了向量字段,可以这样配置索引:
from pymilvus import MilvusClient
client = MilvusClient(uri="http://localhost:19530")
collection_name = "your_collection_name"
index_params = client.prepare_index_params()
index_params.add_index(
field_name="your_vector_field_name",
index_type="FAISS",
index_name="vector_index",
metric_type="COSINE",
params={
# 图最大度数为 64;主向量 4 位,辅助向量 8 位
# 主向量降至 256 维
"faiss_index_name": "SVSVamana64,LeanVec4x8_256",
"construction_window_size": 200,
"ood_training": True,
},
)
client.create_index(
collection_name=collection_name,
index_params=index_params,
)
client.load_collection(collection_name=collection_name)
_256 代表降维后的维度;省略这一后缀时,默认降至原始维度的一半。将 ood_training 设为 False,即可使用构建更快的 ID 模式。
搜索阶段通过 search_window_size 调整搜索范围,作用类似于 HNSW 的 ef。search_buffer_capacity 需要大于或等于它:
search_params = {
"params": {
"search_window_size": 100,
"search_buffer_capacity": 100,
}
}
初次测试可以从 LeanVec4x8 开始。高召回率下查询开销较大时,尝试提高主向量维度;希望进一步减少内存时,则可以降低维度,或改用辅助向量为 4 位的 LeanVec4x4。
另外,LVQ、LeanVec 压缩依赖 Intel CPU,AVX-512 环境收益最优。非 Intel 平台依然可以跑 SVS Vamana,但建议选用 FP32/FP16 / 普通 SQ8 存储。
06
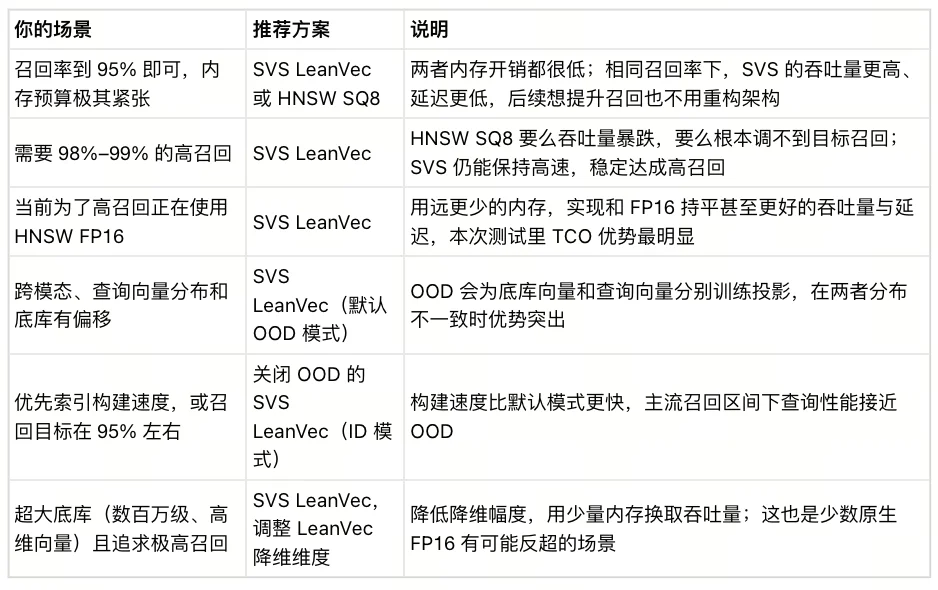
选型建议
感谢 Intel 的 Andreas Huber、Dmitry Razdoburdin、Ethan Glaser、Igor Konopko、Rafik Saliev、Yue Jiao,Zilliz 的 Li Liu、Alexandr Guzhva,以及参与 SVS 集成与验证的 Knowhere 和 Milvus 团队。
注:本文来自Intel团队投稿,内容仅代表作者个人观点,不代表Milvus团队立场。
文章来自于“Zilliz",作者 "英特尔团队"。
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI