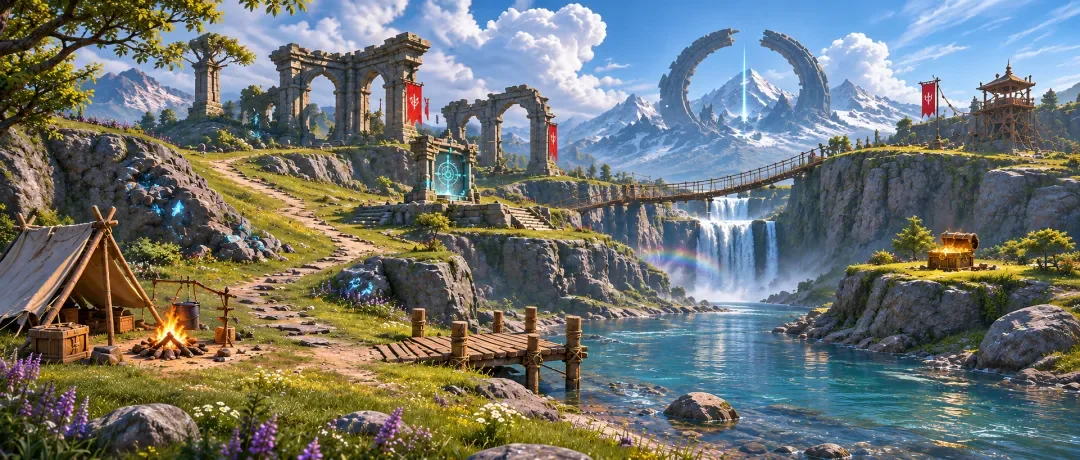
零基础打造交互式3D场景。
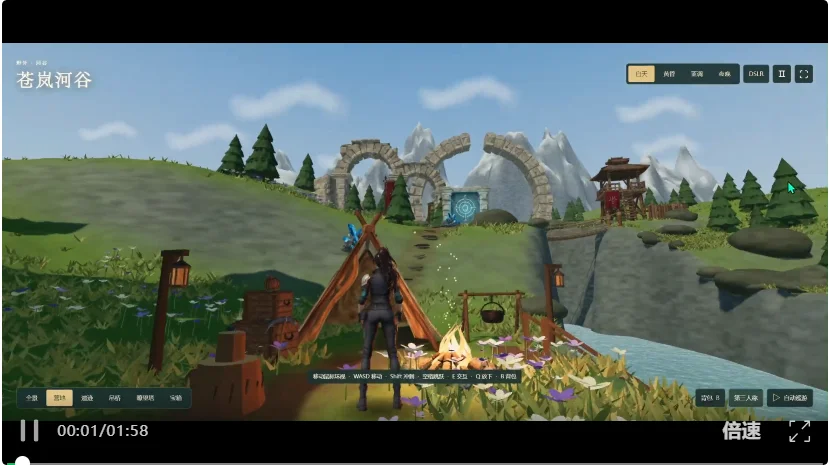
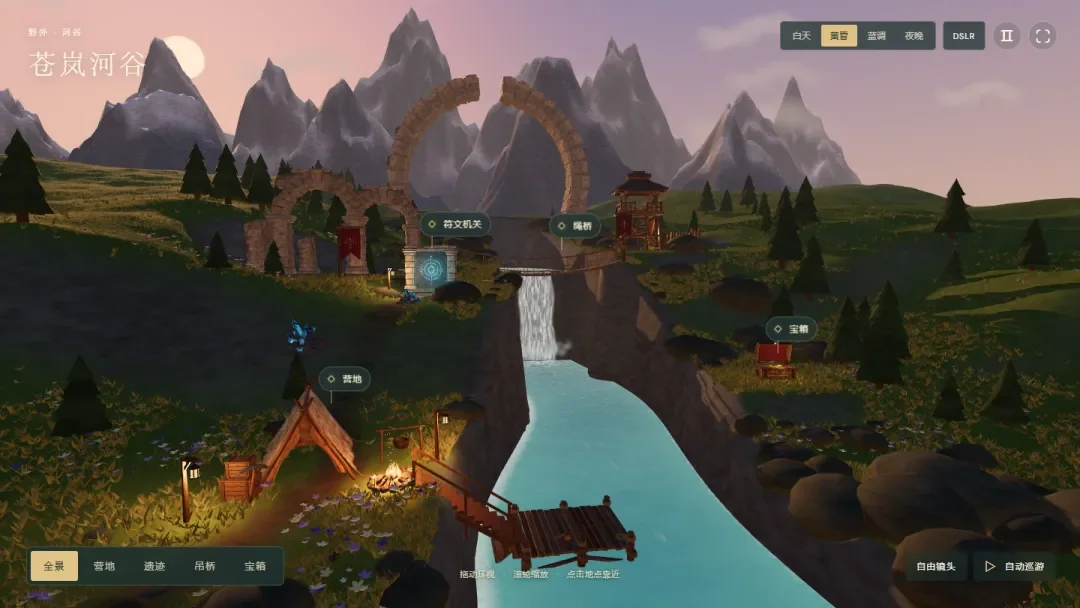
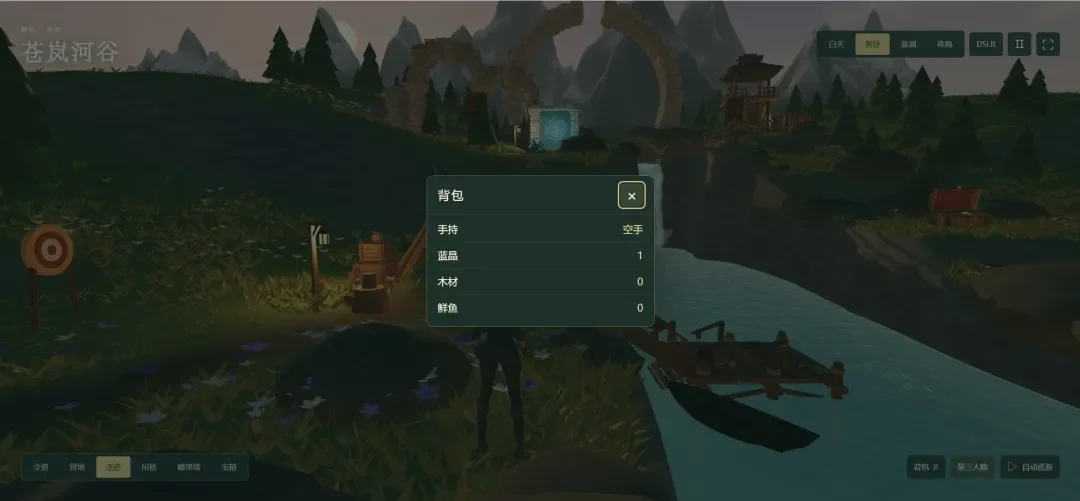
这个3D世界,就是这次用Codex和Blender折腾出来的,现在整个场景可以在本地浏览器里打开,人物也能进去探索。
跑步、跳跃,走到码头开船,拿矿镐采集矿石,或者在河边钓鱼...而这里面大部分工作都交给了AI。
小编只需要负责提供参考图、提出要求以及检查效果,像建模脚本、网页代码以及后续修改主要由AI完成。
先说一说工具,这次用到的有Codex、Blender和Three.js。
Codex负责写代码和调度操作,Blender负责制作与导出模型,Three.js让这些模型在网页里显示和运动。
当然这里的Codex也可以换成像WorkBuddy这样的Agent去实现,最终效果还是取决于模型。
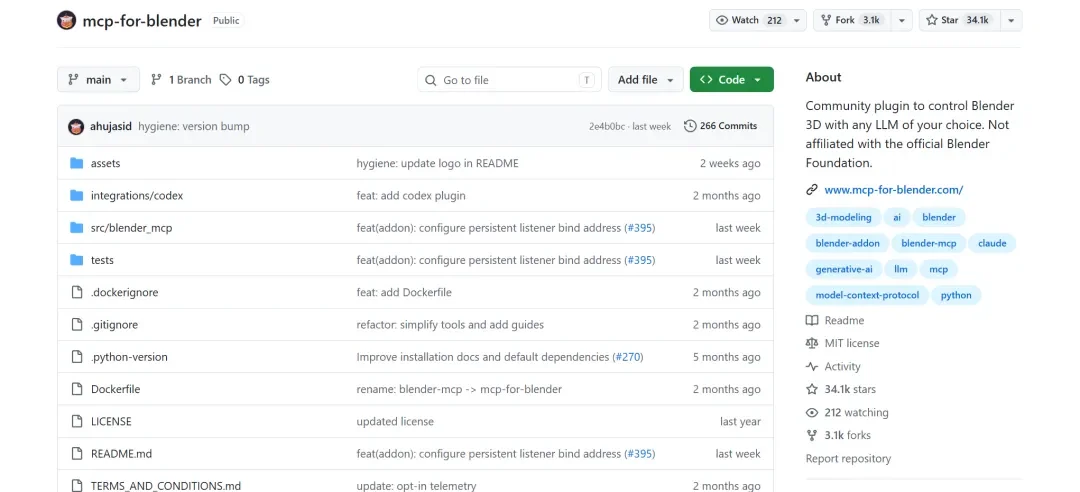
其中Blender在网站免费下载,安装后还需要配置Blender MCP,这样Codex才能查看和操作软件里的物体。
如果是第一次使用,可以参考这个开源项目,把连接丢给Agent安装就行。
装完重启Codex和Blender,并且在Blender的插件设置里确认已启用MCP for Blender。进入3D视图按N,找到MCP面板,没自动连接的话点击启动服务。
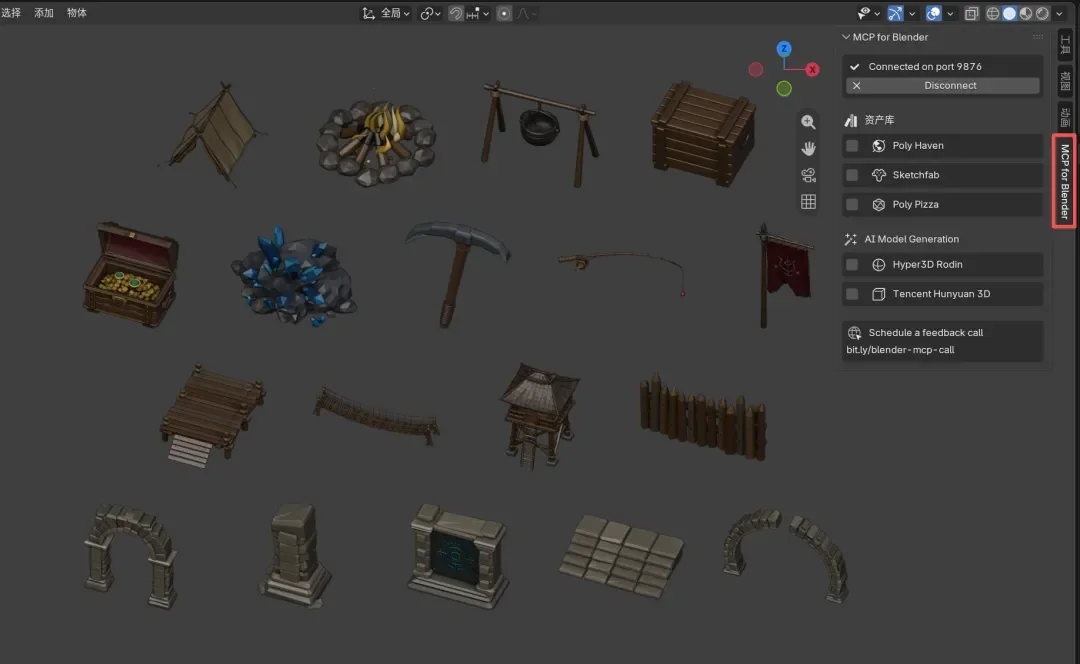
可以测试先让Codex创建一个立方体,换个颜色并保存工程,看到Blender里的物体跟着变化,就说明这一步基本打通了。
接下来正式开工了,把你想构建的场景先通过生图构建,再把参考图发给Codex,让它识别场景里的物体。
这里没有要求一口气还原整张图,因为模型越多,出了问题越难定位。我们先把图里的元素拆开,帐篷、篝火、宝箱、木桥、瞭望塔和石头遗迹都作为独立道具制作。
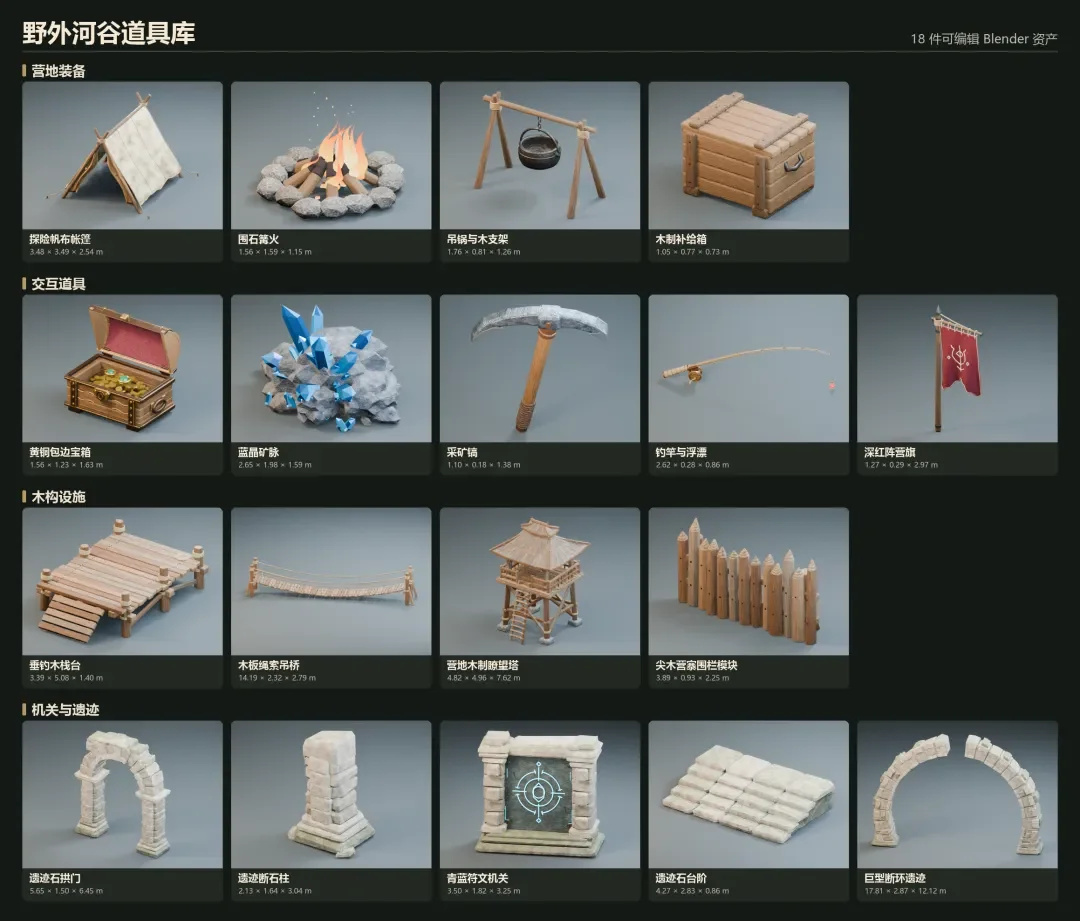
最初一共整理了18件道具,分成营地、交互物品、木构设施和遗迹四组,每件都有自己的尺寸、材质和文件。
给Codex的第一轮要求可以是这样:
分析这张参考图,整理其中需要制作的 3D 道具。先不要搭建完整地形。
按营地物品、建筑设施、可交互道具和装饰遗迹分类,为每件物体确定大致尺寸、朝向和用途。
优先使用 Blender Python 制作结构清楚、方便修改的模型,分别保存,并生成一张道具总览图。
Codex随后调用Blender的Python接口来搭模型。比如木桥,会先生成木桩、横梁和踏板,再按照一条下垂的曲线安排绳索。
宝箱则把箱身和箱盖分开,给盖子保留转轴,这样后面人物开箱时才有东西可以动。
这个过程还遇到了一个小问题。最初Blender的实时连接中断过,小编便让Codex改成编写Python 脚本,再调用本地Blender后台执行。
也就是说,MCP之外还有脚本这种办法,即使连接出了问题,依然可以继续制作道具。
当然,所有东西都让AI用代码建模也没必要。
复杂一点的物体,可以交给AI 3D生成工具。这次小编用的是混元3D,主要考虑到它能提供可下载的模型,方便后续继续处理。
如果更在意造型质量,也可以试试Tripo、Meshy或Hi3D等,不同产品的免费额度和导出条件需要自己确认。
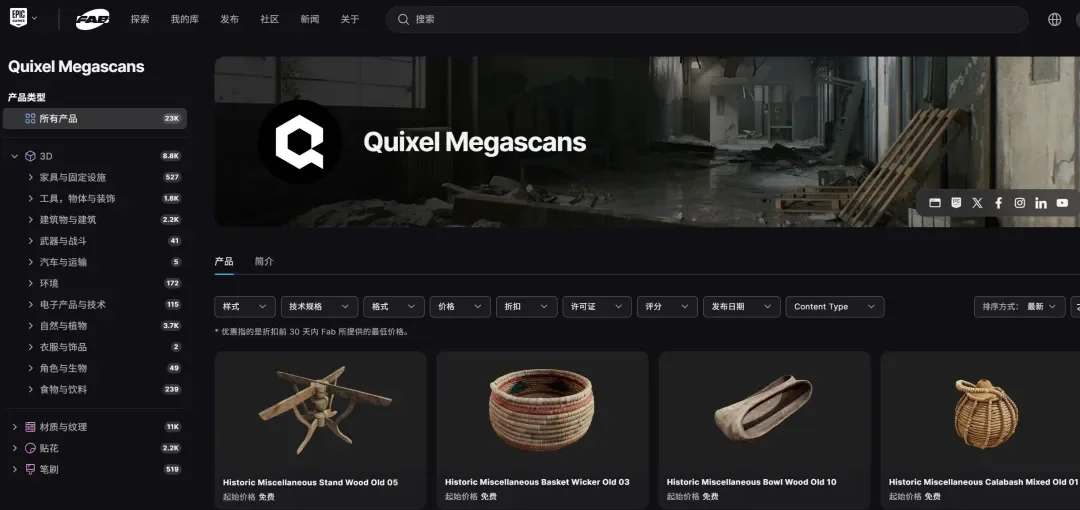
还有一种办法更省事,就是直接找现成模型。
比如Fab的Quixel Megascans素材页,可以搜索石块、木材以及各种环境道具。
这次使用的一条小船、旧葫芦和容器就是外部GLB素材,下载后再交给Codex处理,容器最后还被改成了码头边的鱼篓。
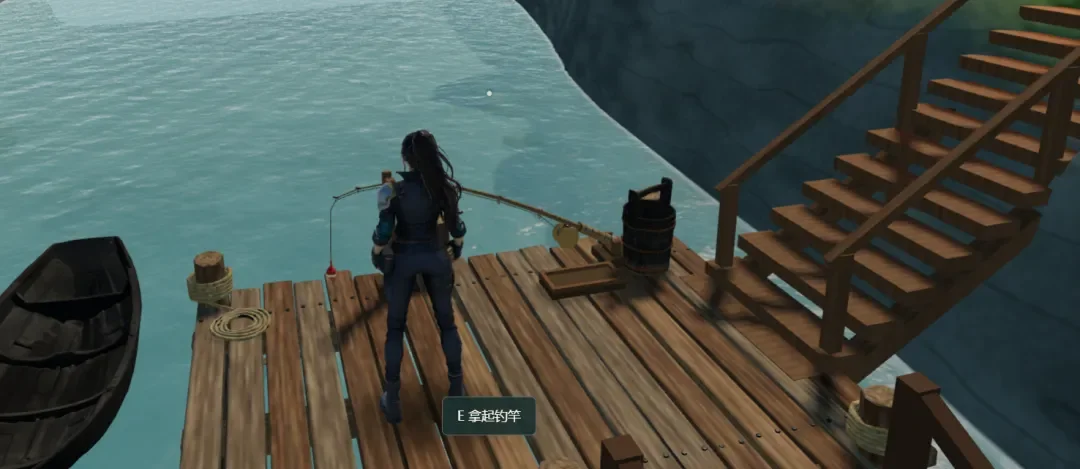
整体体会就是,简单的规则物件交给代码搭建,复杂造型用生成工具,已有的高质量素材拿来调整,省下来的时间更适合打磨整张场景。
不过模型能看,还不代表能直接用。
第一轮检查就发现不少问题,帐篷支架悬空,吊桥的绳子没有接到桥头,宝箱铰链不太对,部分石头也出现了不合理的穿插。
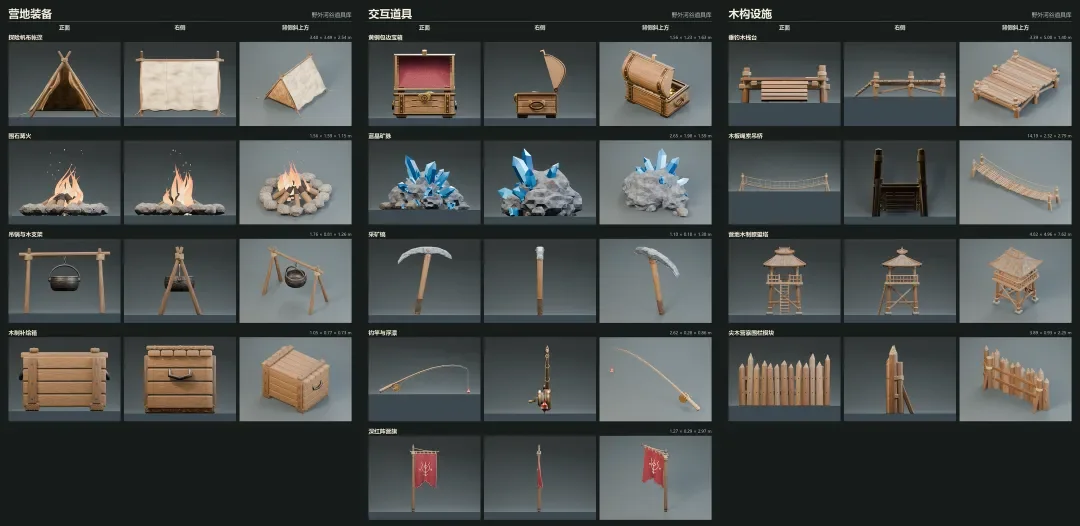
小编让Codex给每件道具渲染正面、侧面和斜后方视图,18件模型一共拍了54张检查图,再逐个返修:
为每个道具生成正面、侧面、斜后方三张检查图,重点检查悬空、穿模、破面、结构连接和模型原点。
发现问题后只修复对应模型,并在修改后重新渲染。确保宝箱盖能单独旋转,桥梁和建筑的支撑结构完整。
接着就是导出模型。
这里用的是GLB格式,可以把模型与材质打包在一个文件里,后面交给网页读取。
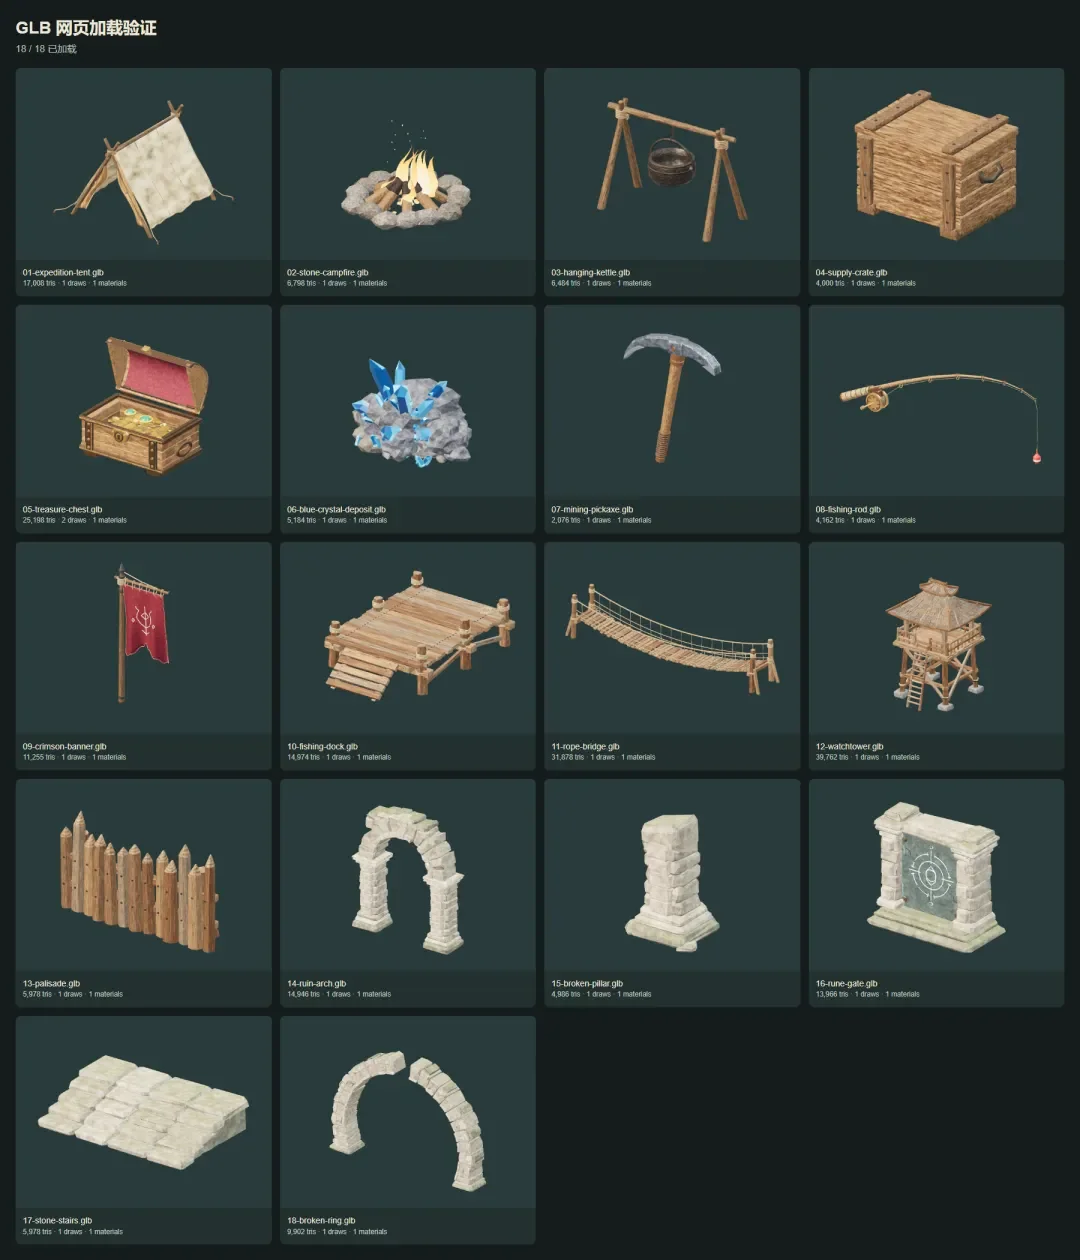
Codex还负责减面、整理贴图和压缩文件,18件自建道具的三角面数量由约46.3万降到22.5万,最终GLB总量约30.2MB。
这个步骤对浏览器能否顺畅加载很重要。道具准备得差不多,就可以让它们出现在同一个空间里了。
小编让Codex新建一个TypeScript网页项目,用Three.js加载GLB,再根据参考图安排地形、河道、道路和模型位置。
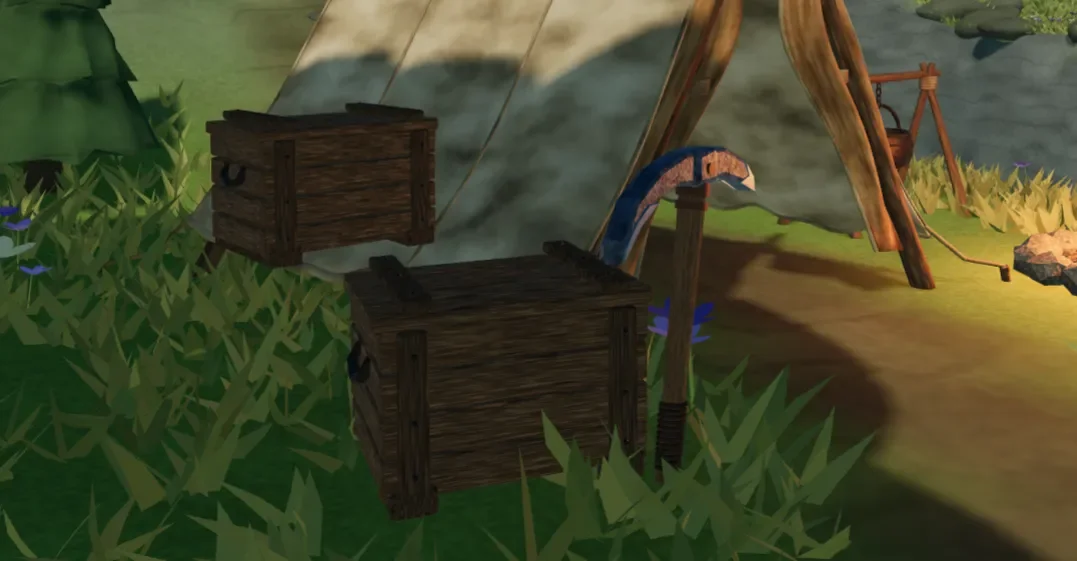
这里最大的麻烦是摆放位置。
有的木箱看着贴地,实际只贴了模型原点,底部还悬在空中,后来改成检查物体真实的边界,再调整高度。
瀑布也是如此,最初水面和岩壁接不上,修改后才让上游水流与瀑布边缘衔接起来。
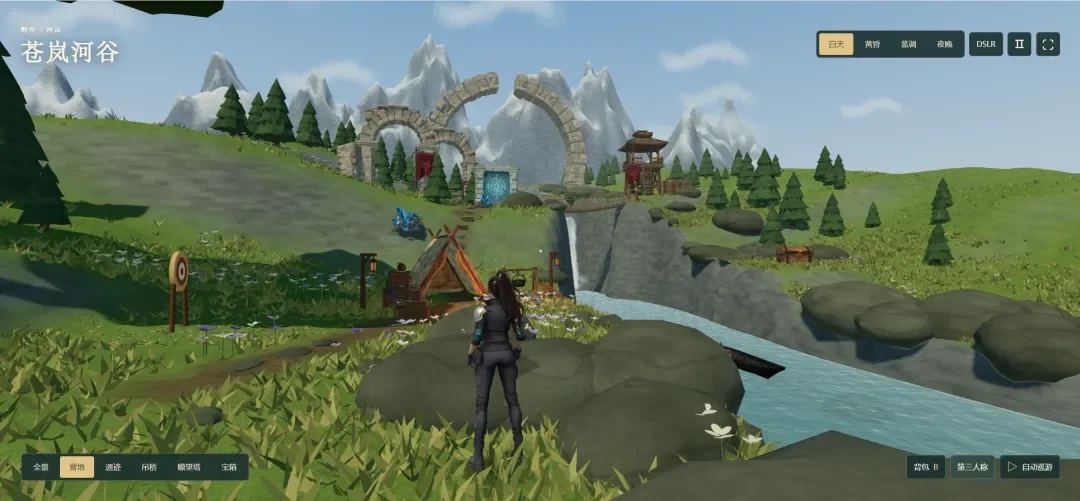
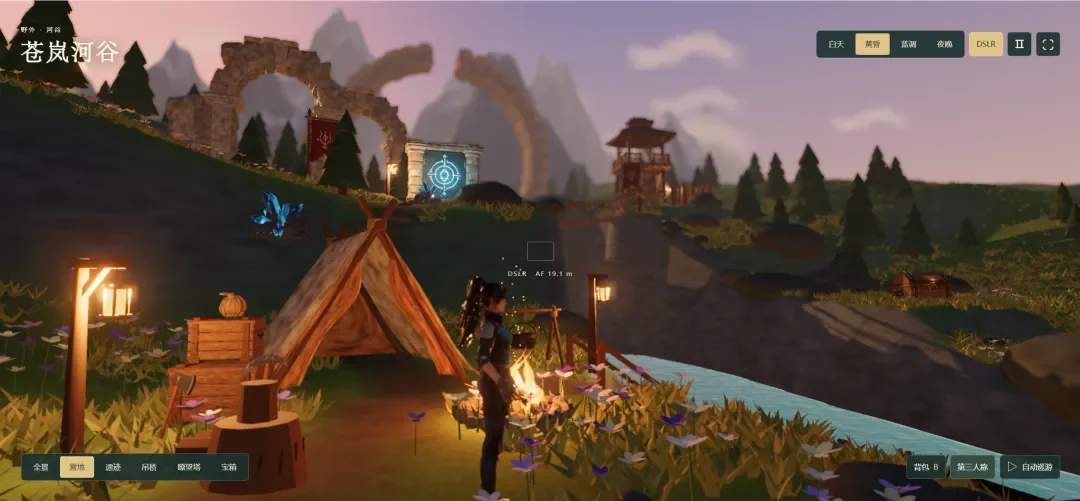
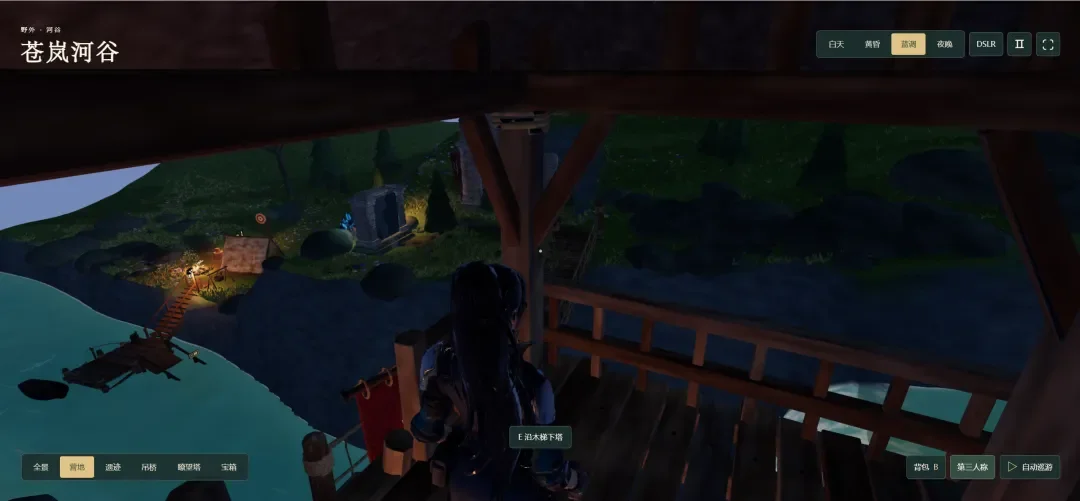
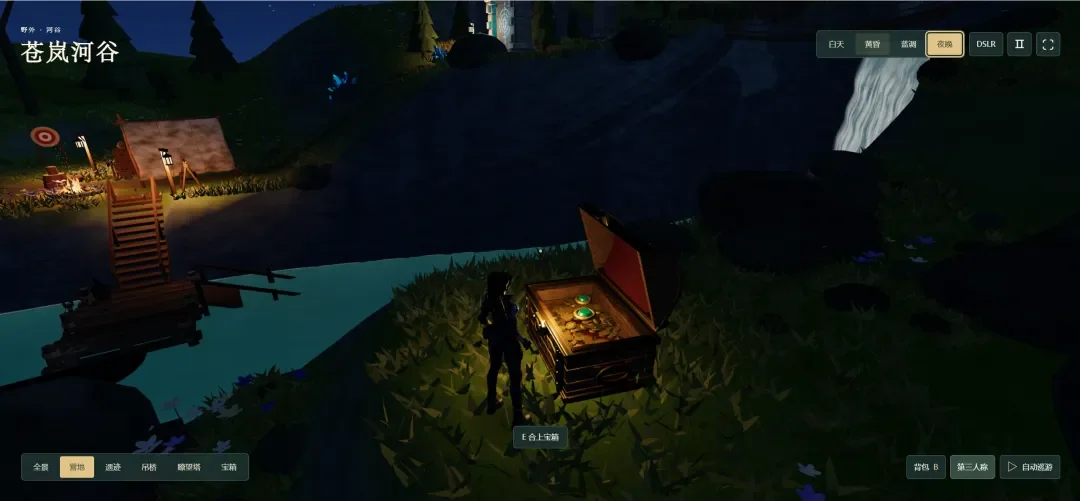
画面搭好后,小编又让Codex加了四套光照:白天能看清楚建筑和道路,黄昏的阳光斜着打进河谷,蓝调时段更适合拍远景,夜晚则会点亮营地灯光。
页面还加入了摄影模式,可以调整景深和辉光,很适合拿来做展示视频。
做到这里,其实已经有一个能旋转、能观看的3D世界了。不过还想通过第三视角亲自走进去看看,于是继续加人物。
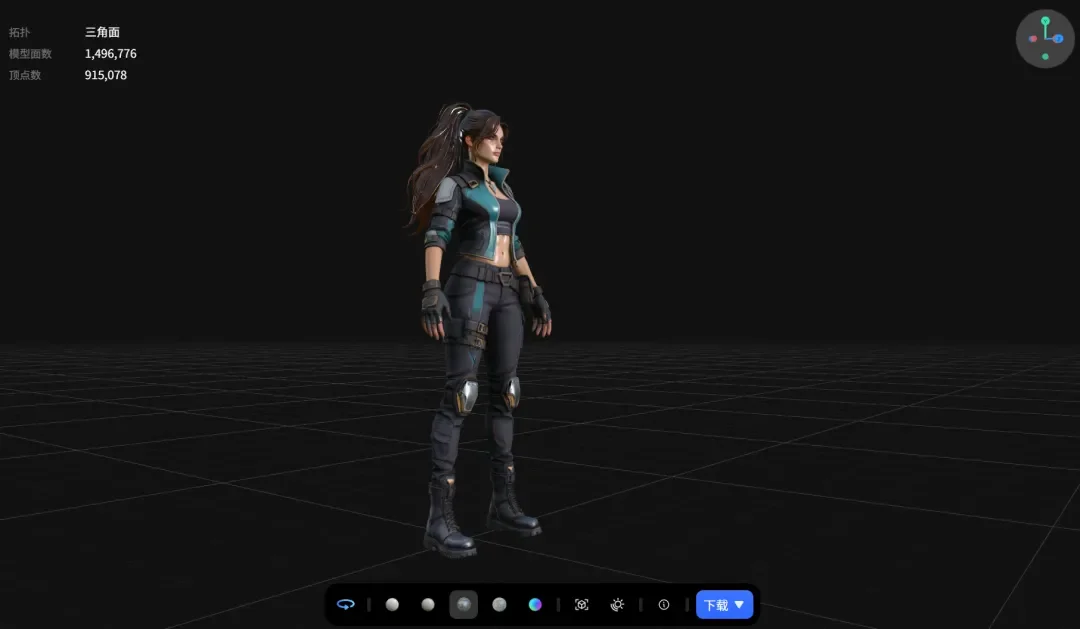
人物模型同样通过GLB导入。麻烦的是,最初拿到的角色只有外观,没有骨骼和动画。
想让她迈腿、抬手、爬梯子,就得先绑定骨骼。
同样丢给Codex,先把原本约86MB的人物模型压缩到约5.3MB,再为人物制作了23根骨骼,接入网页角色系统。
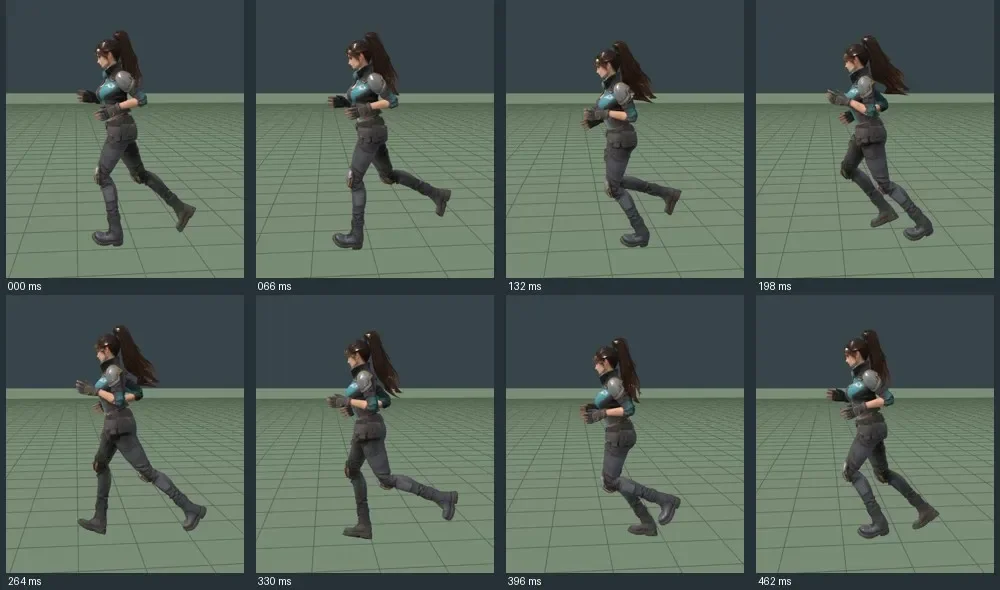
第一次跑起来还有点好笑,人物动作非常僵硬,拿着矿镐时工具又大又别扭,跑步姿势看着像机械狗。
小编便让Codex继续调整手脚关节,并引入CMU的真人动作捕捉数据,处理走路和跑步动作,再让握持姿势跟工具的方向对齐。
有了身体动作,还要让她真的踩在地面上。这里用到了Rapier物理引擎,负责判断人物与坡道、楼梯、码头、船板的接触。
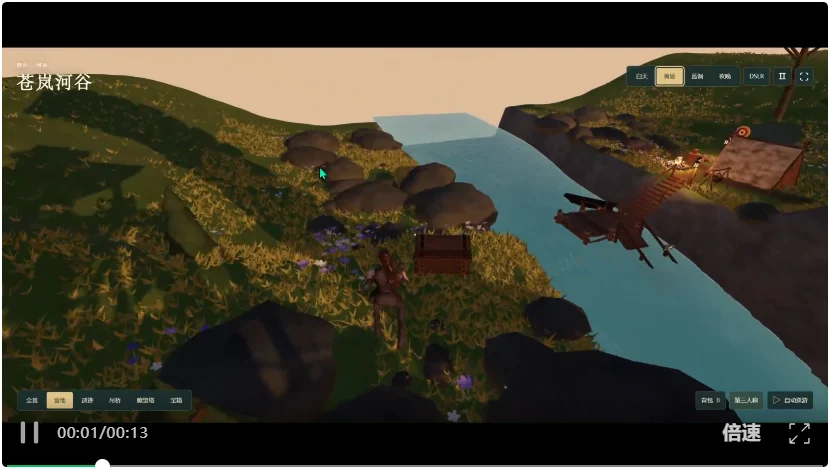
其他交互也是一点点加进去的。
这一步感受最明显的是,视觉效果只是3D场景的起点。当用户可以自由漫游,很多不易察觉的细节问题都会显现。
最后又让Codex专门检查了一轮浏览器适配,调整不同窗口尺寸下的布局,才算把这些细节处理得差不多。
折腾完这些,再看看最近AI搭建3D世界的进展,确实有点夸张。
最近的Anthropic工程师Felix Rieseberg用刚发布的Claude Fable 5.2,花了约8小时生成了一款第一人称射击游戏Saltline。
整个过程只给了一次提示词,中间没有人工反馈,连游戏里的3D模型、贴图和音效都是通过代码生成的。
不过这代价也不低,按照开发者提供的数据,API费用大约为550美元。

虽然现阶段的模型早就能制作3D场景了,但这次更让人感慨的是作品的完成度。通过可以持续编写大量代码,把一个简单的想法做成可以亲自体验的虚拟空间。
语言即世界,听起来有点夸张,但现在已经能看到一些苗头了。
随着模型写代码和理解空间的能力继续提升,未来或许只需要描述自己想去的地方,AI就能搭建一个可以走进去的世界。
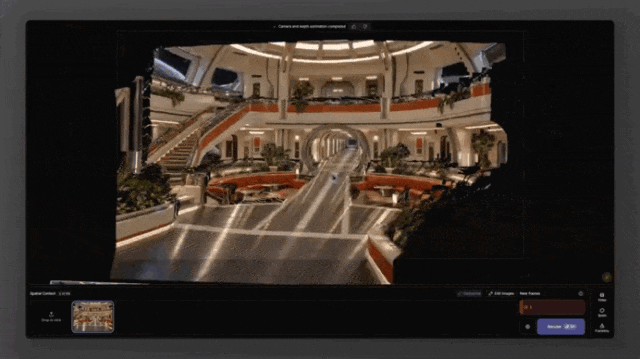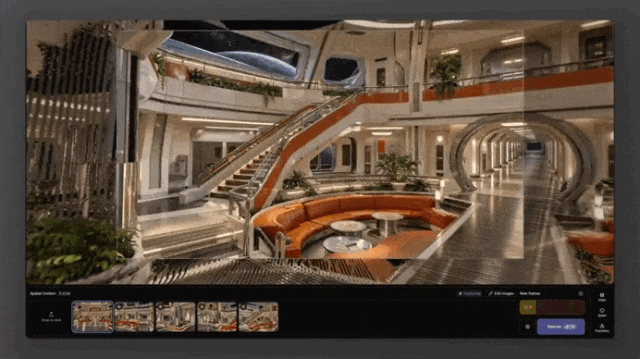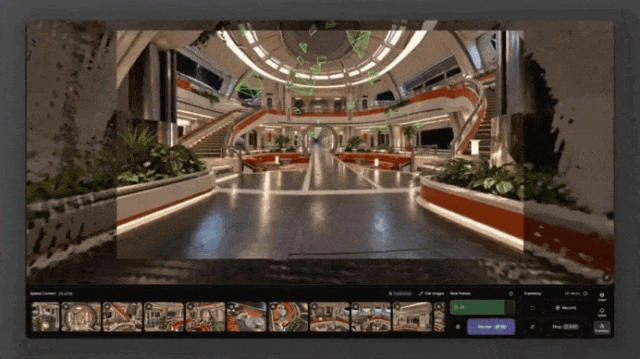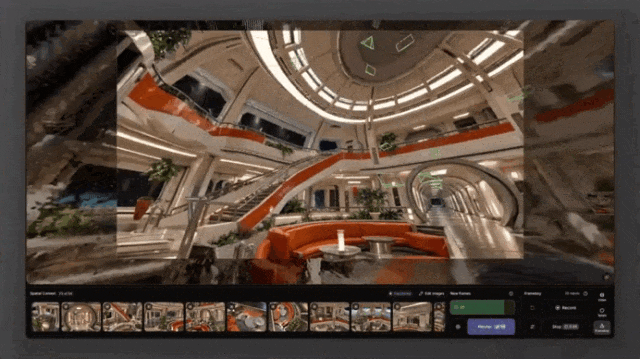
并且在前段时间,李飞飞和World Labs团队在聊世界模型时,还提到过一个很有意思的方向。
语言模型擅长预测下一个词,视频模型会预测后续画面,而他们希望AI能理解观察位置变化后,周围世界应该呈现什么样子。
这样制作的空间才有机会进一步支持编辑、交互和模拟,不会只停留在一段漂亮的视频里。
以后做互动故事、虚拟展厅或者在线的3D体验,这套方法都可以继续扩展。
至于下一步,小编更想试试让人物遇到NPC后可以自然聊天,看看这个河谷还能发生什么故事。
文章来自于“虾蛄AI”,作者“虾蛄内容部”。
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LGM是一个AI建模的项目,它可以将你上传的平面图片,变成一个3D的模型。
项目地址:https://github.com/3DTopia/LGM?tab=readme-ov-file
在线使用:https://replicate.com/camenduru/lgm
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0