戴着 AI 眼镜出门前,问 AI 一句 “刚才把钥匙放在哪里了”;一场会议结束后,让 AI 助手回顾 “白板上的方案和最开始相比改了哪些地方”;戴着可穿戴摄像头设备的维修师傅正在进行检修的时候,被视频大脑提醒到 “刚才关闭阀门的动作没有完成,请重新检测一遍”。这些日常生活和工业需求,都要求 AI 把眼前画面与此前的内容联系起来。Weitu AI 打造的流式多模态视频大脑,正是为了让任何带摄像头的设备能持续高效准确地理解环境,并将看过的信息转化为可用于回想和进行复杂推理决策的记忆。
香港多模态人工智能公司 Weitu AI 目前已服务全球数十家企业,以及全球约 600 万个人用户。团队希望将多模态技术进一步带入日常生活,办公和工业场景,让各个场景的多模态设备具备持续感知,推理和决策的能力。
据 Weitu AI 团队介绍,流式视频大脑要解决的核心问题,是在视频不断到来的过程中,可以高效地理解场景的变化,不断地产生记忆,并通过实时的理解和不断更新的记忆来实现复杂的推理和决策。对用户而言,这意味着随着这样流式视频大脑的应用,所有需要不断感知环境和交互的各种多模态设备,会先迎来物理世界的 ChatGPT 时刻。
时空压缩的高效学习架构带来持续的多模态感知
现实中的视频持续产生,模型的计算资源与记忆容量却十分有限。如果把全部画面长期保留并反复参与计算,会增加处理负担;过度抽帧或只保留很短的时间窗口,又可能漏掉关键的时序变化。比如,“钥匙被放入书包侧袋” 的动作只持续片刻,十分钟后用户寻找钥匙时,这个细节才显得尤为重要。
Weitu AI 打造视频原生的多模态架构。这样的架构可以实现流式视频信号的高效压缩和感知学习。设计思路是让计算围绕当前需要理解的变化展开。在构建视频原生的表征与记忆机制时,团队构建了 Dual Sparse Memory(双层稀疏记忆)的学习架构:先从时间维度自动筛选出相关片段,再从片段内部提炼关键的时空特征,避免大量无关的画面信息占用学习的计算资源。
第一步是时序块级稀疏学习,也就是时序上的压缩感知。面对 “会议开始时白板上写了什么” 这类回溯性问题,模型先将注意力集中到相关的历史时间片段,大幅缩小后续的计算范围。第二步是空间域上的稀疏学习:进入这些片段后,模型自动聚焦并提取关键的视觉细节(例如画面主体内容及其变化),而非让整帧场景的所有信息都参与同等强度的计算。
这套机制把 “何时看过” 和 “哪些细节有用” 同时放进网络进行学习。其目标是在保留关键特征的同时,控制注意力计算与缓存开销,让持续视频理解更适合长期运行的各种硬件设备。比如,对各类硬件系统而言,计算效率直接关系到响应体验、部署成本以及端云协同方案的可行性。
不断更新的记忆帮助复杂推理
高效的压缩感知和计算解决持续理解的问题,而不断更新的记忆模块则可以帮助模型解决更加复杂的推理。Weitu AI 的模型,除了理解当前画面外,还包括了 Long-term Memory Module(长期记忆学习模块),将较早的视觉与时空信息压缩为紧凑的表征,并随新画面的到来持续更新。
这类记忆承载的是可供模型使用的历史信息,包括物体的位置变化、动作的先后关系,以及场景中的重要状态。模型既要记住 “钥匙曾在桌面上” ,也要保留 “后来被放进包侧袋” 这一带有时间和空间变化的信息。例如,在工业场景中,这样的能力可以用于理解过去的操作演示的步骤。
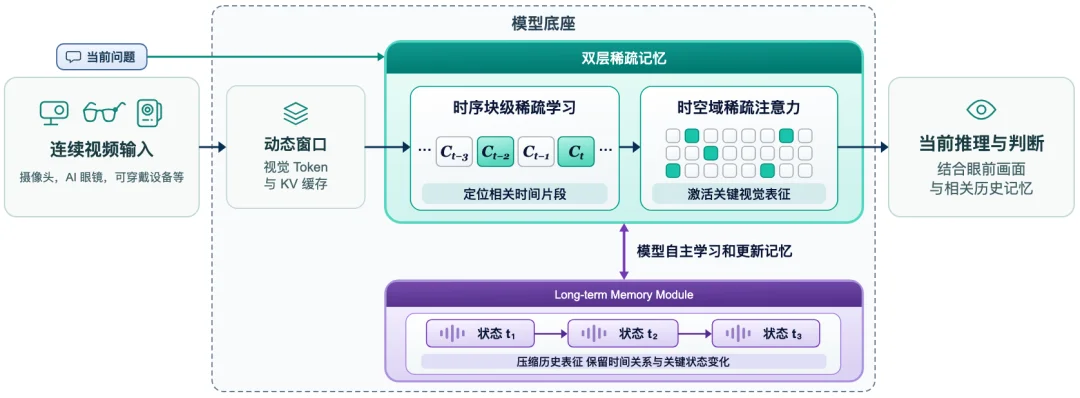
流式视频大脑的记忆架构示意
Weitu AI 团队介绍道,团队将记忆视为经过选择与压缩的智能表征。记忆模块要学习的不仅仅在于当前的信息的压缩感知, 也包括能支持未来理解和推理的信息。就像人类在思考时,也常常通过回想,来找到记忆作为推理的信息。这为视频模型的记忆设计提供了启发。
例如,当用户问 “钥匙和书本是不是放在一起了”,系统需要将不同时间看到的物品位置和收纳动作联系起来,再判断它们是否被放在同一个位置。这让记忆参与复杂的推理和判断。压缩记忆无法保留原始视频的全部细节,模型需要学习并不断地在有限容量内持续更新,让记忆模块尽可能参与后续的复杂推理。
不仅如此, Weitu AI 团队还探索了流式视频大脑的新场景,比如对视频状态的预测和判断,以及对正在发生的事件或者动作的状态做出准确的预测。Weitu AI 团队提到 “ 比如,当 AI 系统在观看咖啡冲煮过程时,需要准确地区分 “正在倒水” 和 “这一步已经完成”,才能回答步骤顺序、动作是否完成等问题。把状态变化与时间关系一起纳入记忆,有助于理解一个事件或者动作如何发生,以及何时进入下一阶段。这类问题也是研究上非常有趣的新问题,即如何预测尚未完成的动作的时间边界, 这个相当于是对未来的状态的预测。”
在流式视频与记忆评测中展现优势
近期评测显示,Weitu AI 流式视频大脑在连续视频理解领域展现出显著的架构优势。在考察 “过去记忆、当前感知与未来预测” 三大时间维度、共 16 项子任务的权威基准 OVBench [1] 上,Weitu AI 流式视频大脑的综合得分达到 69.9,较行业经过充分验证的通用多模态强基线 Gemini 3.1 Pro(58.8)高出 11.1 ;与此同时,在高度贴近 AI 眼镜等可穿戴设备持续感知场景的 Meta S-EMBER 基准 [2] 上(该测试采用第一人称视角日常视频,要求模型仅依据提问时刻之前看到的内容作答),Weitu AI 流式视频大脑取得了 58.23 的得分,同样较基准对齐的 Gemini 3.1 Pro(54.41)高出 3.82 。
这些结果显示,Weitu AI 的模型在流式视频理解和带有记忆评测的基准上都展现出优势。这样带来的产品价值,可以让更多的 AI 设备更好地理解不断变化的场景并通过当前画面结合记忆来进行推理和决策。


如图的两个例子展示了模型的 “时空记忆” 问答能力:在连续的视频流中,模型能够随时响应用户的提问,融合当前视觉信息与相关历史记忆画面,精准回答问题。
让持续感知与记忆走进更多应用场景
流式多模态大脑的应用空间,覆盖各类需要持续理解环境并作出响应的设备与产品。从 AI 眼镜、可穿戴摄像头到其他视觉终端,这套能力有望融入日常生活、办公、教育、零售与工业场景,为用户提供与当前活动紧密相关的即时帮助。
例如,在学习折纸或烹饪时,AI 助手可以结合已经完成的步骤提示下一步;在购物时,可以将眼前商品与此前看过的款式、规格和标签进行比较;在办公演示结束后,可以帮助用户回顾操作顺序和方案变化;在工业检修过程中,则可以结合此前的操作与当前设备状态,提示需要进一步检查的环节。这些场景共享同一种能力需求:将当前观察与历史记忆联系起来,理解任务的进展,并为接下来的判断提供依据。
这样的能力也可以应用于视频创作。在视频持续生成与编辑的过程中,模型可以结合当前画面、创作进度和此前内容,持续评估作品与创作目标的契合程度,围绕镜头衔接、叙事节奏和视觉风格提出优化建议,并动态规划后续的生成、剪辑与修改步骤。通过将持续感知、记忆与推理融入创作流程,有望减少反复生成和修改带来的时间与计算成本,让作品更加符合创作者的表达意图,同时保持内容连贯与风格一致。
为通用大模型提供持续感知世界的入口
通用大模型的能力进展,正在拓展 AI 参与复杂任务的空间。OpenAI 的 GPT-6 系列在复杂任务处理、计算机操作与成本效率等方面取得进展;Anthropic 则在 Claude Fable 5.2 的发布中,展示了模型控制机器人完成拧开瓶盖、绘图等任务的能力。
在 Weitu AI 看来,随着通用模型的推理与任务规划能力增强,如何高效、实时地感知环境变化,并将相关历史信息带入当前判断,将成为机器人应用的重要基础。例如,家用机器人在寻找物品或整理房间时,需要持续确认物品是否移动、操作是否完成、任务条件是否变化,并结合此前的观察调整行动。持续更新的感知与记忆,能够为这些判断提供必要的上下文。
Weitu AI 希望推动其流式多模态大脑成为各类通用大模型提供持续感知世界的入口:由视频大脑持续处理画面、追踪场景状态并更新记忆,为复杂推理与任务规划提供及时、紧凑且与任务相关的视觉和多模态信息。这相当于为通用大模型提供一双能够持续观察、保留相关记忆的 “眼睛”,有望减少其反复处理冗长视觉存储的负担。
这一定位也赋予了流式多模态大脑两类应用价值:既可以直接支持具体场景,也可以作为感知与记忆模块,与其他通用模型协同。未来,当这套能力进一步与机器人的运动控制和执行系统结合,有望帮助机器人在家庭、办公及服务环境中持续理解任务过程,并根据环境变化调整后续行动。
从视频出发,融合更多模态信息
Weitu AI 介绍,流式视频大脑是团队探索多模态交互智能的起点。未来,团队希望在这一模型架构上持续融合更多模态的信息,使感知、记忆与推理能力能够适应不同设备和场景的需求。
例如,在工业场景中,视频可以与温度、压力、振动等传感器信号结合,共同反映设备运行与环境变化。不同信号提供了互补的信息:画面呈现操作过程和外观变化,传感器则反映温度波动、压力变化或振动异常。模型需要将这些信息在时间与空间上关联起来,理解它们之间的联系,并形成可供后续判断使用的记忆。
持续感知变化,将重要信息压缩为时空记忆,再结合当前感知与历史记忆进行推理和决策,是 Weitu AI 打造流式多模态大脑的核心思路。从今天的摄像头、AI 眼镜和可穿戴设备,到未来的机器人与工业多模态系统,团队希望通过可扩展的模型架构,让更多设备具备持续理解环境的能力,也为通用大模型提供快速、准确感知世界的入口。
Weitu AI 欢迎各行业伙伴洽谈合作,不断探索流式视频大脑在全球更多场景中的应用。 申请体验和试用模型的商业用户,请使用企业邮箱发送需求至 business@weitu.ai,我们将尽快与您联系。
关注 Weitu AI 更多进展,欢迎订阅下方公众号。
[1] Huang Z, Li X, Li J, et al. Online video understanding: Ovbench and videochat-online [C]//2025 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). IEEE, 2025: 3328-3338.
[2] Wang X, Zhao X, Rodriguez P, et al. S-EMBER: A Large-Scale Benchmark for Streaming Egocentric Memory Retrieval [J]. arXiv preprint arXiv:2607.02689, 2026.
文章来自于"机器之心",作者 "机器之心"。