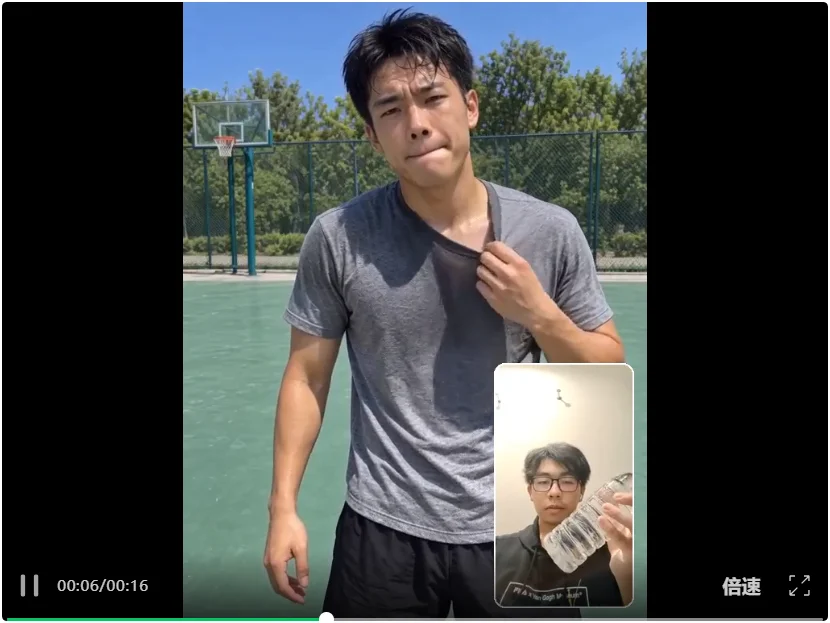
想象一下,你在现实中拿起一瓶水,递向屏幕。下一秒,屏幕里的虚拟人物竟然伸出手,接过了这瓶水。
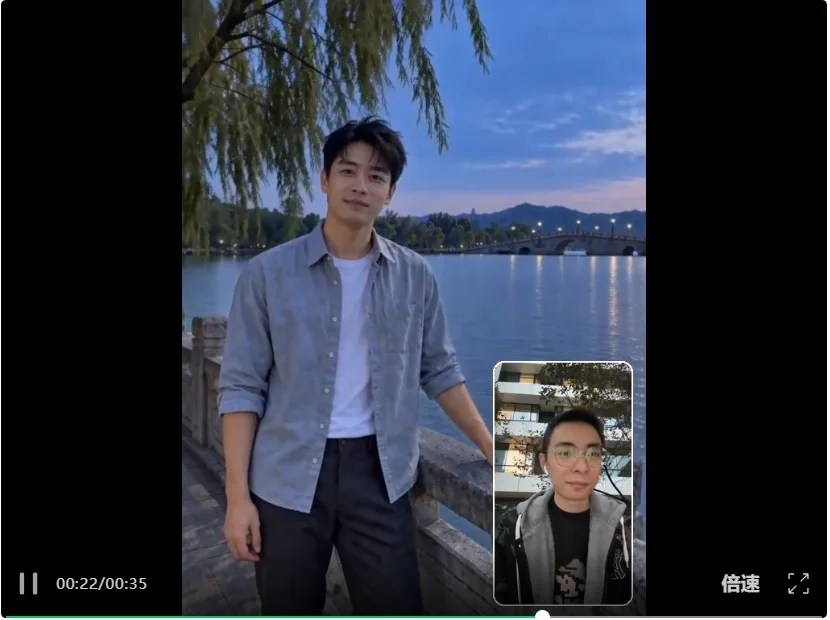
更有意思的是,虚拟世界里的景色也能随着对话发生变化。当你和虚拟人物聊起杭州西湖,原本明亮的白天场景,竟然会随着交流逐渐切换成夜幕下的西湖。
这听起来像是科幻电影里的桥段,却已经有研究团队将它变成了现实。
近日,蚂蚁团队联合西湖心辰提出全新世界模型范式 Reciprocal World Model(RWM,双向世界模型),并推出首个实现版本:原生世界模型 Duo v1。
Duo v1 将智能与物理现实视为构成世界的两个同等重要的基础。它希望生成一个有鲜活智能体存在的世界,并通过实时全双工交互将其与现实世界连接起来,在对方仍然表达或行动时作出回应、主动打断,也可以选择保持沉默。
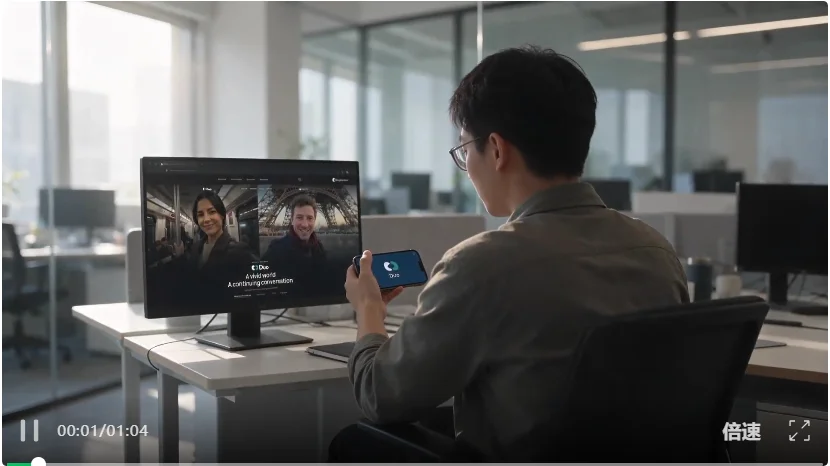
为实现这一目标,团队提出了两项核心能力:Intent(意图)负责理解交互情境、进行推理并决定如何参与;Realization(实现)负责将这些意图转化为连贯的视听行为。
用户还可以向模型展示现实中的物体、改变虚拟场景、引导 AI 助手,或参与音视频游戏,整个过程无需依赖鼠标或键盘控制。
- arXiv: https://arxiv.org/abs/2611.15131
- Homepage: https://duo-v1.github.io/
- Github: https://github.com/inclusionAI/Duo
- Hugging Face Model: https://huggingface.co/collections/inclusionAI/duo-v1
- ModelScope:https://www.modelscope.cn/collections/inclusionAI/Duo-v1
从模拟物理世界,到让智能主体参与其中
理解 Duo v1,首先要理解团队对现有世界模型的一个判断。
目前主流世界模型的研究重点是模拟物理世界。模型观察过去的画面和控制信号,预测未来场景如何演化。用户通过键盘、鼠标、手柄或文字指令改变环境,模型负责生成变化后的画面。
这种模式下,交互的主动权掌握在用户手中。世界中的角色更多承担被观察、被操控的功能,缺少自主感知用户、理解交互情境、决定如何回应,甚至与用户共同创造的能力。
换句话说,生成一个世界并不难,难的是让这个世界中的角色真正「活」起来。
基于这一判断,团队提出双向世界模型 Reciprocal World Model(RWM),并发布实现版本 Duo v1。
这里的关键是「双向」。传统交互通常由用户发起指令,再等待模型给出结果。RWM 则希望让交互双方都成为主动参与者,持续感知对方的音视频,并根据实时发生的情况作出反应。
用户说话时,虚拟主体可以自主判断是否回应,甚至在用户尚未说完时主动插话;用户展示现实中的物体时,它也能结合视觉信息理解情境。
这种双向实时交互能力,也让 RWM 与其他常见技术路线形成区别。
大语言模型主要负责语言理解与生成,传统世界模型侧重环境模拟与未来状态预测,多模态 Agent 或数字人方案则通常通过 ASR、LLM、TTS 和视觉模型等组件组合实现交互。
Duo v1 探索的是另一种实现方式。它通过 Intent 和 Realization 两个相互协作的模块,将交互决策与音视频生成整合到同一架构中。
因此,双向世界模型是将智能主体的感知、认知和行为纳入世界模型本身,让虚拟世界与现实用户之间形成持续的双向连接。
从意图决策到音视频生成,拆解 Duo v1 的核心架构
在实现方式上,Duo v1 采用模块化设计:
- Intent(意图模块): 负责理解交互情境、推理用户意图,并决定何时回应、回应什么内容。
- Realization(实现模块) :负责将这些意图转化为具体的音视频行为,包括生成语音、人物表情和画面动作。
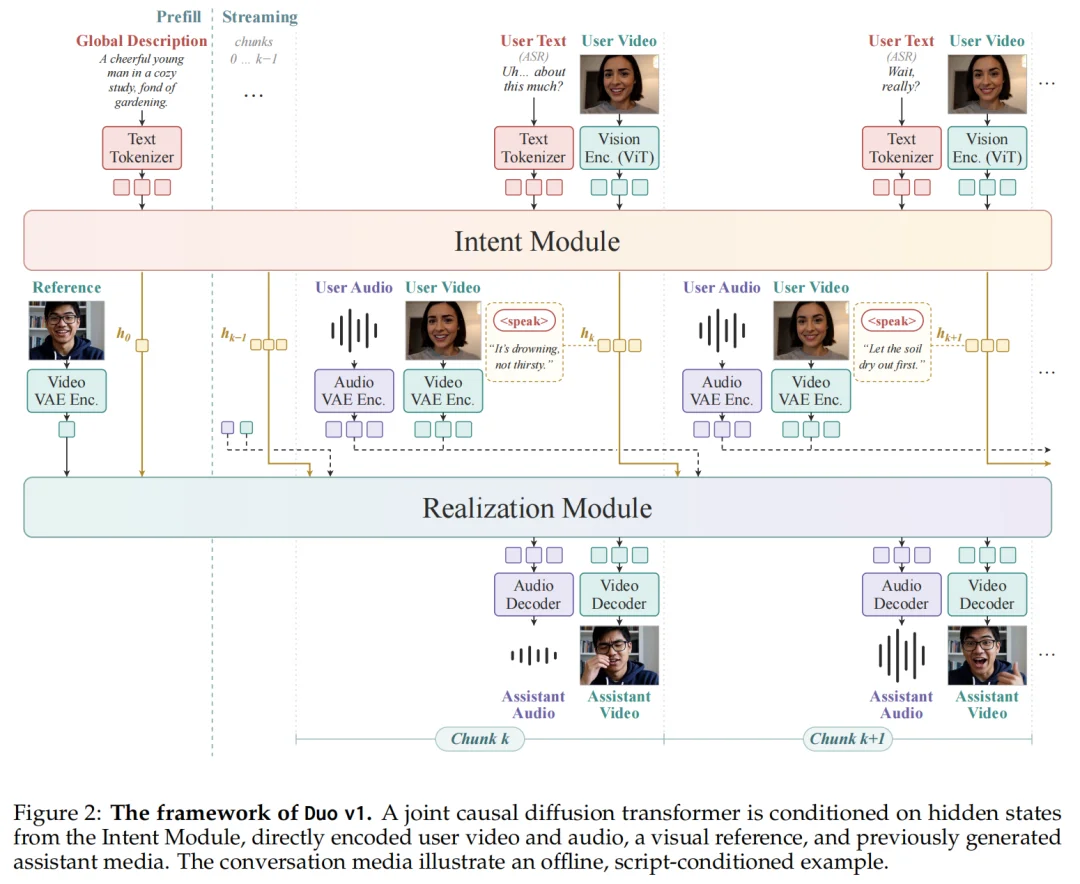
两个模块之间通过 Intent 输出的隐藏状态传递信息。这些隐藏状态承载了模型在交互推理过程中形成的语义特征,为 Realization 提供生成音视频所需的条件。
Intent:让模型学会什么时候说话
传统音视频生成系统通常由语言模型承担条件编码,将理解后的文本信息传递给扩散模型,作为后续音视频生成的条件。
Duo v1 对 Intent 模块赋予了更完整的职责,它需要持续理解正在发生的交互,并自主判断是否应该参与。
在每个时间块(chunk)内,Intent 模块基于用户输入和交互历史,实时自主决策,并同步生成对应的语言内容。
- <speak>:开始说话,并生成对应文本。
- <wait>:当前 Chunk 不产生新的助手文本,选择继续等待。
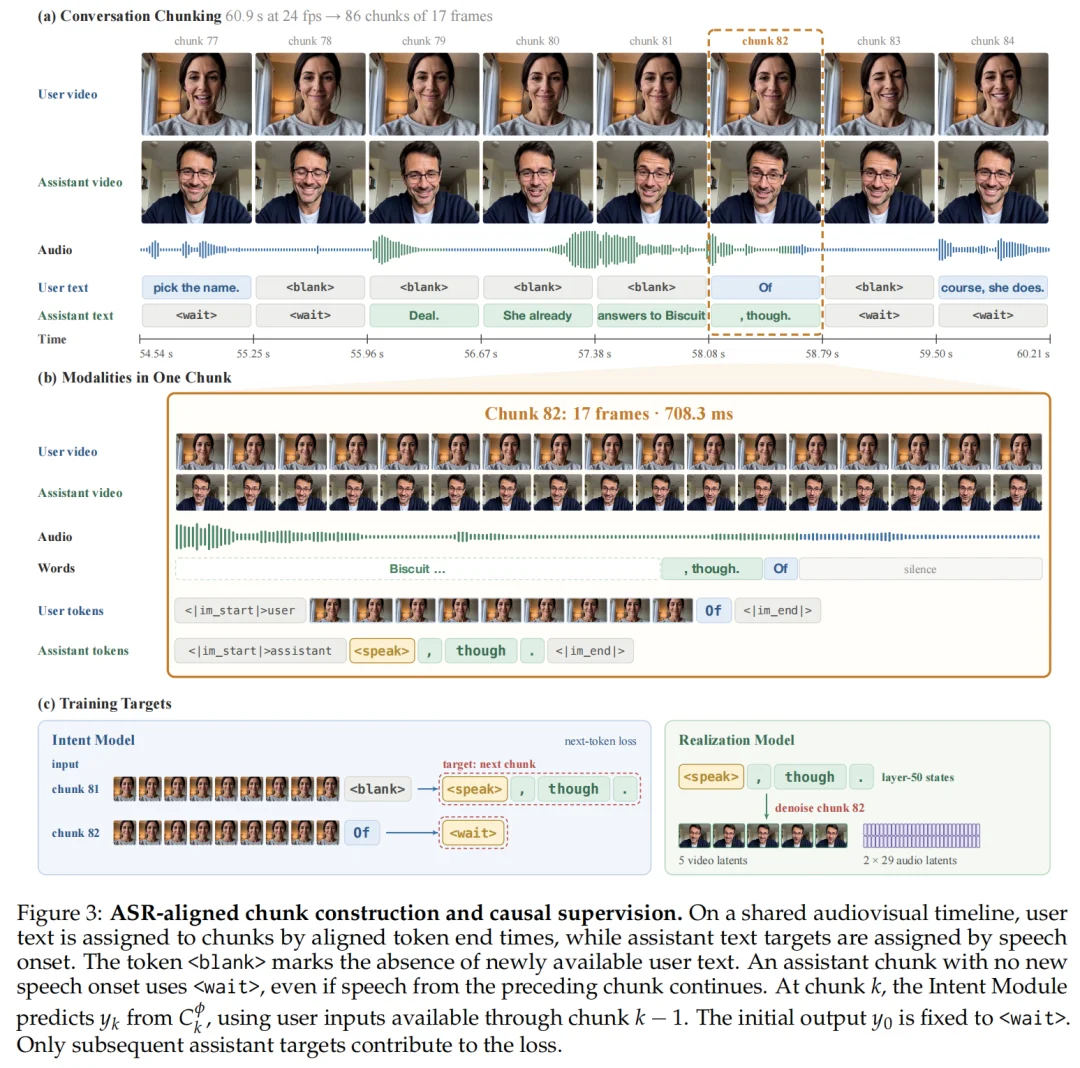
例如,用户还在表达时,模型可以选择等待;当用户提出问题,或者出现适合回应的时机时,模型可以主动开始说话。需要注意的是, <wait > 并不意味着整个系统停止输出。此前生成的语音可以继续播放,Realization 也可以延续此前的音视频生成过程。
值得注意的是,Intent 不只把最终生成的文本传递给 Realization,还会输出对应的隐藏状态,让后者获得更丰富的语义条件。
此外,为了支持实时响应生成,团队还将音频和视频编码为紧凑的潜在表示,供后续音视频生成使用。
Realization:让意图变成连贯的视听行为
Realization 是 Duo v1 负责音视频生成的核心模块,采用因果音视频扩散 Transformer(Causal Audiovisual Diffusion Transformer)。
模型从随机噪声开始,在意图表示、参考图像、当前可用的用户输入,以及此前生成的助手音视频内容等条件约束下,逐步生成音视频潜变量。此前生成的内容会作为历史信息,帮助模型在不同回应 Chunk 之间保持连续性。
意图条件。通过线性投影,将 Intent 模块输出的隐藏状态映射到 Realization 模块的隐藏维度,再利用一个精炼网络(Refiner Network)生成文本条件嵌入。
媒体条件。用户输入的音频和视频分别通过音频 VAE 和视频 VAE 编码器进行处理,生成对应的条件潜变量。
参考图像则通过视频 VAE 编码器处理,得到参考潜变量。随后,这些潜变量被映射为联合扩散 Transformer(DiT)对应的输入嵌入。
此外,此前生成的助手音频和视频潜变量也会作为音视频历史信息输入模型。
这些条件共同为当前回应 Chunk 提供四类信息:用户的实时观察、参考图像的外观特征、语义指导,以及模型此前生成的交互历史。
需要注意的是,模型只会使用第 k 个 Chunk 开始之前已经获得的用户输入,不会访问尚未发生的后续信息。
为了让不同模态在时间上保持一致,团队引入了三维旋转位置编码(3D-RoPE),统一表示音频、视频和文本 Token 的时间与空间关系。音频和视频按照实际播放时间进行对齐,音频还通过不同的空间位置编码区分左右声道。
与此同时,Duo v1 还需要确保不同模态在时间上严格对齐。
为此,团队将用户语音、视频画面、Intent 决策和 Realization 生成统一映射到同一时间线上,并以约 0.7 秒为一个 Chunk 组织交互。不同模块采用专门设计的注意力掩码,控制每个 Chunk 内部以及不同 Chunk 之间的信息访问范围。
这意味着,模型生成当前 Chunk 时,只能使用此前已经获得的用户输入和交互历史,不能提前读取未来画面或尚未发生的用户行为。Realization 也只能根据当前可用的意图特征、参考信息和历史内容生成音视频。
通过联合生成、时间对齐和因果约束,Duo v1 将用户感知、意图理解与视听表达整合到同一套生成过程中,让语音、表情和画面动作围绕同一个交互意图协同产生。
从主动决策到自主生成,Duo v1 如何训练交互能力
Duo v1 整个训练过程分为三个阶段。
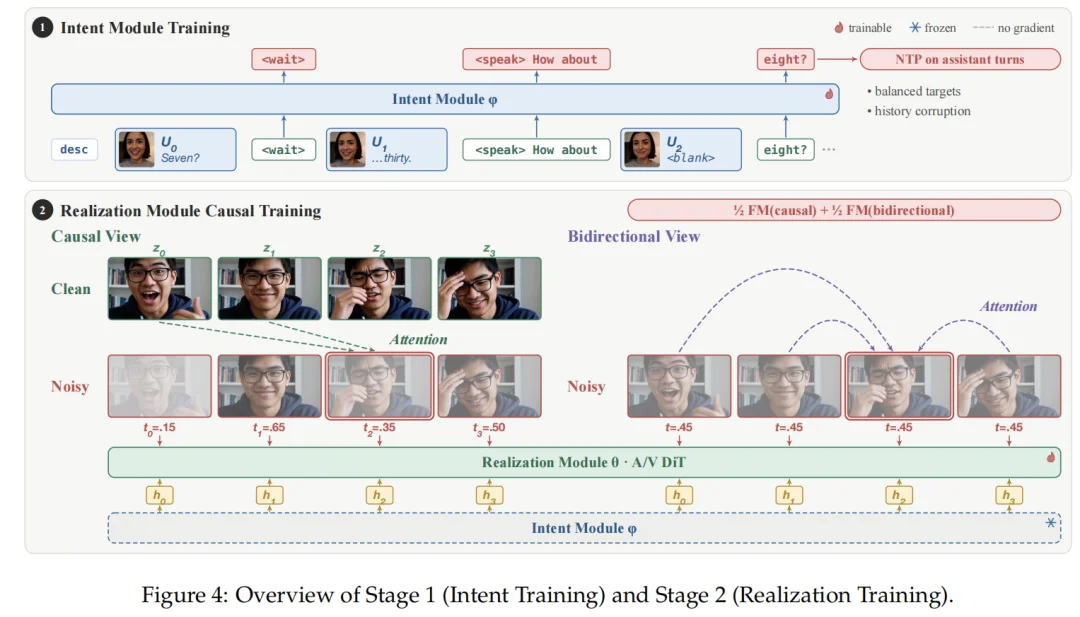
第一阶段:Intent 模块的监督微调。
训练数据按照 Chunk 对齐。模型在每个 Chunk 开始时,根据全局指令、此前已经获得的用户视频、ASR 转录文本,以及助手此前生成的语言内容,预测当前应该输出什么。
模型需要学习两种基本动作:
<speak > 表示开始说话,并生成新的文本内容;<wait> 表示当前 Chunk 不引入新的助手文本。即使选择等待,此前生成的语音仍然可以继续播放。
训练过程中,团队发现,大多数 Chunk 都不会产生新的助手文本。如果直接按照原始数据分布训练,模型容易过度倾向于等待。
为此,团队设计了动作感知再平衡机制(Action-aware Rebalancing),根据用户是否正在说话、助手回应属于开场还是续接等信息,对训练样本进行分类,再通过子采样和损失加权调整不同类别的训练比例。
其次,为了让模型适应不完美的交互历史,团队还引入了历史扰动(History Perturbations),通过截断、重复部分历史文本,或将正常的对话开场替换为 < wait> ,模拟此前回应不完整、文本出现偏差或错过回应时机等情况。
第二阶段:训练 Realization 联合生成音视频。
这一阶段使用已经冻结的 Intent 模块,从真实记录的助手文本中提取意图隐藏状态,作为 Realization 的语义条件。同时,用户输入的音视频、人物参考图像,以及此前记录的助手音视频历史,也会作为生成条件。
Realization 采用因果音视频扩散 Transformer,通过流匹配学习音频和视频潜变量的联合生成。
训练过程一半采用因果视角,按照真实交互的时间顺序限制信息访问;另一半采用双向视角,让模型在更充分的上下文条件下学习音视频生成。
两种训练方式各占一半,共同优化 Realization 模块。
通过这一阶段,Realization 学会根据 Intent 提供的语义特征、用户输入和已有音视频历史,联合生成连续的视听内容
第三阶段:双 Rollout 蒸馏,缩小训练与推理的差异。
训练 Realization 时,模型使用的意图特征来自真实记录的助手文本,音视频历史也来自真实数据。但在实际推理中,这些信息都需要由模型自己生成。
训练时依赖真实记录,推理时依赖模型自身生成,两种情况下的输入分布存在差异。随着交互持续进行,这种差异可能影响后续生成的稳定性。
为此,团队提出双 Rollout 蒸馏(Dual Rollout Distillation)。
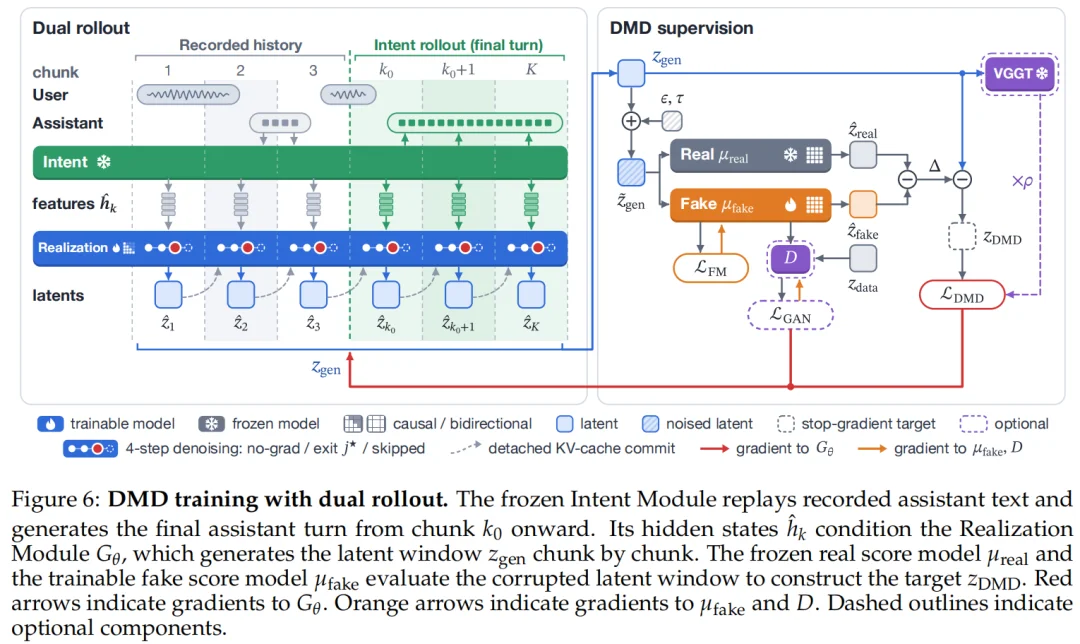
首先,冻结的 Intent 模块通过自回归方式生成助手当前完整回合的文本回应,这一过程称为 Language Rollout。
随后,Realization 模块以这些文本对应的意图隐藏状态,以及自身此前合成的音视频历史为条件,继续生成音视频内容,这一过程称为 Media Rollout。
这样,模型在训练阶段就能接触到更接近实际推理状态的输入条件。
最后,团队通过分布匹配蒸馏(Distribution Matching Distillation),利用自主生成的交互轨迹进行训练,将生成过程进一步蒸馏为一个四步流式生成器(Four-step Streaming Generator)。
实时交互背后,还需要一套流式推理系统
团队还专门设计了一套编排式流式推理系统(Orchestrated Streaming Pipeline),对 Intent 模块、Realization 模块和 VAE 进行协同调度与同步,以确保交互任务能够实现低延迟运行。
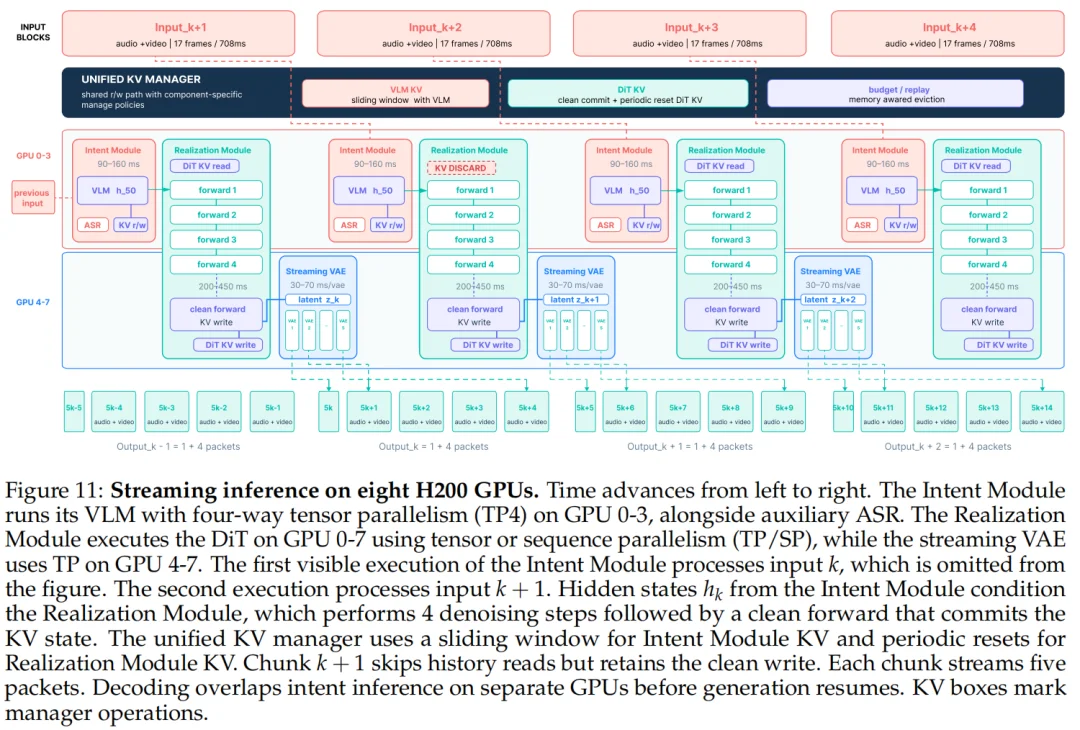
整个过程以 Chunk 为单位进行。按照 24 FPS 计算,每个 Chunk 包含 17 帧视频,对应约 708 毫秒的采样时间。前端设备持续采集用户的音频和视频,将数据送入下游处理流程。模型随后完成意图推理、音视频潜变量联合生成和流式解码。在生成回应的过程中,用户输入仍然持续进行。
Intent 模块完成一次推理需要 90 至 160 毫秒,Realization 模块生成 720p 音视频潜变量需要 200 至 450 毫秒,数据传输和显示等其他开销约为 40 毫秒。三项合计约 330 至 650 毫秒。
为了减少等待,团队进一步优化了 VAE 的解码方式。
原始 VAE 将 5 个潜在帧解码为 17 帧视频,需要提前获取 2 个潜在帧。这种前瞻依赖会增加 Chunk 边界处的等待时间。Duo v1 将解码过程改为因果式增量解码。一个 Chunk 完成生成后,系统可以逐个解码其中的视频潜变量,每个潜在帧对应 4 帧视频,再通过时间对齐恢复原有的 17 帧播放节奏。
每个潜在帧的解码耗时约 30 毫秒。相比之下,24 FPS 下最短的播放间隔约为 41.7 毫秒。只要生成的潜变量能够按时提供,解码器就能跟上视频播放速度。
团队还设计了统一 KV Cache 管理机制。Intent 模块通过滑动窗口淘汰历史缓存,Realization 模块则按照设定周期重置媒体历史。
在并行计算方面,Intent 模块采用四路张量并行(TP),Realization 则根据计算速度和显存余量,在张量并行与序列并行(SP)之间选择更合适的配置。
团队将持续输出的目标设定为每个 Chunk 的完整处理周期不超过 17/24 秒,也就是约 708 毫秒,与输入采样周期保持一致。
这套系统的关键是将输入采集、意图推理、音视频生成和增量解码组织成一条可以并行运行的流水线。模型不必等到整个交互回合结束才开始回应,用户也不需要停止表达,等待模型完成全部生成过程。
93.3% 评测通过率,Duo v1 探索世界模型交互新范式
团队选取了 30 组实时全双工交互案例进行人工评测,覆盖六个维度:内容响应、语言一致性、语音可懂度、视觉身份稳定性、音视频同步,以及音视频情绪一致性。
最终,180 项检查中有 168 项通过,总体通过率达到 93.3%。其中,语言遵循性、语音可懂度和视觉身份稳定性三项指标全部通过,均达到 100%。说明模型能够生成完整、清晰的语音,并保持人物形象稳定。音视频情绪一致性达到 96.7%,口型与语音同步率达到 90%。
除了基础对话,团队还展示了 Duo v1 在更多交互场景中的表现。
例如,用户可以通过对话解决日程冲突,让模型协助调整计划;也可以与模型共同比较设计样品、调整方案,或者展示一张参考图片,让模型据此修改服装图案。
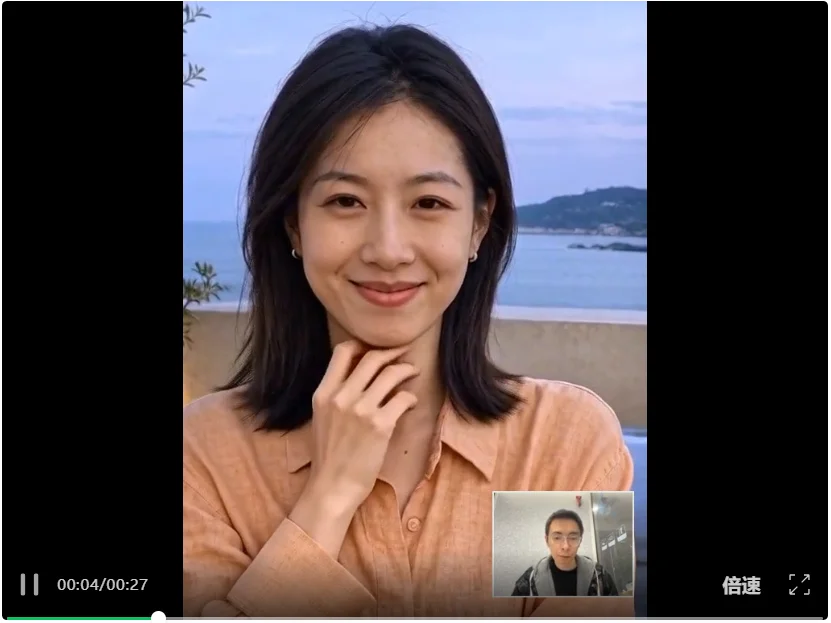
双方不再需要轮流等待对方说完。用户可以随时插话、打断甚至改变话题,虚拟人物也能同步感知并作出回应。
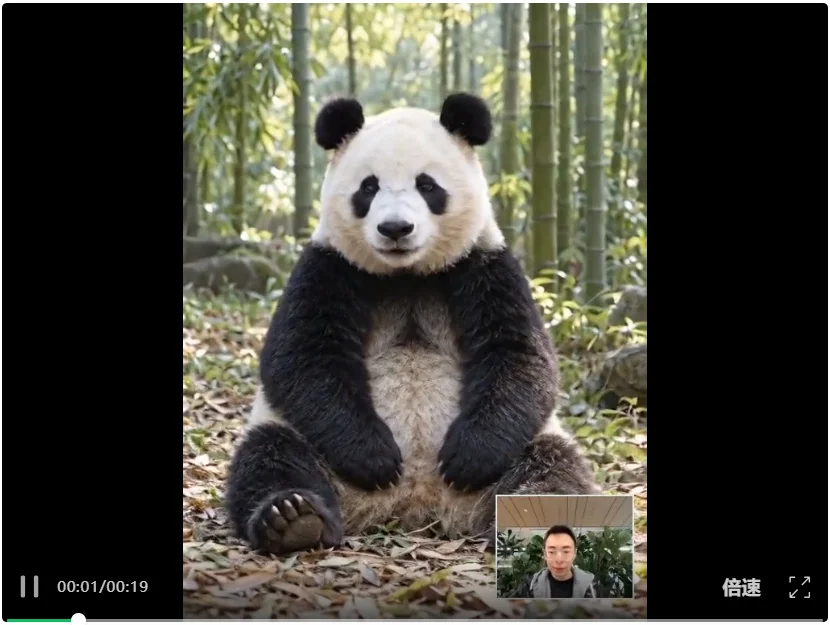
与国宝大熊猫面对面,开启一场实时互动。
这些案例说明,Duo v1 的交互设计已经开始超越简单的语音问答,尝试将语言交流与视觉观察、方案调整和协同行动结合起来。
世界模型的下一步,是让智能体真正参与世界
Duo v1 真正值得关注的地方,是它尝试重新定义世界模型中的智能主体应该具备什么能力。
传统数字人主要围绕人物形象、语音表达和语言对话展开。用户提出问题,数字人给出回答,再通过表情、口型和动作增强表现力。交互通常围绕一个预设角色进行,核心是让虚拟人物看起来更真实、表达得更自然。
双向世界模型探索的空间要大得多。它将感知、认知、决策和视听行为整合进世界模型,让虚拟主体能够持续观察用户及其所处的环境,自主判断何时参与,并根据交互内容作出反应。
这让应用场景有了更多可能。
在游戏中,NPC 可以摆脱固定台词和预设交互逻辑,根据玩家的语言、动作和周围环境作出实时反应。玩家甚至可以直接通过语音和现实物品与虚拟角色互动,让游戏从单向探索变成双方共同参与的过程。
在 AI 助手场景中,用户可以展示现实中的物品、图片或环境,让虚拟主体结合视觉信息参与讨论。它可以协助解决日程冲突、分析设计样品,也可以根据用户的反馈持续调整方案。交互不再局限于文字框和语音入口,现实环境本身也成为模型理解和行动的上下文。
在虚拟内容创作中,用户可以通过自然语言改变场景、调整视觉元素,甚至与 AI 一起完成设计和创作。比如,用户提出改变场景时间,虚拟世界便从白天切换到夜晚;用户展示一张参考图片,模型则可以据此调整虚拟人物的服装图案。语言指令、视觉参考和场景变化被纳入同一个连续的交互过程。
双向世界模型还具有更丰富的探索方向,包括引导 AI 助手、改变虚拟场景,以及参与不依赖鼠标和键盘控制的音视频游戏。现实物体可以成为交互输入,虚拟场景可以随对话变化,AI 主体也可以主动参与正在进行的活动。
当然,Duo v1 目前仍处于早期探索阶段,但它已经提供了一种值得关注的技术方向。
过去,世界模型主要回答的是如何生成一个可信、连贯的世界。双向世界模型则进一步回答,当这个世界里有了智能主体,它们也能感知现实、主动参与,并与人共同改变世界。
未来的世界模型,或许不只是一个供人观看和探索的虚拟空间,还可能成为人和 AI 一起交流、协作、设计与创造的场所。
文章来自于"机器之心",作者 "陈陈"。
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】Fay开源数字人框架是一个AI数字人项目,该项目可以帮你实现“线上线下的数字人销售员”,
“一个人机交互的数字人助理”或者是一个一个可以自主决策、主动联系管理员的智能体数字人。
项目地址:https://github.com/xszyou/Fay
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】VideoChat是一个开源数字人实时对话,该项目支持支持语音输入和实时对话,数字人形象可自定义等功能,首次对话延迟低至3s。
项目地址:https://github.com/Henry-23/VideoChat
在线体验:https://www.modelscope.cn/studios/AI-ModelScope/video_chat
【开源免费】Streamer-Sales 销冠是一个AI直播卖货大模型。该模型具备AI生成直播文案,生成数字人形象进行直播,并通过RAG技术对现有数据进行寻找后实时回答用户问题等AI直播卖货的所有功能。
项目地址:https://github.com/PeterH0323/Streamer-Sales