现实世界中的事实知识并非一成不变:企业 CEO 可能更替,产品信息会随着发布与迭代而更新,赛事结果也会不断产生。多模态大模型需要及时吸收这些新信息,才能保持知识的时效性。然而,在持续引入新事实的过程中,如何避免新旧知识之间的相互干扰,并尽可能保留模型在预训练阶段形成的通用能力,仍是亟待解决的关键问题。
针对这一挑战,在西北工业大学宋凌云教授和尚学群教授的共同指导下,研究团队提出了多模态终身知识编辑框架 ROSE。该框架通过在知识编辑阶段约束参数更新方向,降低新旧知识之间的干扰。同时在推理阶段按需激活相关编辑的知识,从而减少连续知识更新带来的知识遗忘与原有能力退化。该论文入选 NeurIPS 2026 Spotlight。
- 论文标题:ROSE: Risk-Aware Orthogonal Subspace Navigation for Lifelong Knowledge Editing in Multimodal Large Language Models
- 作者:宋凌云,陈子尧,潘康,韩笑琳,张逸飞,王小奇,潘雨黛,尚学群
- 论文链接:https://arxiv.org/abs/2611.09770
- 代码链接:https://github.com/sunlitsong/ROSE
连续更新知识面临哪些挑战?
知识编辑旨在不重新训练整个模型的情况下,纠正错误或更新特定事实。在真实应用场景中,新事实会随着现实事件不断出现,已有事实也可能发生变化。因此,多模态终身知识编辑需要模型在学习新知识的同时,保留先前的编辑结果,并维持无关输入上的原有表现。本文将这一挑战归纳为两个方面:
1. 灾难性遗忘(Catastrophic Forgetting):后续知识更新干扰先前的编辑结果,导致模型难以保持已编辑过的事实性知识(例如,先前已纠正过苹果公司的 CEO,在后续更新后又回答错误)。
2. 局部性退化(Locality Erosion):知识更新使模型在无关知识上的输出发生非预期变化,甚至损害模型原有的预训练能力(例如,更新苹果公司 CEO 的信息后,模型对其他公司的 CEO 也产生了不必要的回答变化)。
视觉与文本表示之间的关联进一步增加了控制编辑范围的难度。一次事实更新可能同时影响图像理解和语言回答,因此需要兼顾历史编辑的保持,以及无关知识与原有能力的稳定性。
连续编辑为什么容易相互干扰
知识编辑希望以较小代价纠正模型中的特定事实,避免每次更新都重新训练整个模型。例如,模型可能先后接收到多条知识更新:先将苹果公司的 CEO 从蒂姆・库克更新为约翰・特努斯,随后更新特努斯的任职经历及其此前负责的业务,再补充库克卸任 CEO 后的职务变化。完成这些编辑后的模型不仅要准确掌握每一条新信息,还应保证此前已经写入的知识不能因后续其他事实的更新而被错误修改。
然而困难在于,大模型中不同事实所依赖的知识空间并非是相互独立的。一次新的编辑可能改变此前编辑所依赖的特征方向,也可能影响无关输入上的输出。因此,即使模型成功写入了新事实,后续编辑仍可能导致历史知识被遗忘,或改变其在无关问题上的回答。
下图使用优化路径直观地解释了这个问题:如果更新过于保守,可能无法成功编辑新事实。而如果更新过于激进,又容易干扰其他知识。因此,ROSE 希望在知识编辑过程中避开可能损害预训练能力的高风险参数子空间,同时减少与历史编辑方向的冲突,从而在新知识写入与原有知识保持之间取得平衡。
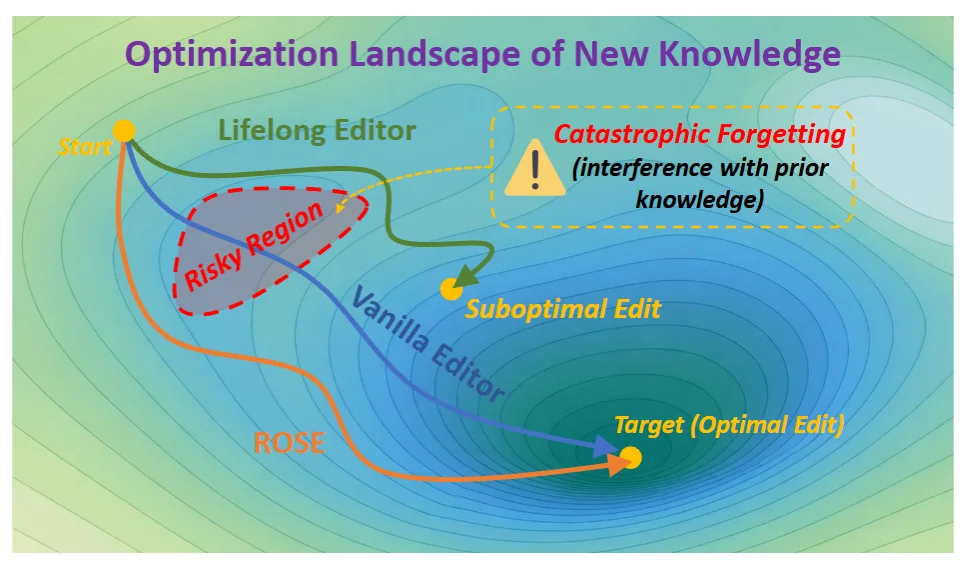
图 1 传统知识编辑方法与 ROSE 的优化路径示意。
ROSE 如何写入和使用新知识
在编辑阶段,ROSE 冻结原模型主干,在选定 Transformer 层的 FFN 下投影矩阵中引入一个辅助分支,连续到来的新知识都写入这个分支。在推理阶段,模型先判断输入是否是已编辑过的知识,再决定如何结合两个分支的表示。
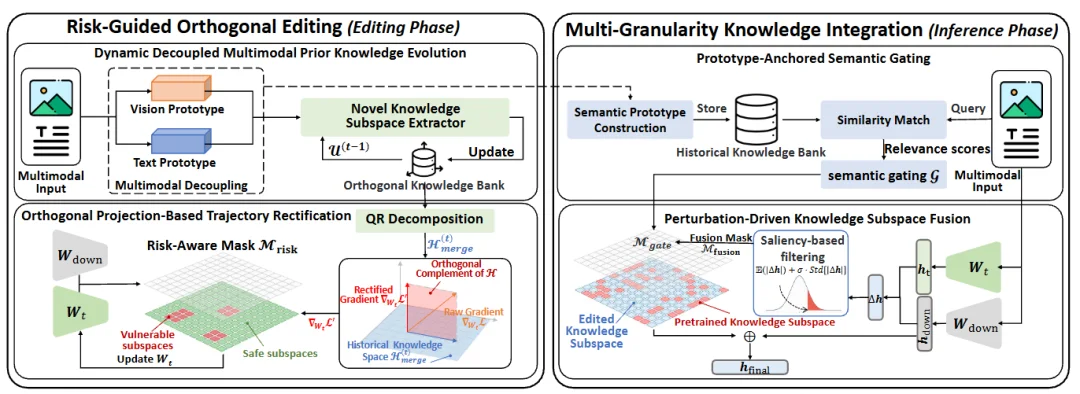
图 2 ROSE 框架图。
风险感知的正交编辑机制
为了减少后续编辑对已有修改的干扰,ROSE 分别提取历史编辑中的视觉和文本特征,构建对应的知识子空间用来记录历史编辑涉及的特征方向。在新一轮编辑时,ROSE 将梯度投影到历史知识子空间的正交补空间,移除与历史编辑方向重合的梯度分量,使新的参数更新尽可能避开已有编辑所涉及的特征方向,从而降低新旧知识之间的相互干扰。
然而,仅保护历史编辑涉及的特征子空间,还不足以保证模型原有知识与通用能力的稳定。为此,ROSE 引入动态风险掩码机制,以固定的原始权重为锚点,筛选出变化较大的参数空间参与后续更新,抑制其他参数位置的更新。该掩码在梯度更新时是动态重新计算的,以此来进一步保护大模型在预训练阶段形成的通用知识与能力。
多粒度知识整合策略
辅助分支中的编辑知识并非适用于所有输入。例如,更新苹果公司 CEO 的信息,不应影响模型对其他无关企业的回答。为此,ROSE 为每次编辑分别提取视觉和文本语义原型,记录本次修改涉及的知识特征。当模型接收到新问题时,通过计算输入特征与历史语义原型之间的相似度,判断当前输入是否与已有编辑相关。未通过语义门控的输入直接沿用原始主干的输出。
对于通过门控的输入,ROSE 进一步比较原始主干与辅助分支的特征表示差异,并据此构建动态融合掩码,仅在差异较为显著的位置引入编辑后的特征表示,其余位置仍保留原始表示。通过这种由粗到细的知识整合方式,实现对编辑知识的选择性调用,减少对无关知识和原有能力的干扰。
ROSE 在长编辑序列下的表现
论文在 VLKEB 和 MMEdit 两个基准上测试 ROSE,任务包括视觉问答和图像描述。可靠性关注模型是否正确完成目标知识的更新;泛化性考察模型在问题表述或图像发生变化时能否依然准确回答;局部性则关注知识编辑是否影响其他无关输入,确保模型在这些输入上的输出尽可能保持编辑前的一致性。
下表是 LLaVA-v1.5-7B 在 VLKEB 上完成 1000 次连续编辑后的结果。
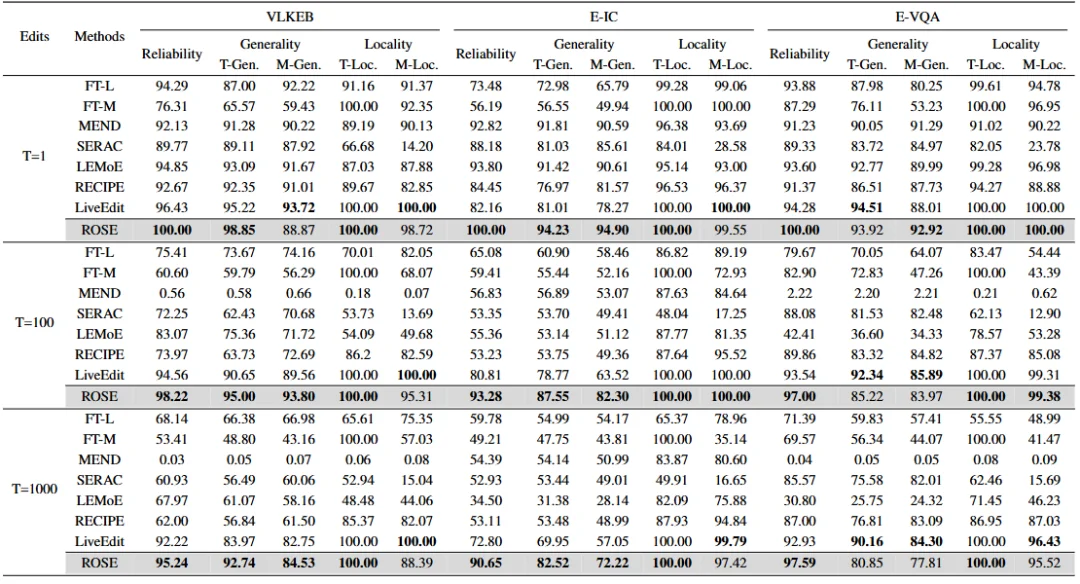
从结果中不难看出:
1. ROSE 有效缓解了灾难性遗忘。
如表所示,随着编辑次数增加,多数基线方法的可靠性明显下降。在 VLKEB 上完成 1000 次编辑后,FT-L 的可靠性降至 68.14%,而 ROSE 仍达到 95.24%。从 1 次编辑增加到 1000 次,ROSE 仅下降 4.76 个百分点,FT-L 则下降 26.15 个百分点。这得益于风险引导的正交编辑机制:正交约束减少新旧编辑之间的方向冲突,动态风险掩码则限制参数更新范围,降低对预训练知识与能力的干扰。
2. 更好的知识泛化能力。
在 VLKEB 上,ROSE 在文本和多模态泛化方面均表现良好,且在 1000 次编辑后均优于最强基线 LiveEdit。其文本泛化达到 92.74%(LiveEdit 为 83.97%),多模态泛化达到 84.53%(LiveEdit 为 82.75%)。这得益于扰动引导的知识子空间融合机制,通过比较两个分支的特征差异,选择性融合变化显著的部分,同时保留其余原始表示。
3. 出色的局部性。
保留无关知识的完整性是许多编辑方法面临的难点。SERAC 在 VLKEB 上的多模态局部性降至 15.04%。相比之下,ROSE 的文本局部性达到 100%,多模态局部性达到 88.39%。这得益于从粗到细的知识整合策略。语义对齐门控引导无关查询绕过辅助分支,扰动引导的融合则针对相关输入进行细粒度修改,从而减少对其他事实知识的意外干扰。
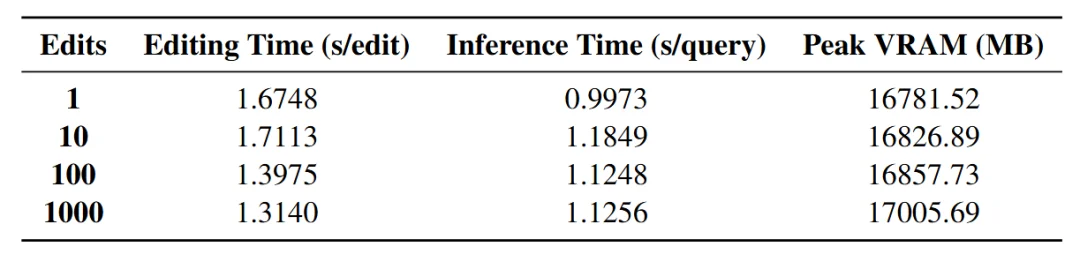
运行成本方面,在单张 RTX 4090 和 LLaVA-v1.5-7B 的测试配置下,1000 次编辑设置中的平均单次编辑耗时约 1.31 秒,每条查询推理约 1.13 秒,展示了一定的实用价值。
结语
ROSE 通过风险感知的正交编辑机制减少连续知识更新对已有知识的干扰,并借助多粒度知识整合策略按需调用编辑后的知识,降低局部性退化风险,从而在新知识学习与原有能力保持之间实现更好的平衡。实验结果进一步验证了该框架在多模态终身知识编辑任务中的有效性。
第一作者简介
宋凌云,西北工业大学计算机学院副教授,博士生导师,研究方向包括多模态大模型的强化微调、智能体技术、跨媒体认知与推理、计算机视觉等。发表 SCI 以及计算机领域高水平会议论文 60 余篇,申请国家级发明专利 20 余项和软件著作权多项。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner